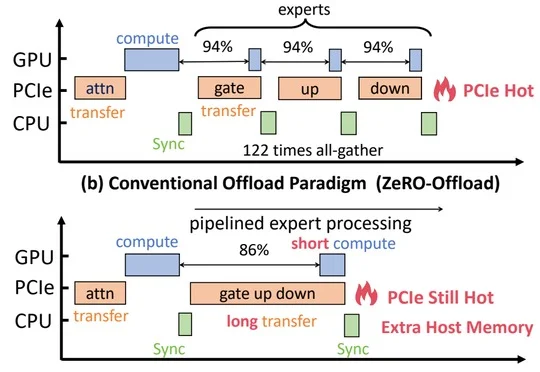
别再让计算等着搬权重了!KTransformers让CPU直接参与MoE微调计算
别再让计算等着搬权重了!KTransformers让CPU直接参与MoE微调计算清华大学MADSys实验室与趋境科技主导提出开源KTransformers-FineTune(KT-FT),让CPU直接参与MoE专家计算并优化布局与线程调度,使LoRA微调吞吐达到传统卸载范式的2.5~21.2倍。
来自主题: AI技术研报
9952 点击 2026-10-17 11:56

 搜索
清华大学MADSys实验室与趋境科技主导提出开源KTransformers-FineTune(KT-FT),让CPU直接参与MoE专家计算并优化布局与线程调度,使LoRA微调吞吐达到传统卸载范式的2.5~21.2倍。
微调超大参数模型,现在的“打开方式”已经大变样了: 仅需2-4 张消费级显卡(4090),就能在本地对DeepSeek 671B乃至Kimi K2 1TB这样的超大模型进行微调了。
2024年,落地,无疑是大模型最重要的主题。