ICRA 2025|通用多机器人长时任务规划框架破解任务分配难题,成功率+105%、效率+36%
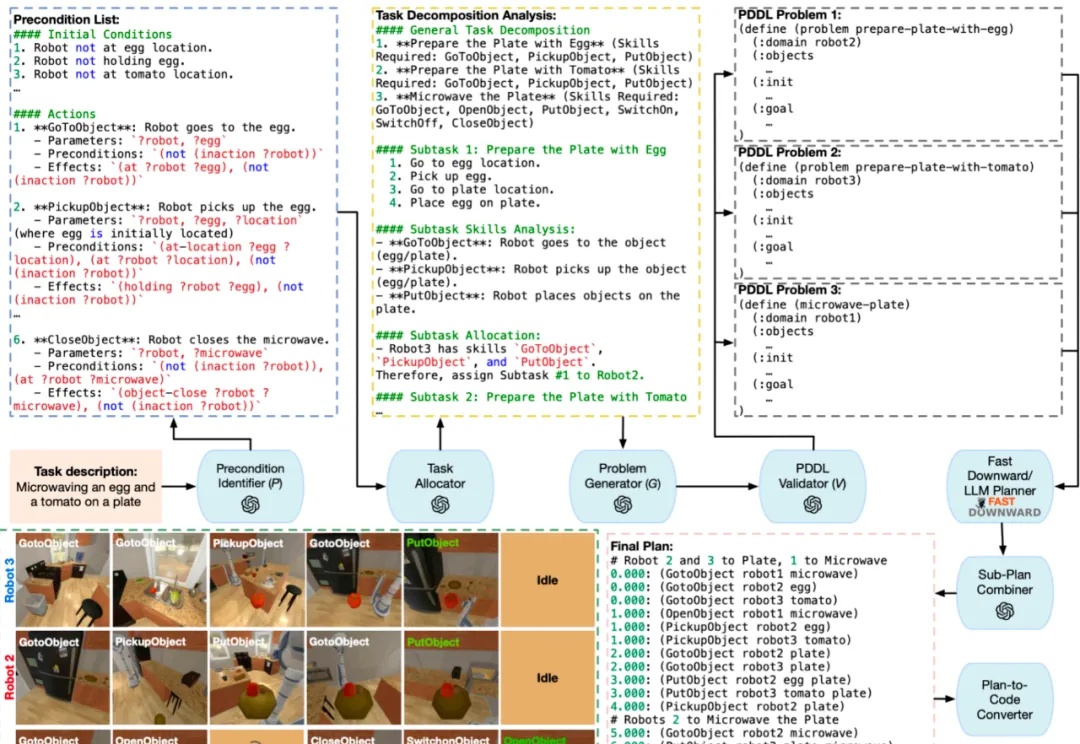
ICRA 2025|通用多机器人长时任务规划框架破解任务分配难题,成功率+105%、效率+36%2025 年 5 月,美国加州大学河滨分校 (UC Riverside) 与宾夕法尼亚州立大学 (Penn State University) 联合团队在机器人领域顶级会议 ICRA 2025 上发布最新研究成果 LaMMA-P。
搜索
2025 年 5 月,美国加州大学河滨分校 (UC Riverside) 与宾夕法尼亚州立大学 (Penn State University) 联合团队在机器人领域顶级会议 ICRA 2025 上发布最新研究成果 LaMMA-P。
这两天Lovart产品火出圈外,昨天大家都还在疯狂求码,
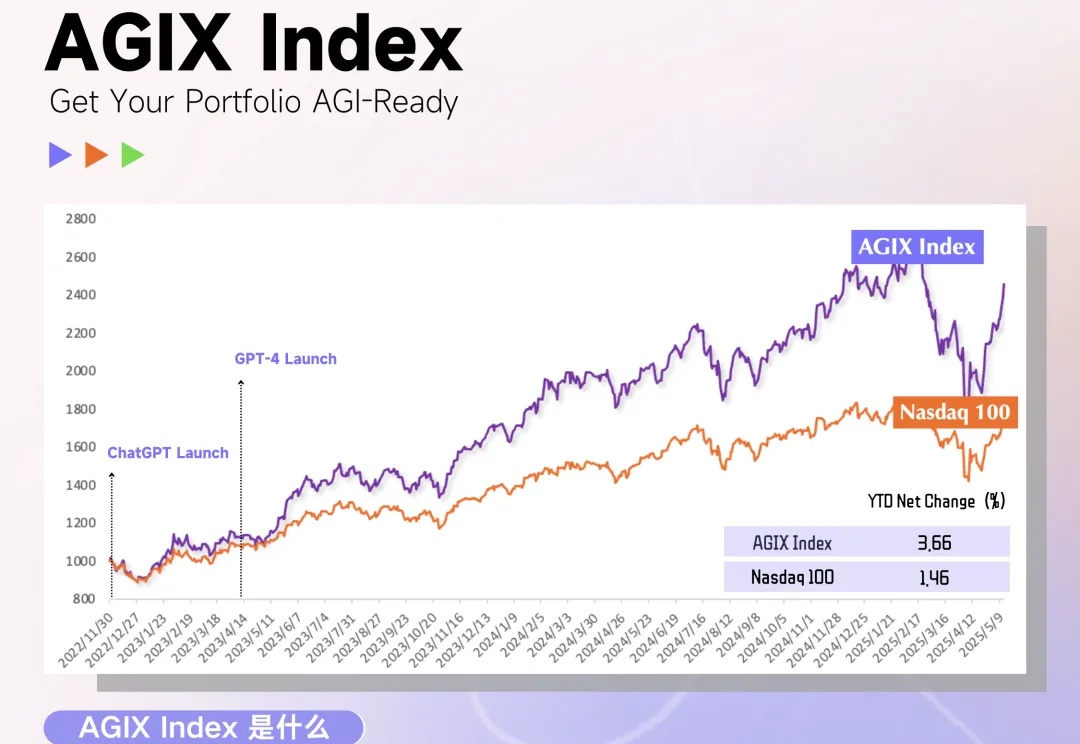
Something New :为了更好地沉淀 AI 时代的投资 insights,我们上线了 「AGI 投资手册」知识库(点击文末阅读原文链接查看),欢迎留下建议与 ideas,共建 AGI 时代的投资指南。也可以在评论区留言你认为最值得关注的 AI 股票,我们会为留言的朋友送出最新「 AGI 投资报告」 PDF。
Design is not just a task-it's an experience. 设计不仅仅是一项任务,更是一种体验。——LovartAI
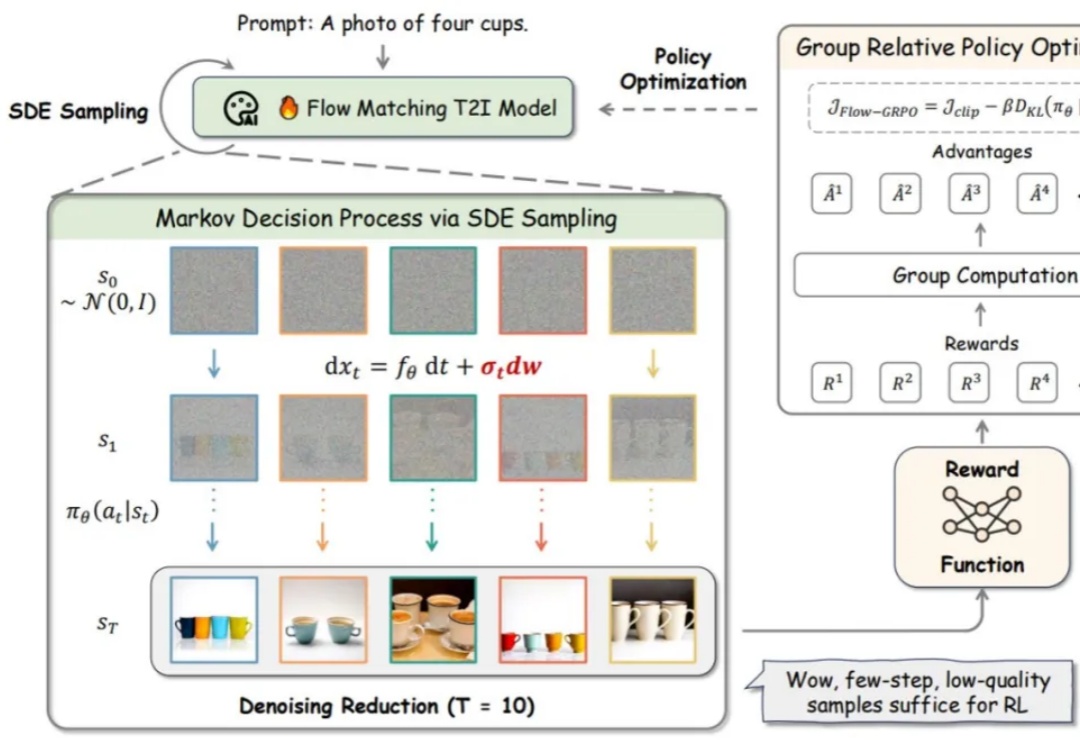
流匹配模型因其坚实的理论基础和在生成高质量图像方面的优异性能,已成为图像生成(Stable Diffusion, Flux)和视频生成(可灵,WanX,Hunyuan)领域最先进模型的训练方法。然而,这些最先进的模型在处理包含多个物体、属性与关系的复杂场景,以及文本渲染任务时仍存在较大困难。
近日,AI制药独角兽公司 insitro宣布,为了简化运营,公司裁员22%,将现金流延长到2027年。
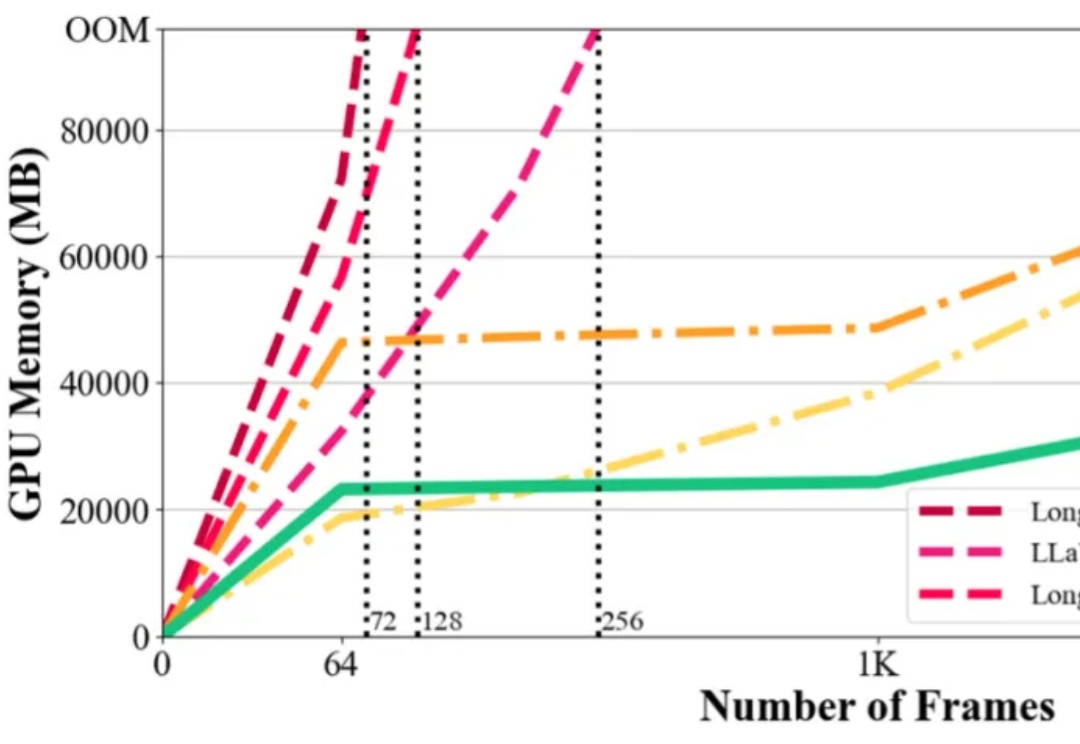
在视觉语言模型(Vision-Language Models,VLMs)取得突破性进展的当下,长视频理解的挑战显得愈发重要。以标准 24 帧率的标清视频为例,仅需数分钟即可产生逾百万的视觉 token,这已远超主流大语言模型 4K-128K 的上下文处理极限。
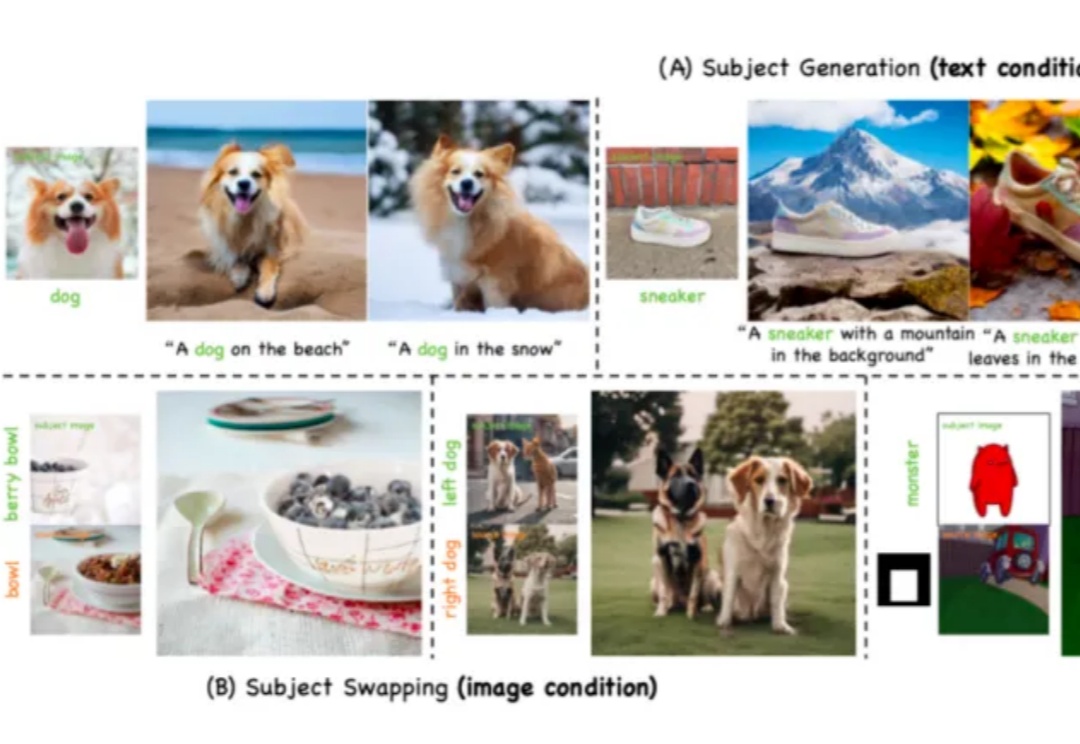
近年来,生成式人工智能(Generative AI)技术的突破性进展,特别是文本到图像 T2I 生成模型的快速发展,已经使 AI 系统能够根据用户输入的文本提示(prompt)生成高度逼真的图像。从早期的 DALL・E 到 Stable Diffusion、Midjourney 等模型,这一领域的技术迭代呈现出加速发展的态势。
Sora、可灵等视频生成模型令人惊艳的性能表现使得创作者仅依靠文本输入就能够创作出高质量的视频内容。然而,我们常见的电影片段通常是由导演在一个场景中精心布置多个目标的运动、摄像机拍摄角度后再剪辑而成的。例如,在拍摄赛车追逐的场景时,镜头通常跟随赛车运动,并通过扣人心弦的超车时刻来展示赛事的白热化。
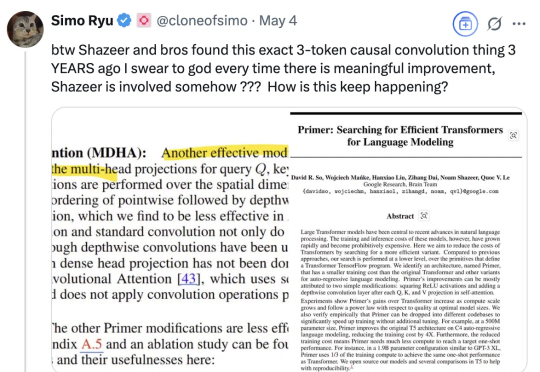
怎么老是你???(How old are you)尤其是最近Meta FAIR研究员朱泽园分享了他们《Physics of Language Models》项目的系列新进展后,有网友发现,其中提到的3-token因果卷积相关内容,沙哥等又早在三年前就有相关研究。这是最近网友不断对着Transformer八子之一的Noam Shazeer(为方便阅读,我们称他为沙哥)发出的灵魂疑问。