UniSteer用机械臂「拼豆」:让人类指导进入VLA噪声空间强化学习
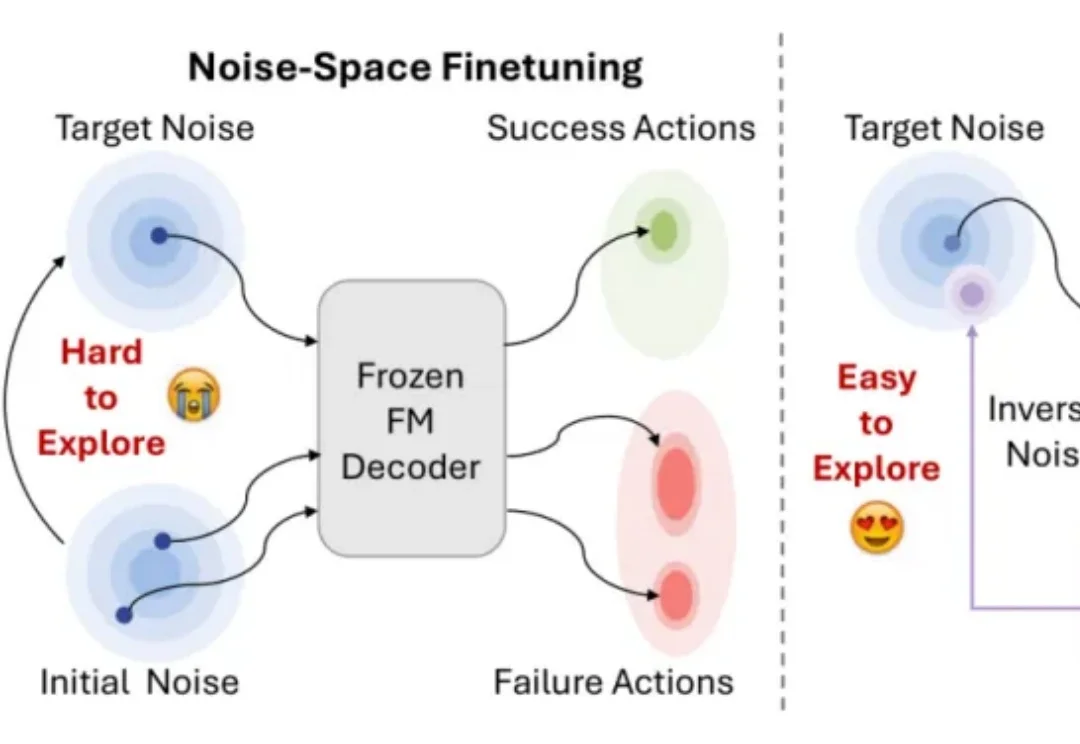
UniSteer用机械臂「拼豆」:让人类指导进入VLA噪声空间强化学习视觉 - 语言 - 动作模型(Vision-Language-Action Model,VLA)正在成为机器人操作的重要基础模型。经过少量示范微调后,VLA 已经能够完成抓取、放置、堆叠等多种任务。然而,一旦任务涉及精密接触、狭小容差或分布外位置,模型的成功率仍会明显下降。
搜索
视觉 - 语言 - 动作模型(Vision-Language-Action Model,VLA)正在成为机器人操作的重要基础模型。经过少量示范微调后,VLA 已经能够完成抓取、放置、堆叠等多种任务。然而,一旦任务涉及精密接触、狭小容差或分布外位置,模型的成功率仍会明显下降。
RSI,可能是 AI 世界里最像科幻的一个词。
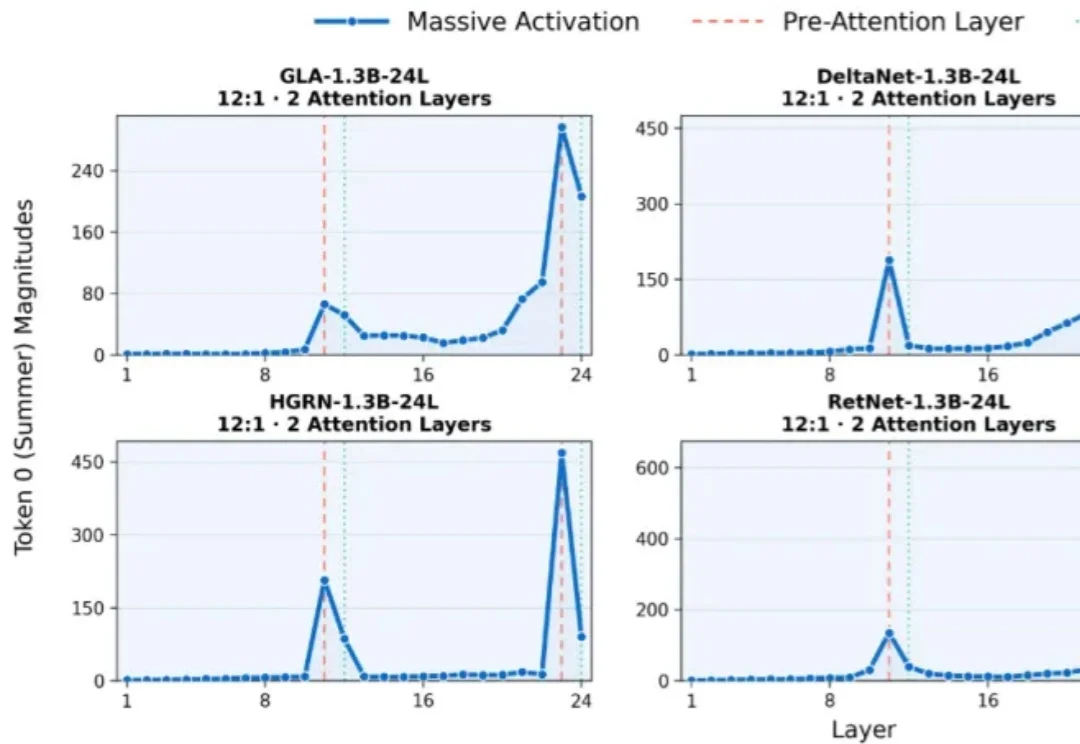
Full Attention 层尚未开始计算,它前一层的激活值已提前「冲上峰值」—— 这就像演唱会主角尚未登台,观众席已提前沸腾。来自 StartLux、清华大学等机构的研究者以 Massive Activations 为探针,首次系统刻画了少数 Full Attention 层在混合线性注意力大模型中留下的「跨层痕迹」,并识别出「注意力前尖峰」(PAS)与「尖峰间平台」(ISP)两种核心形态。
FUMO Lab正式发布Fusion Model,在推理、行业、编程、科学四项顶尖公开测试集上全部位列第一,通过动态分配异构模型能力的智能分配机制,可在保持任务质量的同时将成本降低约30%–40%。
如果说大语言模型拉开了本轮人工智能革命的序幕,那么今天人机交互的瓶颈,早已不再是模型的智商,而是人类接收信息的生理带宽。
DeepSeek-V4-Flash-Vision-Exp多模态模型正式开源,该模型为DeepSeek-V4系列首个实验性多模态模型,基于DeepSeek-V4-Flash架构集成视觉模块,在真实世界软件工程测试DeepSWE中以59.3%反超Opus-4.8登顶,并在零样本视觉推理测试ZeroBench中击败Opus-4.8。
面向Agent Harness层自进化方向,CREAO AI近日完成千万级美元新融资,资金将用于扩大真实业务工作流与高质量反馈数据规模,加速基于开源模型后训练的垂直模型迭代。
remove-ai-watermarks是支持一条命令去除AI生成图片明水印和C2PA文件信息层暗水印的开源工具,覆盖Nano Banana、豆包、即梦等多种水印,像素层SynthID暗水印需借助NVIDIA显卡跑invisible命令重绘去除。
Lovart正式开启中国区运营并同步上线新版本,主打"Just Design"理念,新增灵感采集插件、100个专业Skill工作流及一键转矢量等功能,支持图片、视频、动效、可交互HTML及PPT等多种格式输出。
寒序科技正式公布uHBM®与uLPU™推理计算架构,首次完整亮相其基于Persistent MRAM的权重驻留片内计算方案。