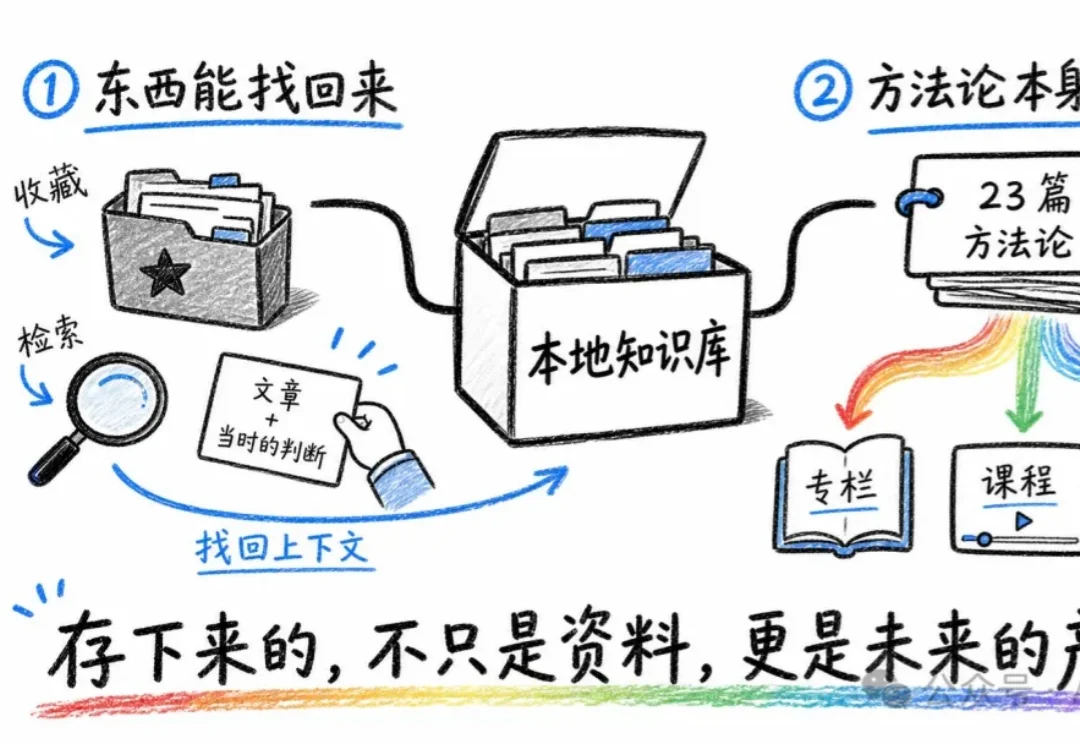
Codex + Obsidian 搭本地知识库:273 篇笔记 27 天实录
Codex + Obsidian 搭本地知识库:273 篇笔记 27 天实录7 月初的时候,我照着 Karpathy 那套 LLM Wiki(简单说就是让 AI 帮你把资料编译成一个能长大的百科)搭了个本地知识库。
来自主题: AI技术研报
7407 点击 2026-08-03 15:53

 搜索
7 月初的时候,我照着 Karpathy 那套 LLM Wiki(简单说就是让 AI 帮你把资料编译成一个能长大的百科)搭了个本地知识库。
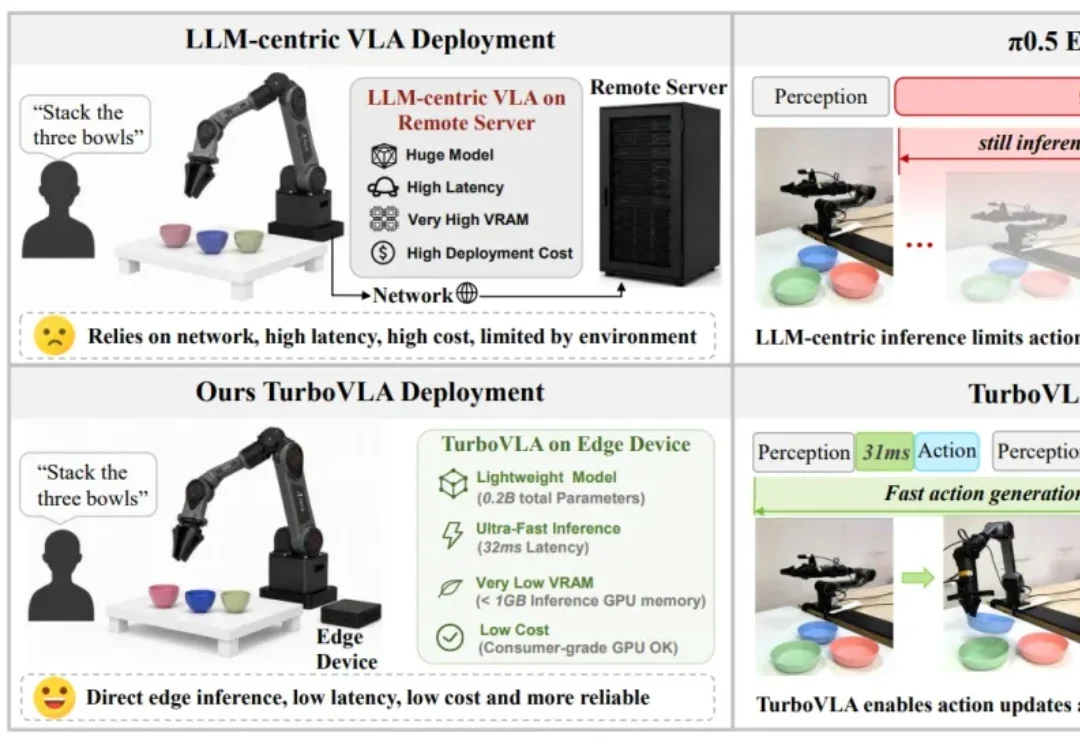
近年来,视觉 — 语言 — 动作模型(Vision-Language-Action Model,VLA)正逐渐成为通用机器人控制的重要技术路线,但当这些模型真正进入高频闭环执行时,一个矛盾越来越突出:模型越来越大、语义能力越来越强,动作更新却未必足够快。
又一家AI初创公司加入了这场狂飙突进的独角兽俱乐部:Simile。据该初创公司透露,就在结束隐身状态、宣布完成由Index Ventures领投的1亿美元A轮融资仅仅五个月后,公司已完成2亿美元B轮融资,估值达到20亿美元。
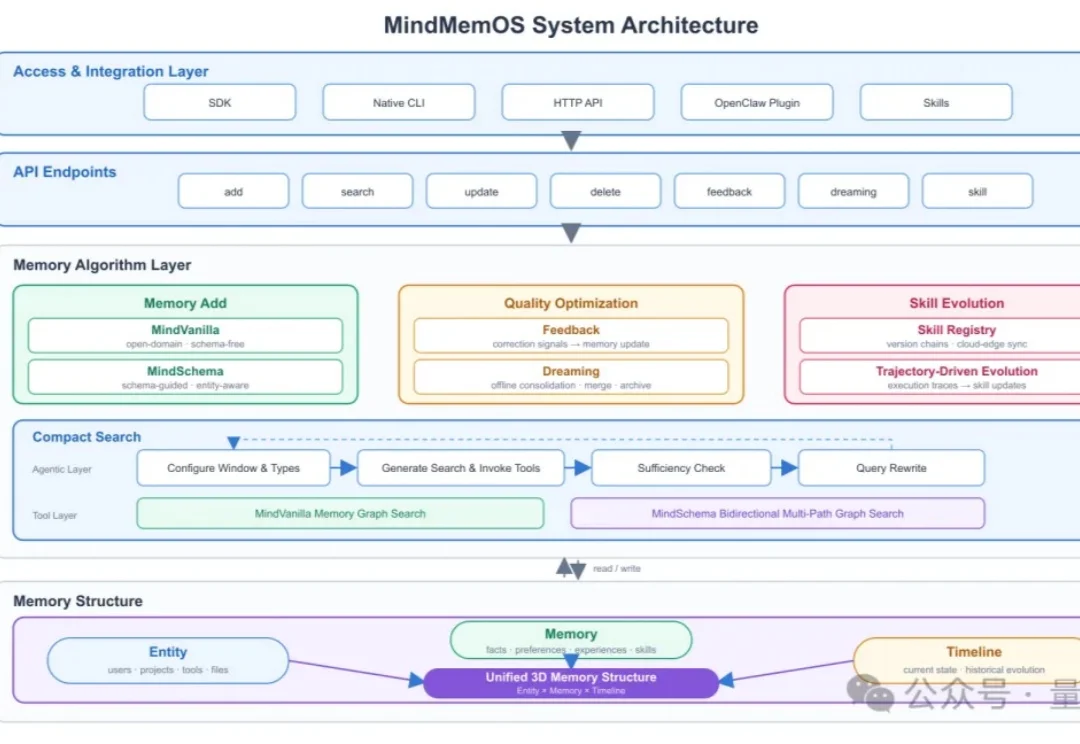
Agent的能力越来越强,但使用体验仍有一个尴尬之处: 每换一个Agent甚至换一个session,就像换了一个完全不了解你的新员工。
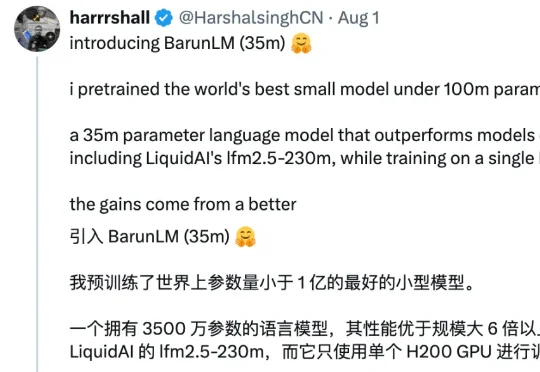
近日,独立开发者 Harshal Singh 公布了一个仅有 3500 万参数的基础语言模型 BarunLM,并声称:「我预训练了世界上参数量小于 100M 的最好模型」。
2025 年秋天,Meta 上线了一名可以替商家卖货的“AI 员工”。商家不需要重新整理一套资料,它会直接读取品牌过去发布的社交媒体内容、广告、商品目录和网站信息,自动学会这家公司卖什么、用什么语气和顾客说话。
新智元报道 2026年,AI行业最昂贵的新故事,已经不只是「训练一个更大的模型」。 资本开始直接押注:让AI参与制造下一代AI。 4月,AlphaGo核心缔造者David Silver创办的 Inef
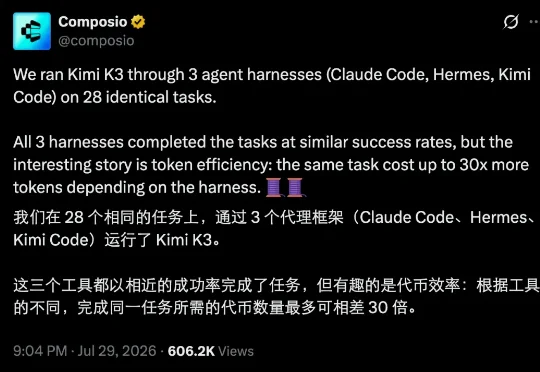
最近有个挺有意思的对比实验,来自 Composio 团队。他们用同一个模型 Kimi K3,分别放进三个不同的 agent 框架(harness)里跑 ——Claude Code、Hermes 和 Kimi Code—— 一共测了 28 个完全相同的任务。
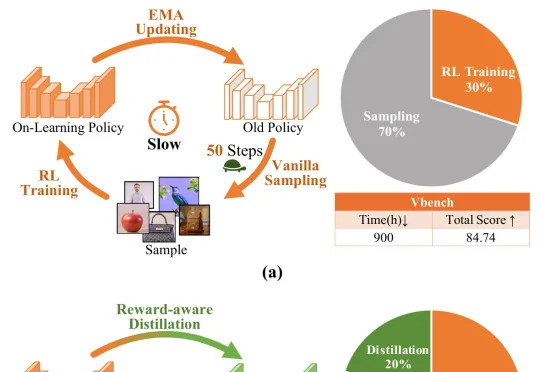
过去的 Diffusion RL 多聚焦于奖励设计与优化算法,训练时的采样成本被忽视。DMSampler 指出:在在线 RL 中,限制规模化的不只是奖励信号或优化器,很多时候是 rollout 本身太贵。
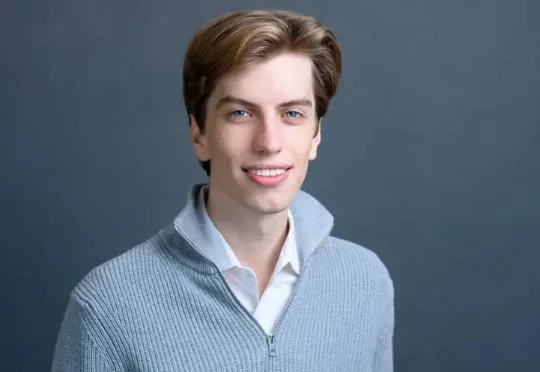
今天,全网都被这位25岁「AI先知」的故事刷屏了。 就在刚刚,华尔街上演了一场教科书级别的平仓。这场血雨腥风的主角,是被硅谷奉为「AI预言家」的Leopold Aschenbrenner,以及他那只439%逆天回报率的对冲基金——Situational Awareness(情境感知)。