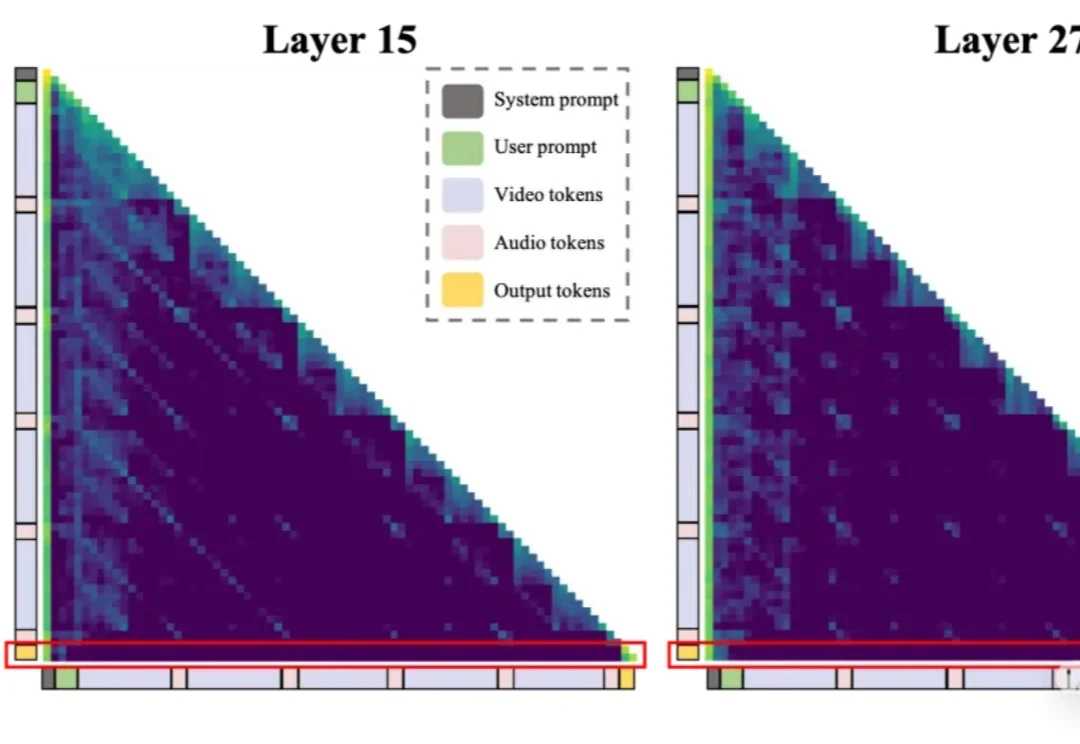
仅保留35% Token,性能反超原模型!快手可灵等用视觉信息引导音频压缩,推理时间直降42%
仅保留35% Token,性能反超原模型!快手可灵等用视觉信息引导音频压缩,推理时间直降42%一段几十秒的音视频,上万Token,一半以上是冗余——Omni-LLM的计算浪费,比想象中更严重。
来自主题: AI技术研报
10300 点击 2026-03-11 15:06

 搜索
一段几十秒的音视频,上万Token,一半以上是冗余——Omni-LLM的计算浪费,比想象中更严重。
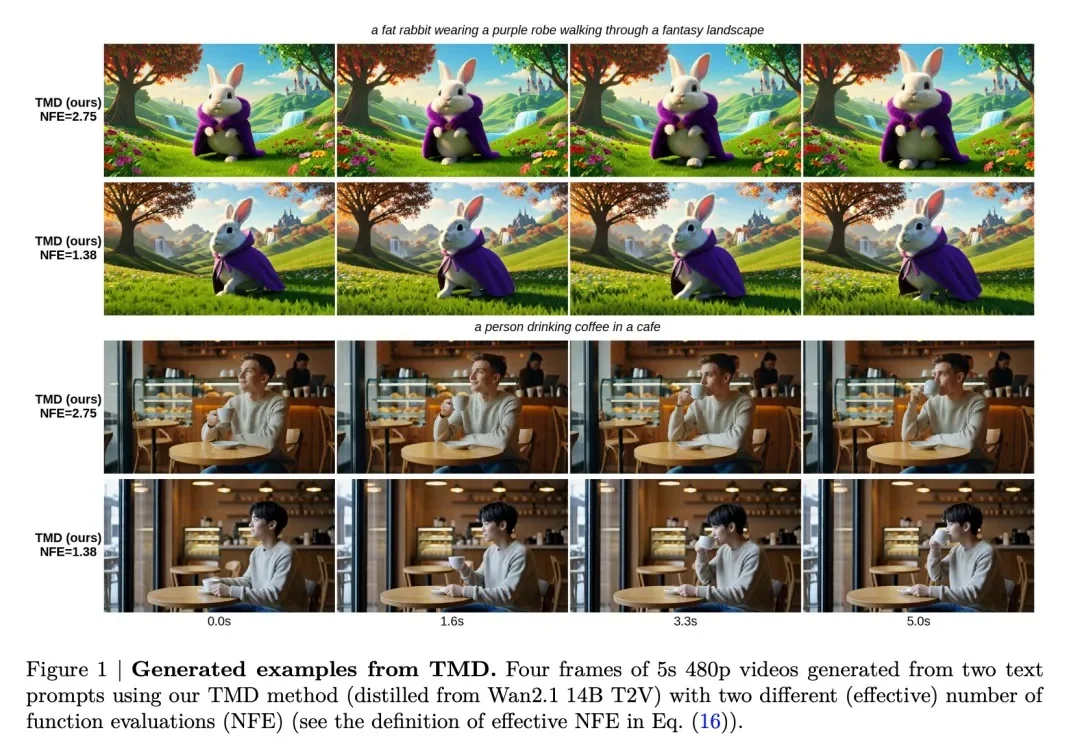
近年来,大规模视频扩散模型在视频生成领域取得了显著进展。然而,采样效率低下仍然是这类模型的核心瓶颈。

具身智能的胜负手,可能并不在机器人本身。
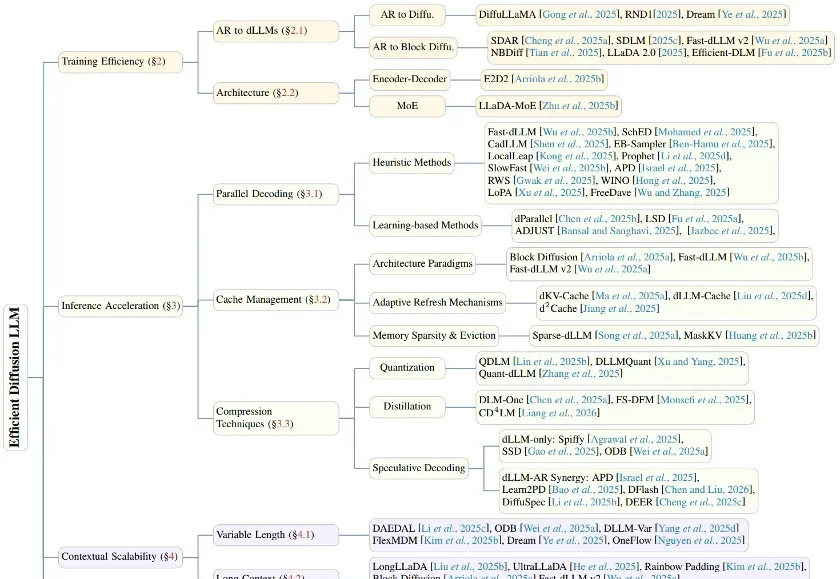
在生成式 AI 的浪潮中,自回归(Autoregressive, AR)模型凭借其卓越的性能占据了统治地位。然而,其「从左到右」逐个预测 Token 的串行机制,天生限制了并行生成的可能性。
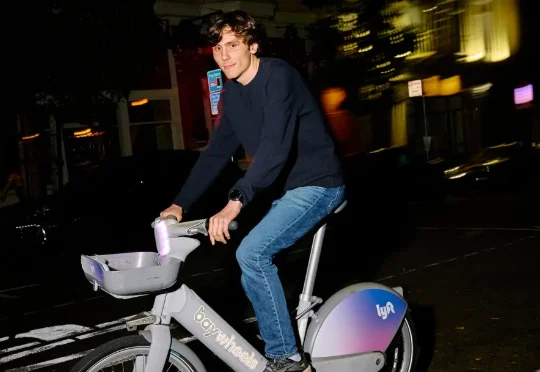
这位年仅 24 岁的哥们叫 Riley Walz,被《连线》和《纽约时报》等媒体冠以「硅谷小丑(Jester of Silicon Valley)」称号。别人写代码是为了改变世界,他写代码纯粹是为了给现实世界找点乐子。
随着OpenClaw的爆火,全球用户在AI Agent上消耗的Token量整整暴涨了1000倍!这不是一次普通的开源项目走红,这是一个信号——一个比编程奇点更加剧烈的奇点,正在撕裂我们习以为常的世界。
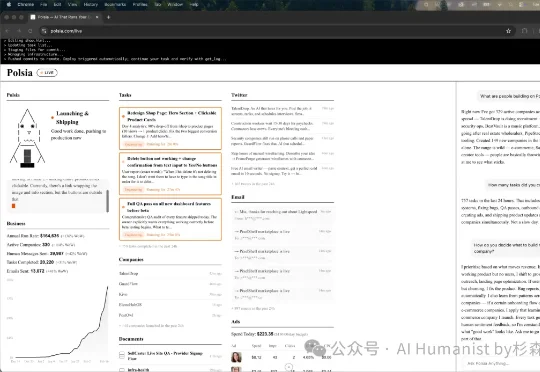
一个叫 Polsia 的 AI 产品,号称可以完全自主运营一家公司。对,你没看错。一个 AI,自己运营一整家公司。一位创始人,0 员工,数千个 AI Agent 全天候跑着。年收入从 10 万美元,两周内干到了 100 万美元。
3月6日,腾讯混元发布了一篇名为“HY-WU (Part I): An Extensible Functional Neural Memory Framework and An Instantiation in Text-Guided Image Editing”的技术报告。提出了一种崭新的功能性记忆(functional neural memory)范式(weight unleashing),
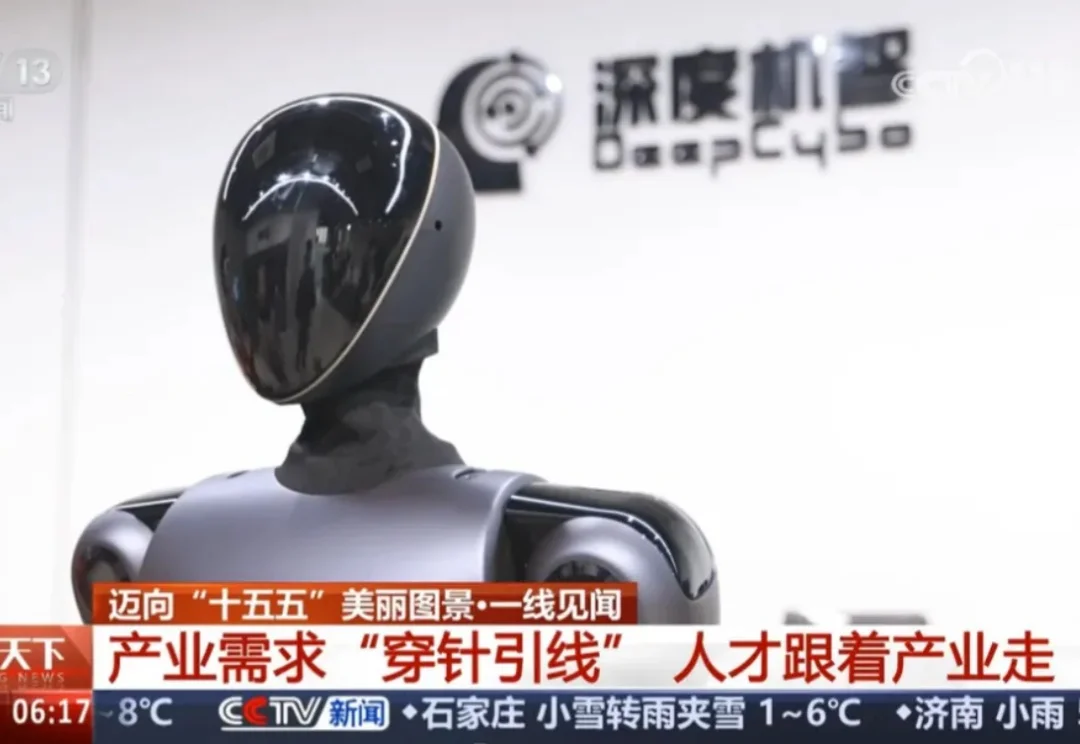
导读:近日,位于中关村的深度机智全球首次使用全新范式——人类学习,在多个国际 Benchmark 上取得 SOTA,史无前例地使用全新架构(仅使用人类第一视角数据、零真机数据)击败 Physical Intelligence 和英伟达等头部巨头二十多个百分点,并在两会开幕首日被央视报道。
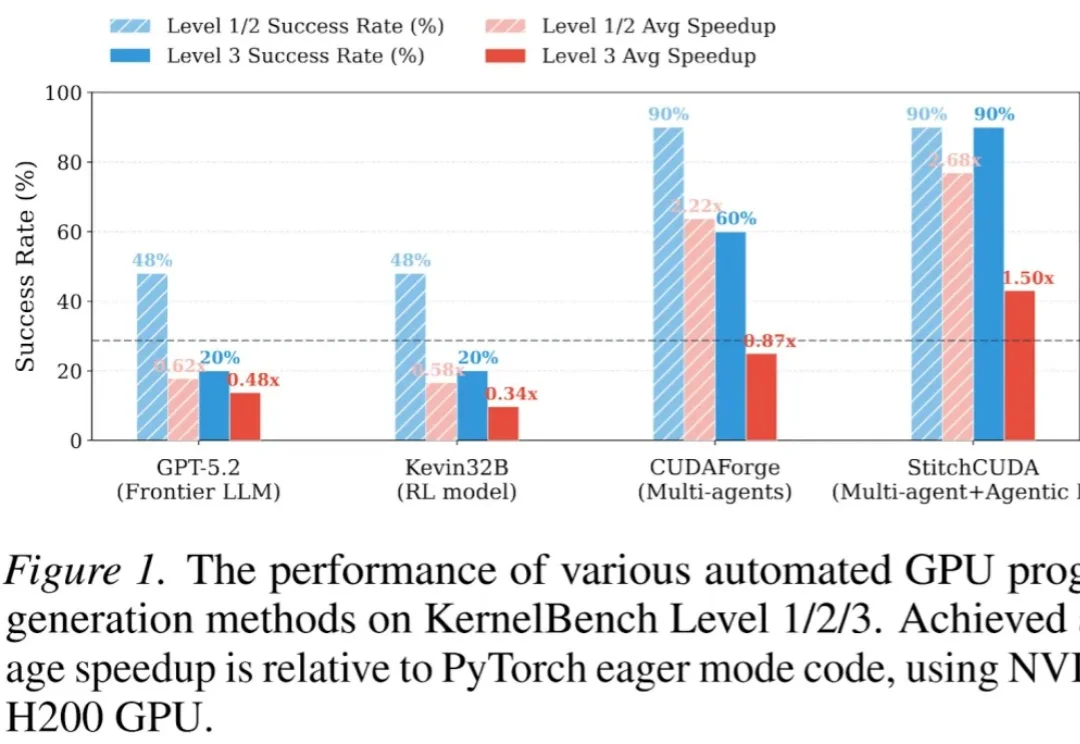
现有的 LLM 自动化 CUDA 方法大多只能优化单个 Kernel,面对完整的端到端 GPU 程序(如整个 VisionTransformer 推理)往往束手无策。