NeurIPS 2025 Spotlight | NYU提出QSVD,仅数学压缩让模型更轻、更快、更稳
NeurIPS 2025 Spotlight | NYU提出QSVD,仅数学压缩让模型更轻、更快、更稳在多模态智能浪潮中,视觉语言模型(Vision-Language Models, VLM)已成为连接视觉理解与语言生成的核心引擎。从图像描述、视觉问答到 AI 教育和交互系统,它们让机器能够「看懂世界、说人话」。
搜索
在多模态智能浪潮中,视觉语言模型(Vision-Language Models, VLM)已成为连接视觉理解与语言生成的核心引擎。从图像描述、视觉问答到 AI 教育和交互系统,它们让机器能够「看懂世界、说人话」。
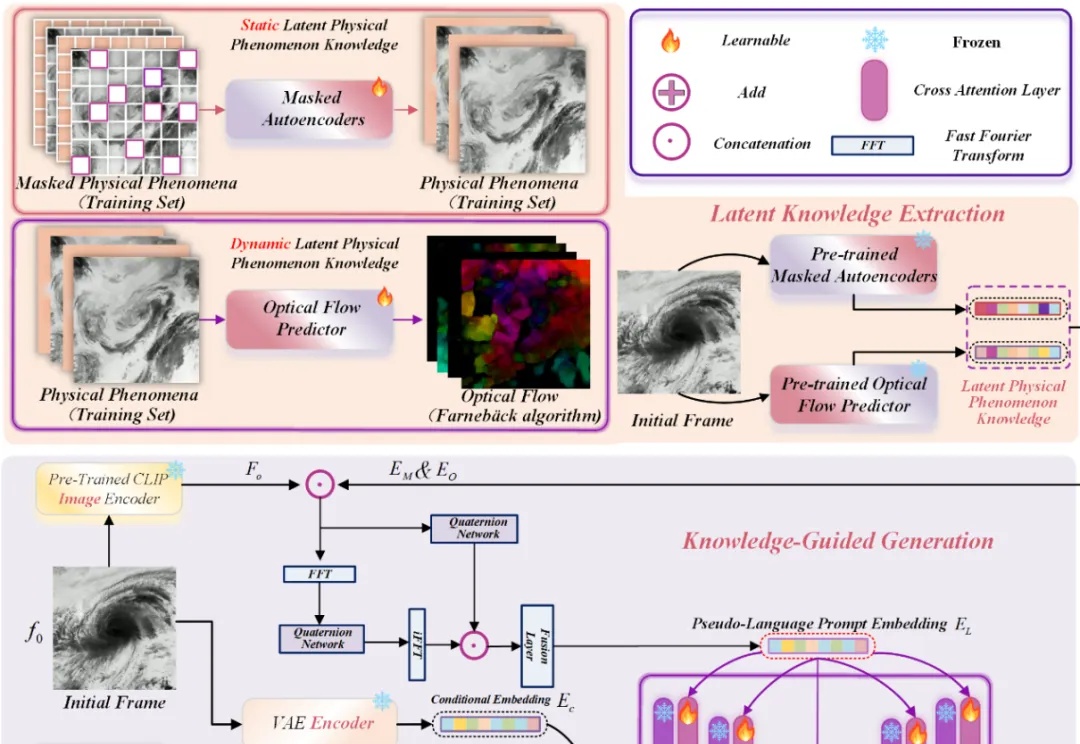
近年来,Stable Diffusion、CogVideoX 等视频生成模型在自然场景中表现惊艳,但面对科学现象 —— 如流体模拟或气象过程 —— 却常常 “乱画”:如下视频所示,生成的流体很容易产生违背物理直觉的现象,比如气旋逆向旋转或整体平移等等。
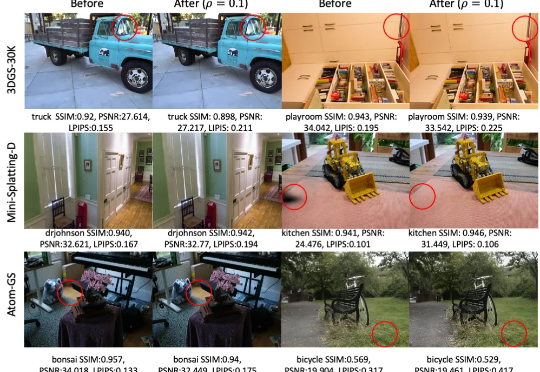
在三维视觉领域,3D Gaussian Splatting (3DGS) 是近年来大热的三维场景建模方法。它通过成千上万的高斯球在空间中“泼洒”,拼合成一个高质量的三维世界,就像是把一片空白的舞台,用彩色的光斑和粒子逐渐铺满,最后呈现出一幅立体的画卷。
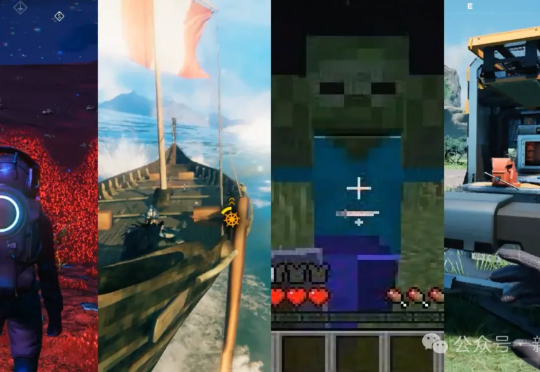
如果一个AI,像人类一样看屏幕、敲键鼠、自己练级变强,这种游戏搭子,你愿意拥有吗?可能不久将来,类似王者荣耀、DOTA 2这样的游戏就可以选择和AI组队,而不是和人组队了!
一篇入围顶会NeurIPS’25 Oral的论文,狠狠反击了一把DiT(Diffusion Transformer)。这篇来自字节跳动商业化技术团队的论文,则是提出了一个名叫InfinityStar的方法,一举兼得了视频生成的质量和效率,为视频生成方法探索更多可能的路径。
谷歌在第三天发布了《上下文工程:会话与记忆》(Context Engineering: Sessions & Memory) 白皮书。文中开篇指出,LLM模型本身是无状态的 (stateless)。如果要构建有状态的(stateful)和个性化的 AI,关键在于上下文工程。
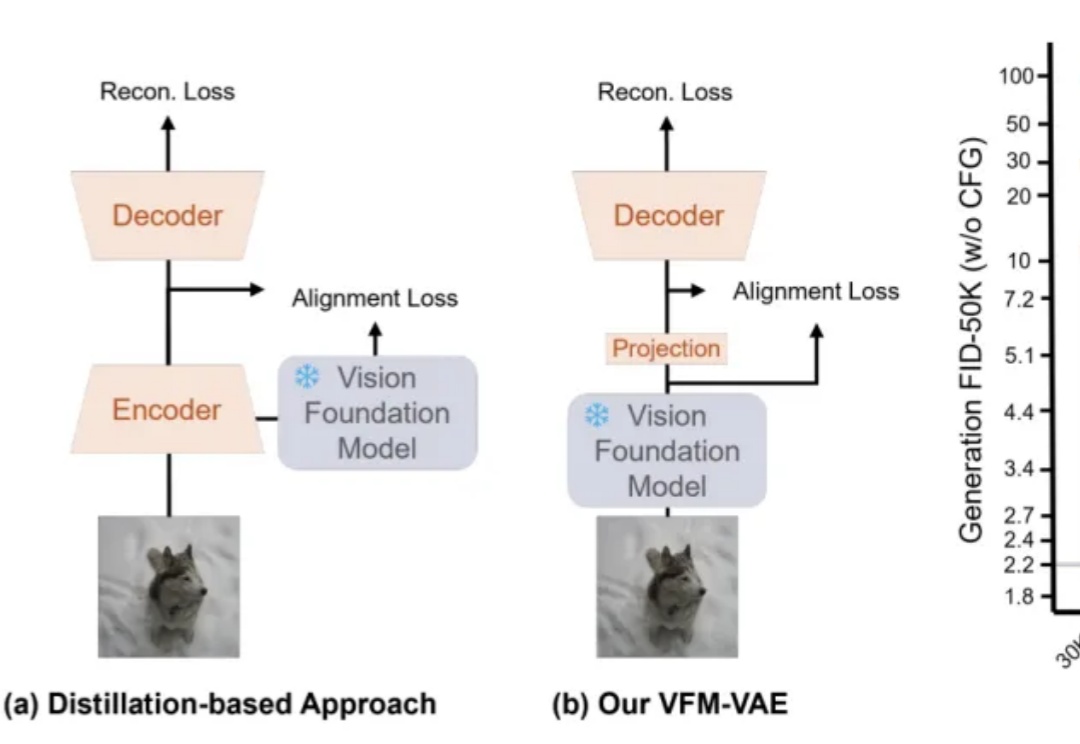
近期,RAE(Diffusion Transformers with Representation Autoencoders)提出以「 冻结的预训练视觉表征」直接作为潜空间,以显著提升扩散模型的生成性能。
是否有哪个AI产品,让你觉得——它已经深入我们某个核心生活或工作场景,并让我们完全离不开?
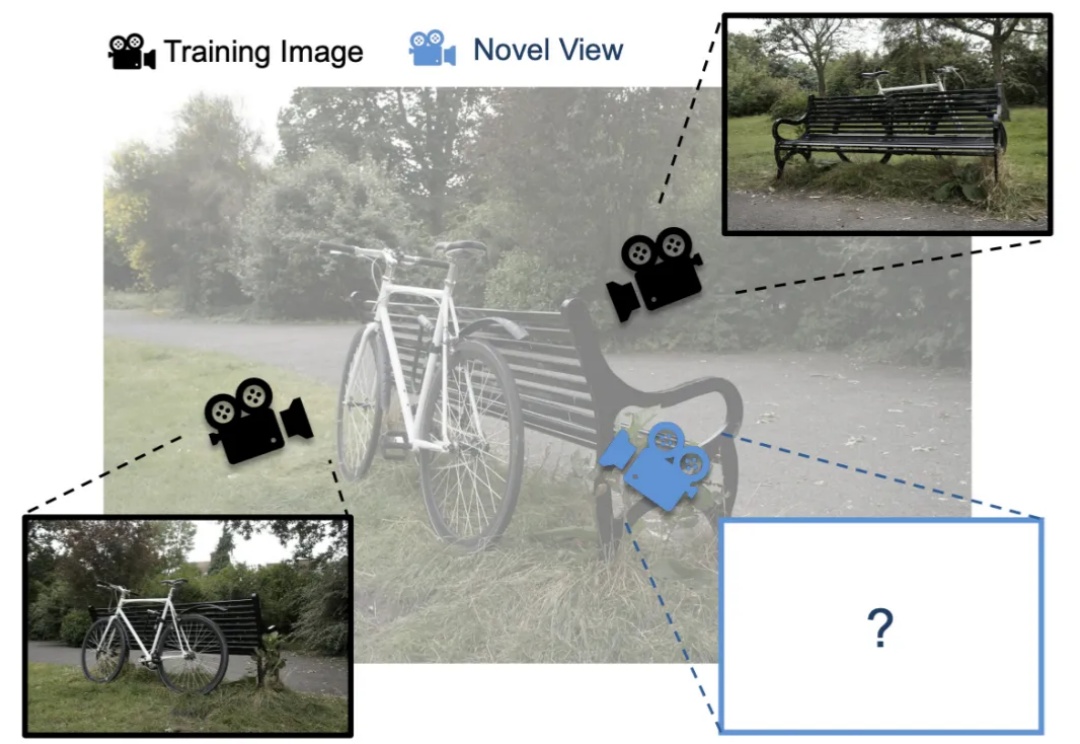
3D Gaussian Splatting (3DGS) 是一种日益流行的新视角合成方法,给定 3D 场景的一组带位姿的图像(即带有位置和方向的图像),3DGS 会迭代训练一个场景表示,该表示由大量各向异性 3D 高斯体组成,用以捕捉场景的外观和几何形状。
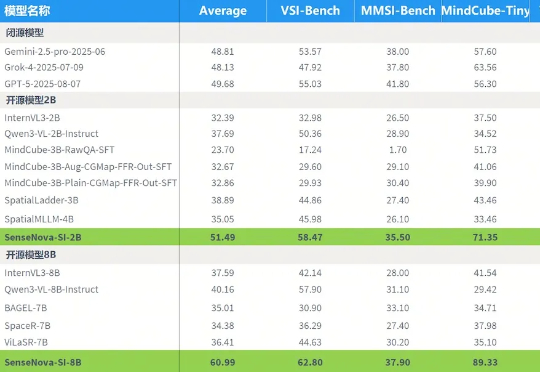
昨晚,商汤正式发布并开源SenseNova-SI系列空间智能大模型,涵盖2B与8B两个版本。该系列模型在多个空间智能基准测试中均表现突出,其中SenseNova-SI-8B模型在VSI-Bench、MMSI-Bench、MindCube-Tiny与ViewSpatial四个核心任务上获得60.99的平均成绩