AI资讯新闻榜单内容搜索-STILL

AITNT-国内领先的一站式人工智能新闻资讯网站
# 热门搜索 #
搜索: STILL
GLM-5 技术报告全解读|a16z:“最好的开源模型”

GLM-5 技术报告全解读|a16z:“最好的开源模型”

GLM-5 技术报告全解读|a16z:“最好的开源模型”

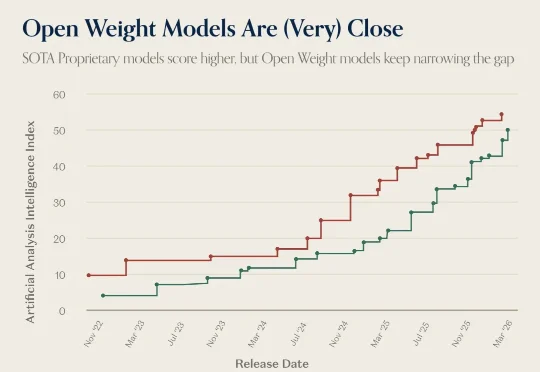
a16z 昨天发了一张图,把 GLM-5 和 Claude Opus 4.6 并排标注在 Artificial Analysis Intelligence Index 的时间线上。原文的说法是: A proprietary model (Claude Opus 4.6) is still the 'most intelligent,' but the gap between

来自主题: AI技术研报
14999 点击    2026-02-22 23:06
2026开年关键词:Self-Distillation,大模型真正走向「持续学习」

2026开年关键词:Self-Distillation,大模型真正走向「持续学习」

2026开年关键词:Self-Distillation,大模型真正走向「持续学习」

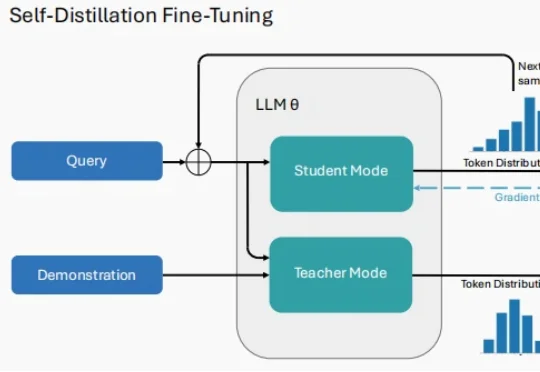
2026 年刚拉开序幕,大模型(LLM)领域的研究者们似乎达成了一种默契。 当你翻开最近 arXiv 上最受关注的几篇论文,会发现一个高频出现的词汇:Self-Distillation。

来自主题: AI技术研报
7882 点击    2026-02-10 14:17
两个95后华人,搞出硬件版Clawdbot,售价1700元

两个95后华人,搞出硬件版Clawdbot,售价1700元

两个95后华人,搞出硬件版Clawdbot,售价1700元

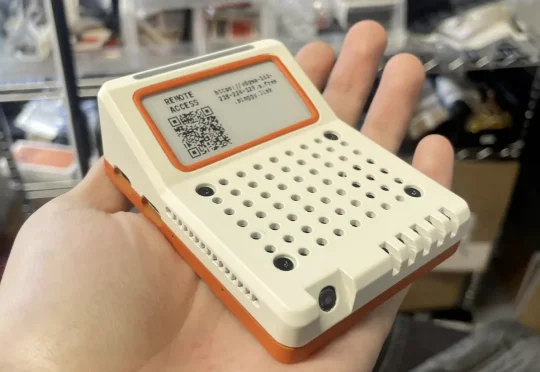
最近硅谷的一个本地Agent项目也很有关注度,而且是软硬件打包好,买回来就能直接用的那种。长这样子,卖250美元(折合人民币约1700元),买来插上电就能当OpenClaw用。

来自主题: AI资讯
10617 点击    2026-02-01 16:19
当AI重新定义「科研影响力」:一场关于CSRankings的反思与重塑

当AI重新定义「科研影响力」:一场关于CSRankings的反思与重塑

当AI重新定义「科研影响力」:一场关于CSRankings的反思与重塑

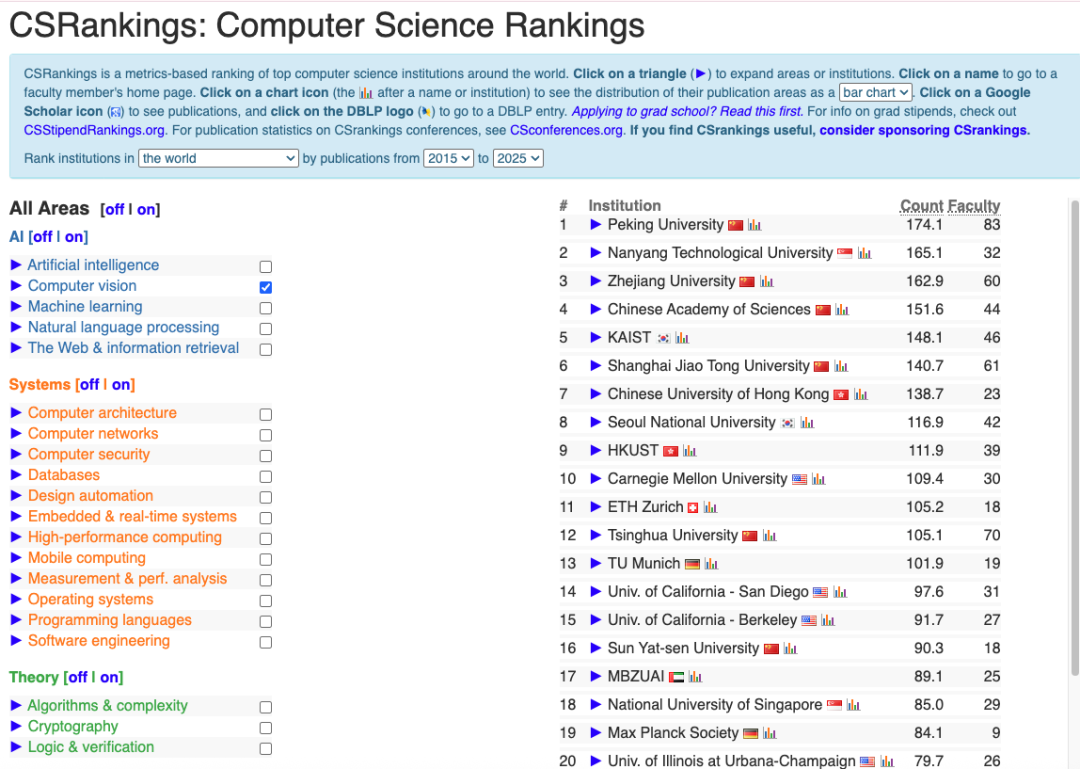
在计算机科学领域, CSRankings 曾被视为一次划时代的改进。它摒弃了早期诸如 USNews 那样依赖调查问卷的主观排名体系,转而以论文发表数量这一客观指标来评估各大学的科研实力。

来自主题: AI资讯
8932 点击    2025-11-15 17:08
NeurIPS 2025 Spotlight | 选择性知识蒸馏精准过滤:推测解码加速器AdaSPEC来了

NeurIPS 2025 Spotlight | 选择性知识蒸馏精准过滤:推测解码加速器AdaSPEC来了

NeurIPS 2025 Spotlight | 选择性知识蒸馏精准过滤:推测解码加速器AdaSPEC来了

目前,最先进的对齐方法是使用知识蒸馏(Knowledge Distillation, KD)在所有 token 上最小化 KL 散度。然而,最小化全局 KL 散度并不意味着 token 的接受率最大化。由于小模型容量受限,草稿模型往往难以完整吸收目标模型的知识,导致直接使用蒸馏方法的性能提升受限。在极限场景下,草稿模型和目标模型的巨大尺寸差异甚至可能导致训练不收敛。

来自主题: AI技术研报
9873 点击    2025-11-07 14:57
只要强化学习1/10成本!翁荔的Thinking Machines盯上了Qwen的黑科技

只要强化学习1/10成本!翁荔的Thinking Machines盯上了Qwen的黑科技

只要强化学习1/10成本!翁荔的Thinking Machines盯上了Qwen的黑科技

今天要讲的On-Policy Distillation(同策略/在线策略蒸馏)。这是一个Thinking Machines整的新活,这个新策略既有强化学习等在线策略方法的相关性和可靠性;又具备离线策略(Off-policy)方法的数据效率。

来自主题: AI资讯
10570 点击    2025-10-29 11:12
刚刚,Thinking Machines Lab博客提出在策略蒸馏,Qwen被cue 38次

刚刚,Thinking Machines Lab博客提出在策略蒸馏,Qwen被cue 38次

刚刚,Thinking Machines Lab博客提出在策略蒸馏,Qwen被cue 38次

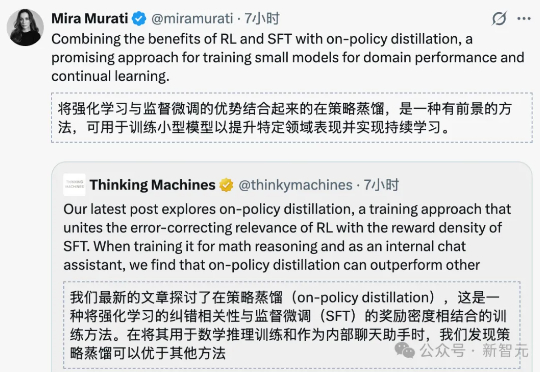
刚刚,不发论文、爱发博客的 Thinking Machines Lab (以下简称 TML)再次更新,发布了一篇题为《在策略蒸馏》的博客。在策略蒸馏(on-policy distillation)是一种将强化学习 (RL) 的纠错相关性与 SFT 的奖励密度相结合的训练方法。在将其用于数学推理和内部聊天助手时,TML 发现在策略蒸馏可以极低的成本超越其他方法。

来自主题: AI技术研报
9700 点击    2025-10-28 10:50
破解AI对不同上下⽂位置的敏感度不⼀致,新框架使出“解铃还须系铃人”

破解AI对不同上下⽂位置的敏感度不⼀致,新框架使出“解铃还须系铃人”

破解AI对不同上下⽂位置的敏感度不⼀致,新框架使出“解铃还须系铃人”

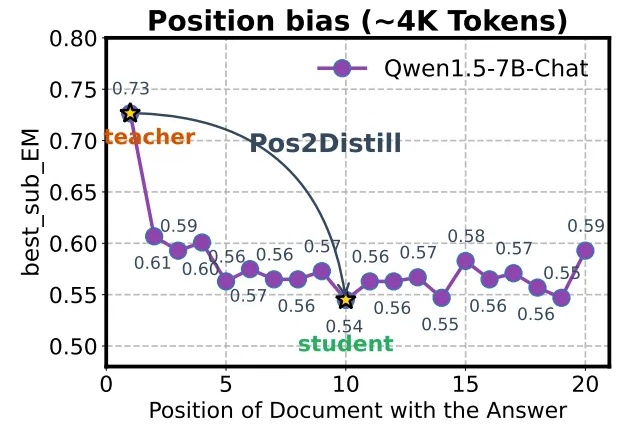
语言模型遭遇严重的位置偏见,即模型对不同上下⽂位置的敏感度不⼀致。模型倾向于过度关注输⼊序列中的特定位置,严重制约了它们在复杂推理、⻓⽂本理解以及模型评估等关键任务上的表现。

来自主题: AI技术研报
7207 点击    2025-10-27 10:33
Z Potentials|专访胡渊鸣,清华姚班 × MIT博士,打造500万+用户的3D AI平台Meshy,一年营收增长18x

Z Potentials|专访胡渊鸣,清华姚班 × MIT博士,打造500万+用户的3D AI平台Meshy,一年营收增长18x

Z Potentials|专访胡渊鸣,清华姚班 × MIT博士,打造500万+用户的3D AI平台Meshy,一年营收增长18x

生成式 AI 正在重写 3D 内容的生产流程:从“DCC 工具 + 外包”的线性供给,演进到“资产规模化生成 + 管线可用”的指数供给模式。过去五年,技术范式经历了从实时体积渲染,NeRF,到Score Distillation,3D扩散的快速迭代;需求侧则由游戏与影视,向3D 打印、电商样机、数字人、教育培训、以及AR/VR等长尾场景外溢。

来自主题: AI资讯
11593 点击    2025-10-21 16:30
微软BitDistill将LLM压缩到1.58比特:10倍内存节省、2.65倍CPU推理加速

微软BitDistill将LLM压缩到1.58比特:10倍内存节省、2.65倍CPU推理加速

微软BitDistill将LLM压缩到1.58比特:10倍内存节省、2.65倍CPU推理加速

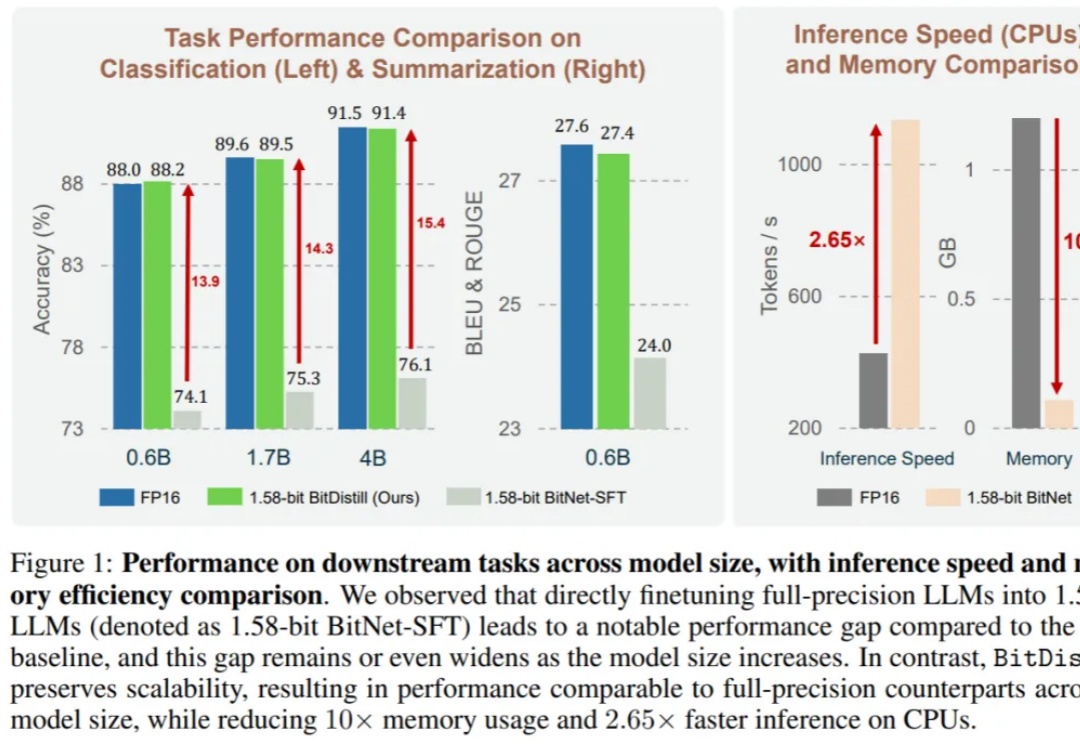
大语言模型(LLM)不仅在推动通用自然语言处理方面发挥了关键作用,更重要的是,它们已成为支撑多种下游应用如推荐、分类和检索的核心引擎。尽管 LLM 具有广泛的适用性,但在下游任务中高效部署仍面临重大挑战。

来自主题: AI技术研报
7954 点击    2025-10-21 11:43