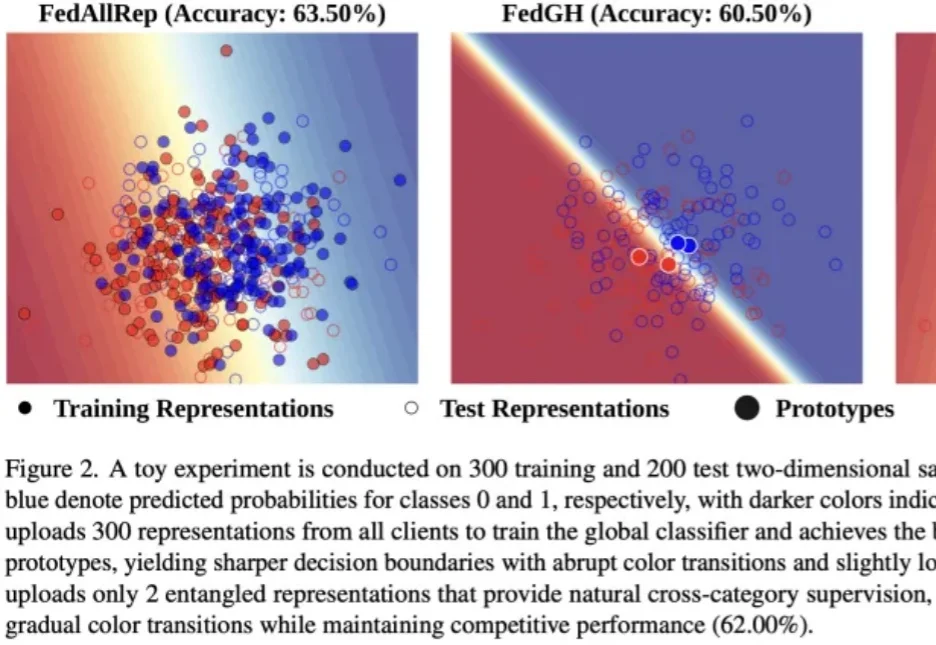
信通院&清华提出FedRE:用「纠缠」搞定联邦学习三难困境 | CVPR 26
信通院&清华提出FedRE:用「纠缠」搞定联邦学习三难困境 | CVPR 26在联邦学习中,如何同时兼顾模型性能、数据隐私和通信开销,是一个亟需解决的挑战。
来自主题: AI技术研报
11469 点击 2026-05-18 15:29

 搜索
在联邦学习中,如何同时兼顾模型性能、数据隐私和通信开销,是一个亟需解决的挑战。
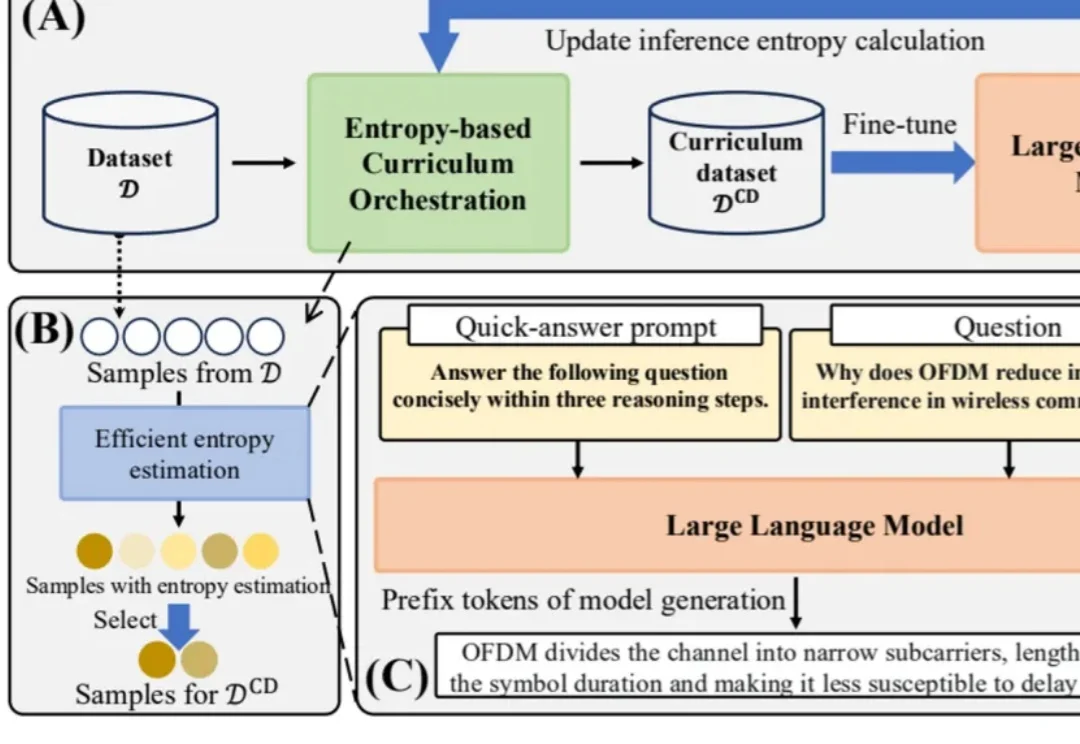
在大模型后训练中,数据不再只是 “越多越好”,而是要像人类学习一样,动态选择最合适难度的样本。华为提出的 EDCO 方法,将样本难度估计与动态课程编排引入领域大模型微调;数月后,由 Rutgers、Amazon、Google 等作者参与的 DARE 论文即引用 EDCO,并将其作为难度感知强化学习训练的重要对比基线。
近日,垂直于招投标领域的 AI 科技领军企业“深入云境”正式宣布:旗下核心产品 “云境标书AI” 成功入选 NVIDIA 初创加速计划(NVIDIA Inception)。这一里程碑式的进展,标志着云境标书AI在技术创新性、行业应用前景及商业潜力方面获得了全球顶级算力与AI生态巨头的权威认可。
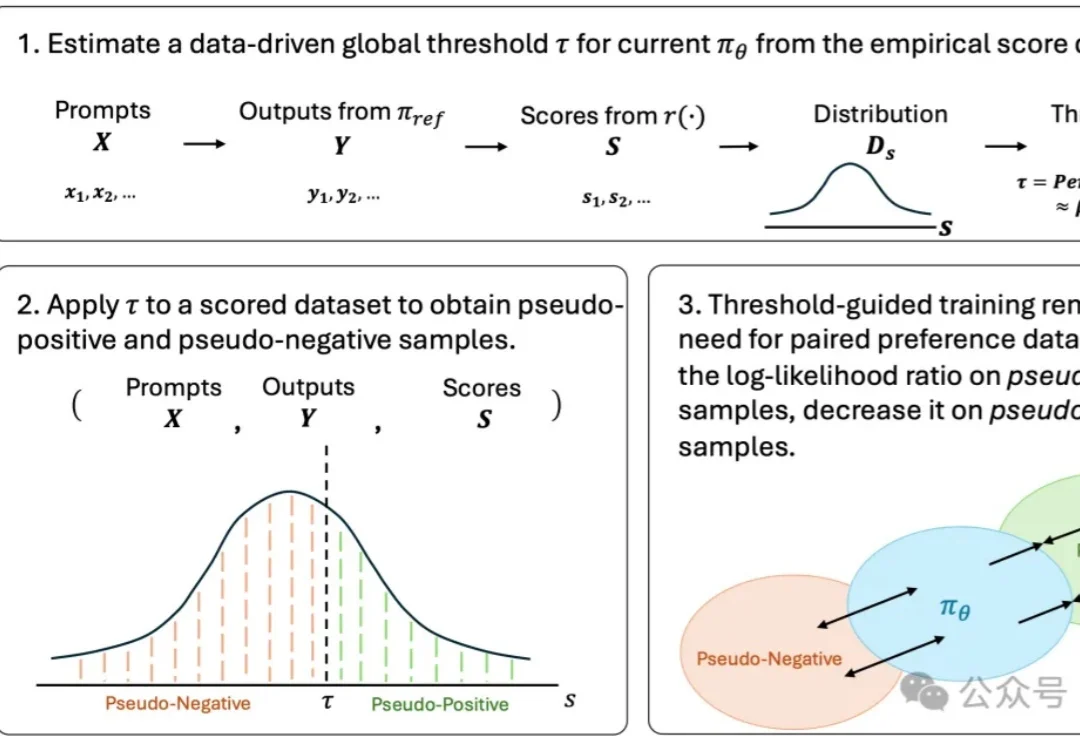
生成模型的偏好对齐,可能正在进入一个新的阶段。
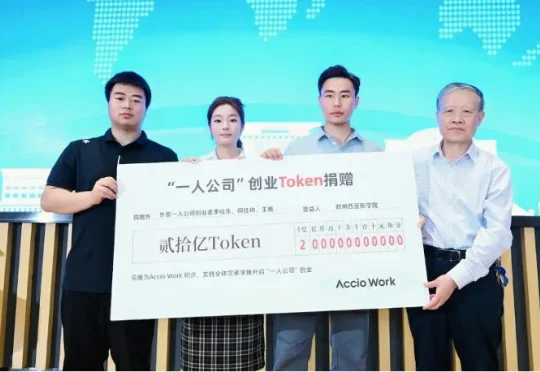
太有意思了,刚看到河南郑州西亚斯学院的消息。有几位 00 后创业者回母校干了件事,给学校捐了 20 亿 Token,希望带动学弟学妹做一人公司创业。郑州西亚斯学院是泡泡玛特老板王宁的母校,看来这学校真挺能出人才的。
近期,专为Diffusion模型设计的插件框架——Diffusion Templates正式开源发布。这个框架能大幅降低可控生成技术的训练和使用难度,让开发者能够通过丰富的Templates来精准控制模型的生成结果。
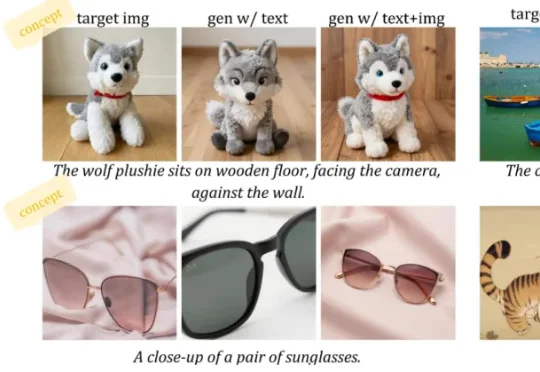
阿里巴巴 Z-Image 团队联合香港科技大学、加州大学圣地亚哥分校、香港中文大学等机构提出 D-OPSD(On-Policy Self-Distillation),首个针对少步扩散模型的在线策略自蒸馏框架。D-OPSD 无需奖励模型、无需成对偏好数据,
在过去很长的一段时间里,英伟达都被迫只能站在中间,一边是美国出口管制,一边是中国市场需求,老黄当然想找到一个突破口。也就是在同一天晚上,Anthropic发了一篇很不寻常的文章。文章标题叫《2028:Two scenarios for global AI leadership》,讲的是2028年全球AI领导权的两种可能。
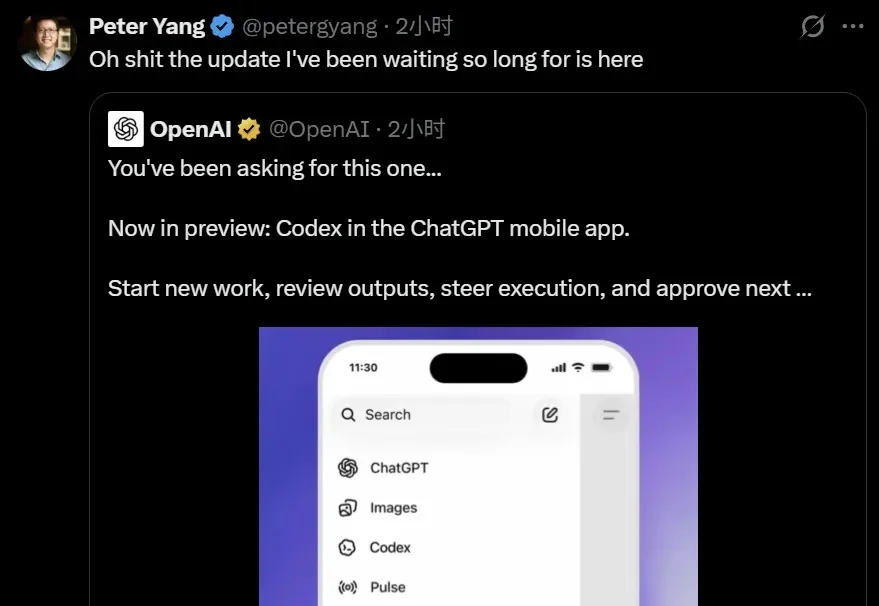
大家等这个等太久了。 本周五,OpenAI 宣布 Codex 手机版在 ChatGPT App 中上线,安卓和 iOS 版都已开启 preview,面向包括免费版的所有用户。
刚刚,OpenAI 把 Codex 塞进了手机了,将Codex 集成进 ChatGPT 移动端 APP,目前正以 preview 形式在 iOS 和 Android 上滚动上线,并且面向所有 ChatGPT plans,包括 Free 和 Go开放。