AI资讯新闻榜单内容搜索-o

AITNT-国内领先的一站式人工智能新闻资讯网站
# 热门搜索 #
搜索: o
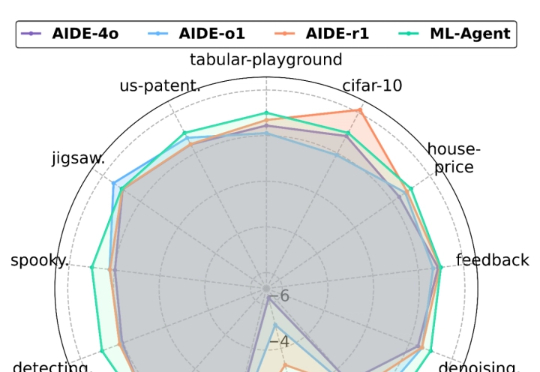
7B智能体仅凭9个任务训练即超越R1!上交大打造AI-for-AI新范式

7B智能体仅凭9个任务训练即超越R1!上交大打造AI-for-AI新范式

7B智能体仅凭9个任务训练即超越R1!上交大打造AI-for-AI新范式

尽管人工智能(AI)在飞速发展,当前 AI 开发仍严重依赖人类专家大量的手动实验和反复的调参迭代,过程费时费力。

来自主题: AI技术研报
9103 点击    2025-06-22 15:58
速递|史上最大种子轮:Thinking Machines Lab以100亿美元估值,完成20亿美元融资

速递|史上最大种子轮:Thinking Machines Lab以100亿美元估值,完成20亿美元融资

速递|史上最大种子轮:Thinking Machines Lab以100亿美元估值,完成20亿美元融资

据《金融时报》报道,由OpenAI 前CTO Mira Murati 创立的隐秘人工智能初创公司 Thinking Machines Lab 已完成 20 亿美元种子轮融资 。这笔交易使这家成立仅 6 个月的初创公司估值达到 100 亿美元。 
来自主题: AI资讯
9302 点击    2025-06-22 12:42
把AI agent用在这一垂直领域,这家公司拿到a16z领投的1700万美元,还让传统经销商预约量暴涨6倍

把AI agent用在这一垂直领域,这家公司拿到a16z领投的1700万美元,还让传统经销商预约量暴涨6倍

把AI agent用在这一垂直领域,这家公司拿到a16z领投的1700万美元,还让传统经销商预约量暴涨6倍

你能想象一个汽车经销商每天漏接45%电话的场景吗?这意味着几乎一半想要预约保养、询问配件或购车咨询的客户都被直接晾在了一边。
来自主题: AI资讯
8804 点击    2025-06-22 12:30
知识储备≠模型能力!DeepMind强化学习微调:大幅缩小「知行差距」

知识储备≠模型能力!DeepMind强化学习微调:大幅缩小「知行差距」

知识储备≠模型能力!DeepMind强化学习微调:大幅缩小「知行差距」

大语言模型(LLMs)在决策场景中常因贪婪性、频率偏差和知行差距表现欠佳。研究者提出强化学习微调(RLFT),通过自我生成的推理链(CoT)优化模型,提升决策能力。实验表明,RLFT可增加模型探索性,缩小知行差距,但探索策略仍有改进空间。
来自主题: AI技术研报
8858 点击    2025-06-22 11:34
月之暗面「调教」出最强Agent,在「人类最后一场考试」拿下最新 SOTA

月之暗面「调教」出最强Agent,在「人类最后一场考试」拿下最新 SOTA

月之暗面「调教」出最强Agent,在「人类最后一场考试」拿下最新 SOTA

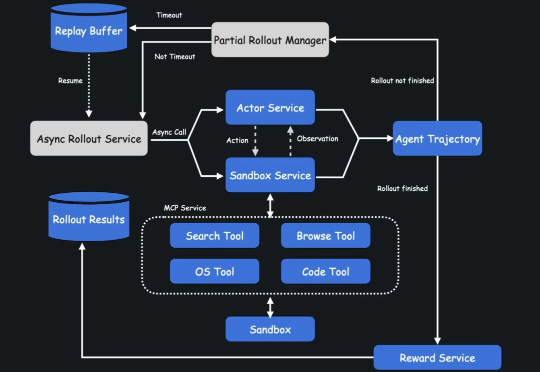
这款 Agent 擅长多轮搜索和推理,平均每项任务执行 23 个推理步骤,访问超过 200 个网址。它是基于 Kimi k 系列模型的内部版本构建,并完全通过端到端智能体强化学习进行训练,也是国内少有的基于自研模型打造的 Agent。
来自主题: AI资讯
11470 点击    2025-06-21 19:42
排名超越BeautyPlus,300万美元收入的“AI换发型”应用爆火美国

排名超越BeautyPlus,300万美元收入的“AI换发型”应用爆火美国

排名超越BeautyPlus,300万美元收入的“AI换发型”应用爆火美国

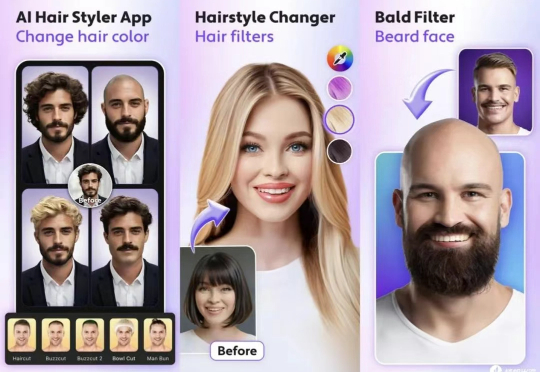
前有美图的出海,验证了“颜值经济”的普适性,也悄然改变着大众对于修图工具类产品的消费认知。
来自主题: AI资讯
9505 点击    2025-06-21 19:35
对谈斯坦福 Biomni 作者黄柯鑫:AI Scientist 领域将出现 Cursor 级别的机会|Best Minds

对谈斯坦福 Biomni 作者黄柯鑫:AI Scientist 领域将出现 Cursor 级别的机会|Best Minds

对谈斯坦福 Biomni 作者黄柯鑫:AI Scientist 领域将出现 Cursor 级别的机会|Best Minds

随着语言模型在强化学习和 agentic 领域的进步,agent 正在从通用领域快速渗透到垂直领域,科学和生物医药这类高价值领域尤其受到关注。

来自主题: AI资讯
10186 点击    2025-06-21 18:43