
用3D几何先验驱动视频扩散,实现更一致的世界生成
用3D几何先验驱动视频扩散,实现更一致的世界生成随着视频扩散模型能力不断提升,从单张图像出发、按照用户指定的相机轨迹生成新视角视频,正在成为 World Modeling 的重要技术路线。
来自主题: AI技术研报
6790 点击 2026-08-19 15:04

 搜索
随着视频扩散模型能力不断提升,从单张图像出发、按照用户指定的相机轨迹生成新视角视频,正在成为 World Modeling 的重要技术路线。

科研的链条很长。文献读不完,方向想不清,实验一轮接一轮,论文改到深夜。过去两年,大模型已经能读论文、写代码、改文章,但它们大多以问答工具的形态散落在各个环节,替研究者节省的只是零碎时间。

Stack Overflow,有「程序员圣经」之称,已经积累超过 2400 万个问题专业社区,全网最大的编程问答语料库,正在走向死亡。
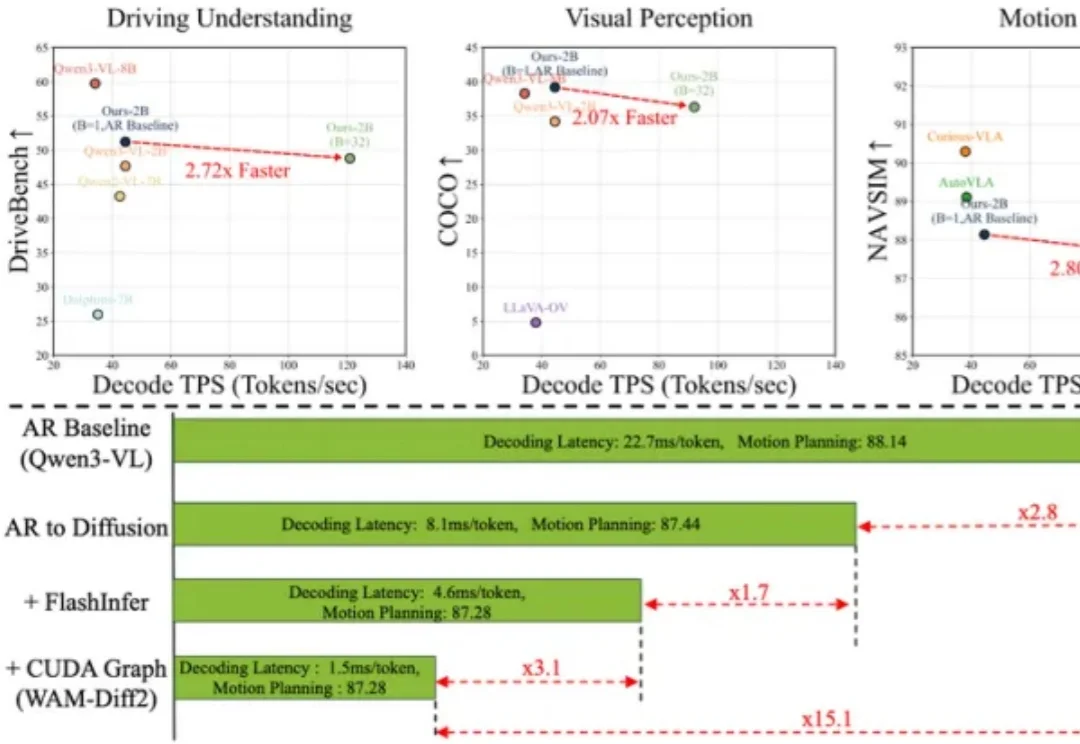
视觉 - 语言 - 动作(VLA)模型已成为端到端自动驾驶的主流技术路线,但基于自回归(AR)解码的现有架构面临双重结构性瓶颈:其一,逐 Token 串行生成导致推理延迟随序列长度线性增长,严重制约实时部署;其二,训练阶段依赖真实前缀的 teacher forcing 机制,使模型在推理时暴露于自身生成的误差之上,引发长时序累积的曝光偏差(exposure bias)。

Mythos玩起了“霸凌”、Opus 4.8使上了“阴招”……

当下,几乎所有人都在押注更大、更聪明的 AI 模型。但 AI 的下一个核心护城河到底是什么?最近,a16z 发布了一篇深度文章——《下一个 AI 护城河并非更优的模型》(The Next AI Moat Isn’t a Better Model)。

近日有消息确认,字节跳动旗下豆包Ocean AI硬件产品负责人之一刘锐(内部花名沐然)已正式离职。据接近团队的人士透露,刘锐离职后大概率将开启创业,具体方向目前尚未明确。

史无前例,OpenAI真的停手了!刚刚,奥特曼亲自官宣,「OpenAI暂停下一代旗舰模型的强化学习训练,为期两周」。官方给出停更的原因是:要确保安全、对齐和监控标准,能跟得上眼前这个全新的能力水平。

不太妙。

机器人撬开啤酒瓶盖,白色泡沫顺着瓶口涌出来。