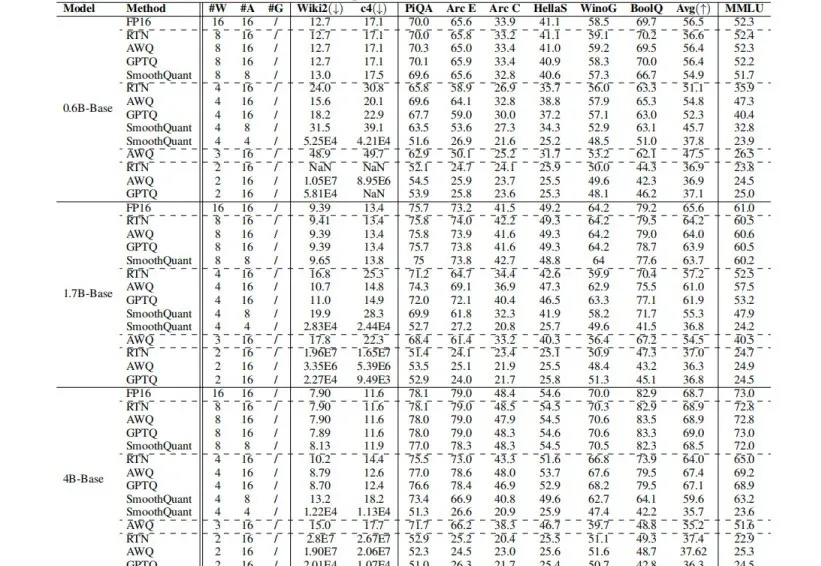
首次系统评估Qwen3在后训练量化下的鲁棒性:8bit下仍保持近乎无损性能
首次系统评估Qwen3在后训练量化下的鲁棒性:8bit下仍保持近乎无损性能Qwen3强势刷新开源模型SOTA,但如何让其在资源受限场景中,既能实现低比特量化,又能保证模型“智商”不掉线?
来自主题: AI技术研报
10148 点击 2025-05-07 13:52

 搜索
Qwen3强势刷新开源模型SOTA,但如何让其在资源受限场景中,既能实现低比特量化,又能保证模型“智商”不掉线?
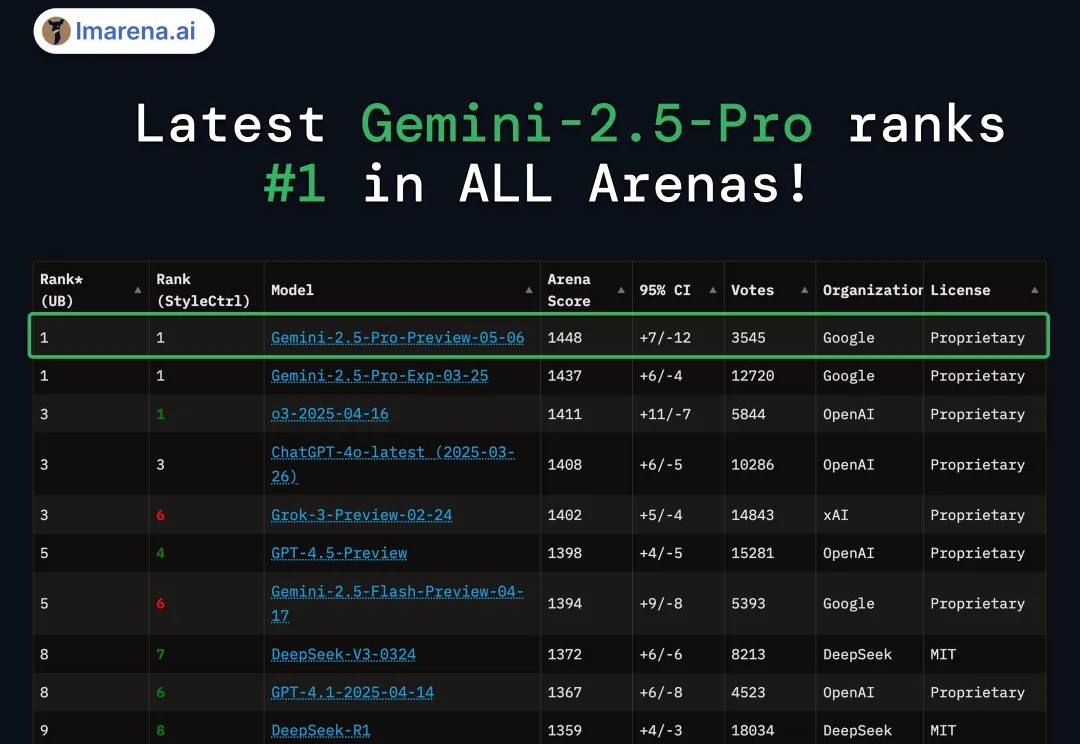
因为大家太过热情, Gemini 2.5提前重磅更新—— 史上最强编码模型Gemini 2.5 Pro Preview的I/O版。

Anysphere对中国创业公司有哪些启示?

用资本换时间,用布局换路径,用入口控未来。
随着大模型加速渗透核心行业,其安全可控性正从技术议题升级为产业落地的先决条件。
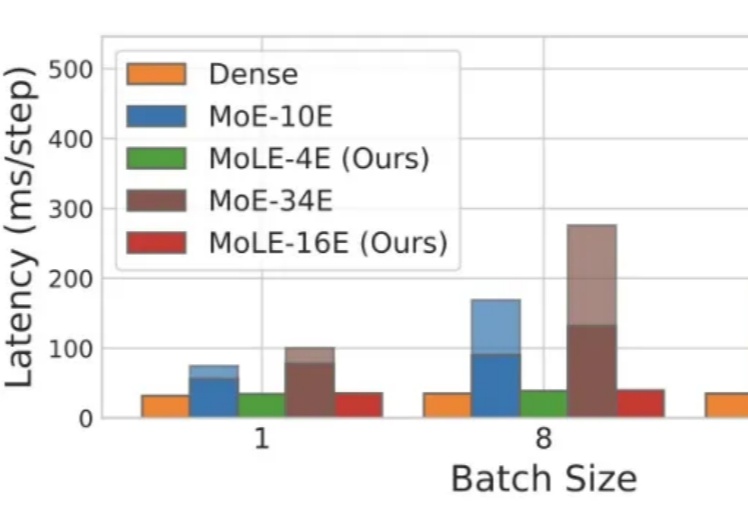
Mixture-of-Experts(MoE)在推理时仅激活每个 token 所需的一小部分专家,凭借其稀疏激活的特点,已成为当前 LLM 中的主流架构。然而,MoE 虽然显著降低了推理时的计算量,但整体参数规模依然大于同等性能的 Dense 模型,因此在显存资源极为受限的端侧部署场景中,仍然面临较大挑战。
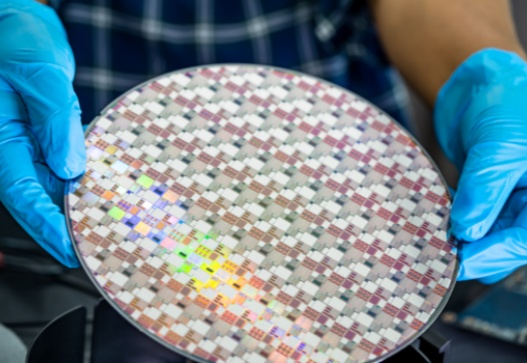
“活过眼前的数据治理‘脏活累活’,未来五年,这个赛道遍布机遇。”深耕半导体赛道的喆塔科技创始人兼 CEO 赵文政对这个方向充满信心,他如今正在半导体软件领域引入 AI 技术。
你的默认编程模型是什么?或许可以换一换了。刚刚,Google DeepMind 发布了 Gemini 2.5 Pro 的最新更新版本:Gemini 2.5 Pro (I/O edition)。其最大的进步是编程能力大幅提升,不仅在 LMArena 编程排行榜上名列第一,同时也在 WebDev Arena 排行榜上更是以显著优势超过了昔日霸
人工智能浪潮之巅,巨头布局落子如飞。最新消息曝光,OpenAI 正计划进行其史上最大手笔的收购——斥资约 30 亿美元(折合人民币约 217 亿元)拿下 AI 编程领域的当红新贵 Windsurf !

今年4月,Cursor年度经常性收入已增至约2亿美元。