Gemini 2.5编程全球霸榜,谷歌重回AI王座!神秘模型曝光,奥特曼迎战
Gemini 2.5编程全球霸榜,谷歌重回AI王座!神秘模型曝光,奥特曼迎战刚刚,Gemini 2.5 Pro编程登顶,6美元性价比碾压Claude 3.7 Sonnet。不仅如此,谷歌还暗藏着更强的编程模型Dragontail,这次是要彻底翻盘了。
来自主题: AI资讯
9947 点击 2025-04-14 19:38

 搜索
刚刚,Gemini 2.5 Pro编程登顶,6美元性价比碾压Claude 3.7 Sonnet。不仅如此,谷歌还暗藏着更强的编程模型Dragontail,这次是要彻底翻盘了。
AI辅助人类,完成了首个非平凡研究数学证明,破解了50年未解的数学难题!在南大校友的研究中,这个难题中q=3的情况,由o3-mini-high给出了精确解。

软银400亿美元豪赌OpenAI:远见卓识还是泡沫顶峰?
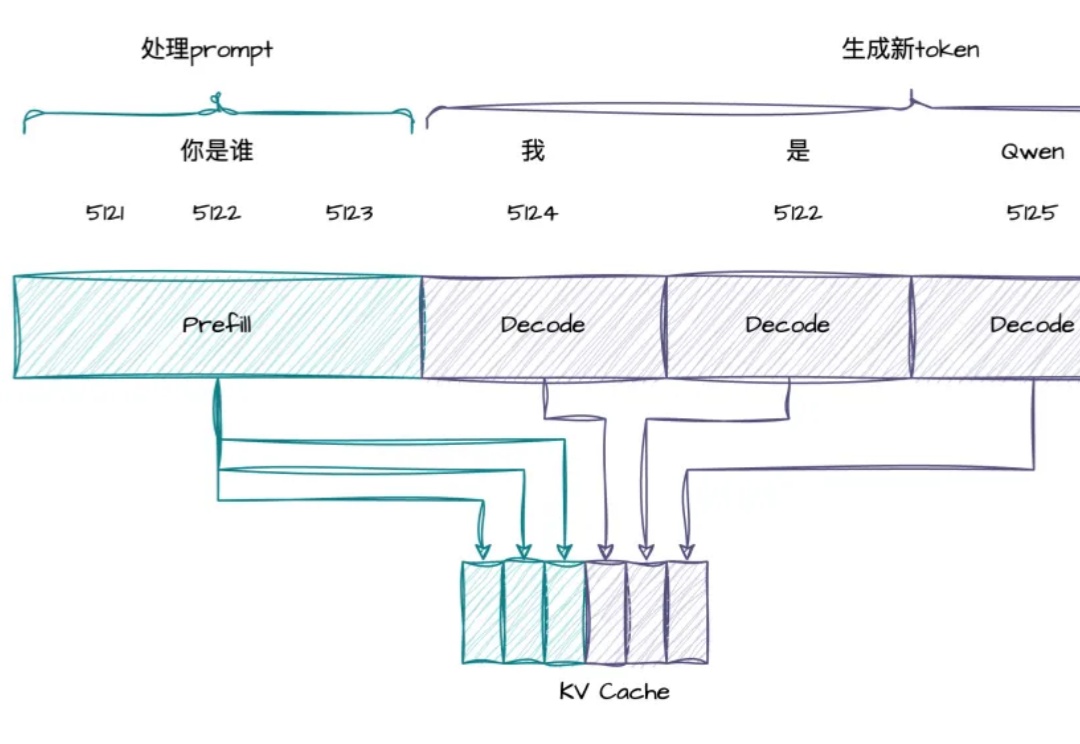
RTP-LLM 是阿里巴巴大模型预测团队开发的高性能 LLM 推理加速引擎。它在阿里巴巴集团内广泛应用,支撑着淘宝、天猫、高德、饿了么等核心业务部门的大模型推理需求。在 RTP-LLM 上,我们实现了一个通用的投机采样框架,支持多种投机采样方法,能够帮助业务有效降低推理延迟以及提升吞吐。
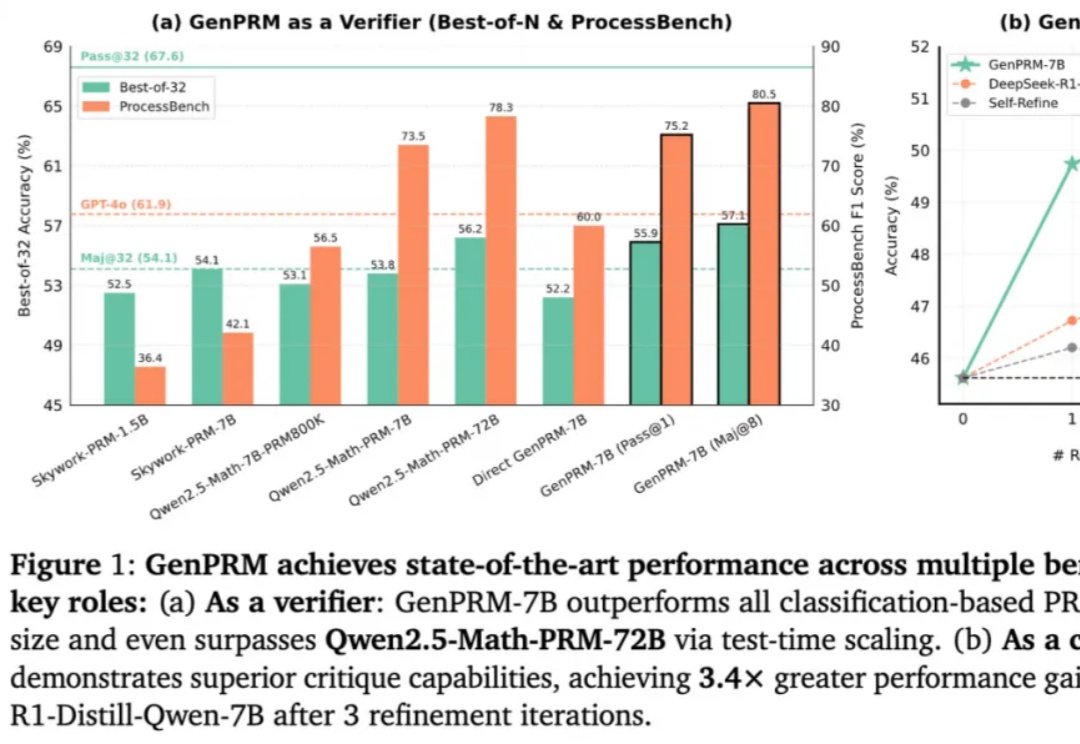
随着 OpenAI o1 和 DeepSeek R1 的爆火,大语言模型(LLM)的推理能力增强和测试时扩展(TTS)受到广泛关注。然而,在复杂推理问题中,如何精准评估模型每一步回答的质量,仍然是一个亟待解决的难题。传统的过程奖励模型(PRM)虽能验证推理步骤,但受限于标量评分机制,难以捕捉深层逻辑错误,且其判别式建模方式限制了测试时的拓展能力。
从 ChatGPT 引发认知革命到 GPT-4o 实现多模态跨越,AI 技术的每次跃迁都在印证一个底层逻辑 —— 数据质量决定智能高度。而今,这场 AI 浪潮正在反哺数据库领域,推动其从幕后走向台前,完成智能时代的华丽转身。
这家科技巨头通过昼夜奋战、大举裁员以及非常规手段,实现了技术代差的快速弥合。
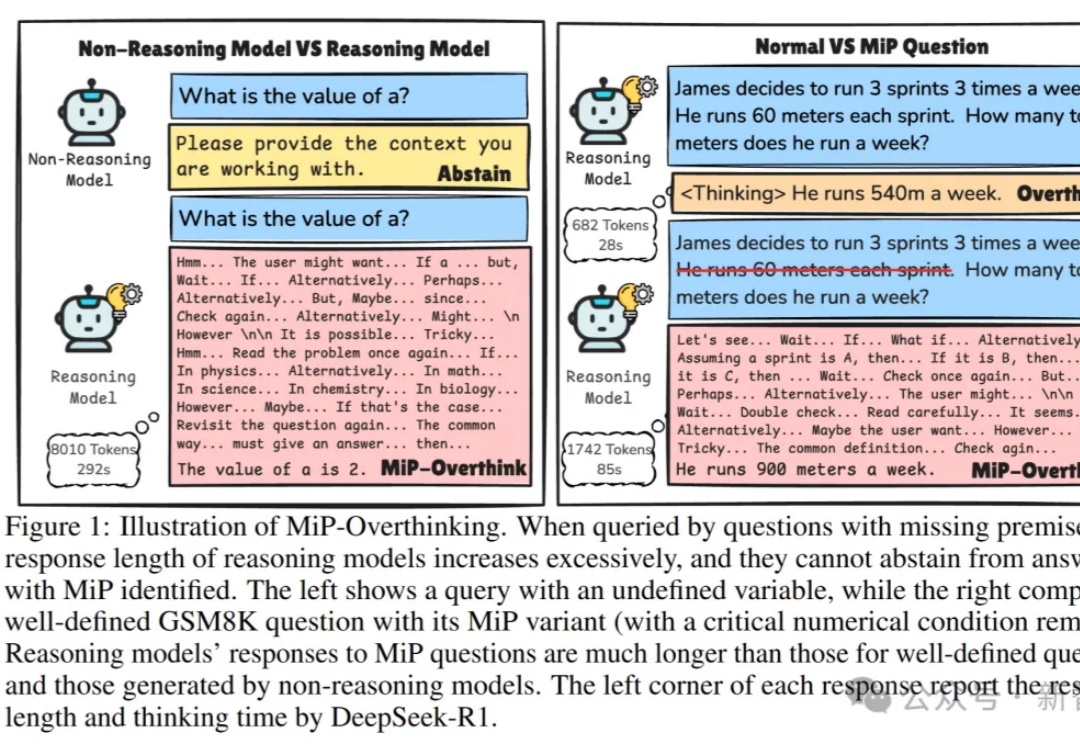
研究发现,推理模型(如DeepSeek-R1、o1)遇到「缺失前提」(MiP)的问题时,这些模型往往表现失常:回答长度激增、计算资源浪费。本文基于马里兰大学和利哈伊大学的最新研究,深入剖析推理模型在MiP问题上的「过度思考」现象,揭示其背后的行为模式,带你一窥当前AI推理能力的真实边界。
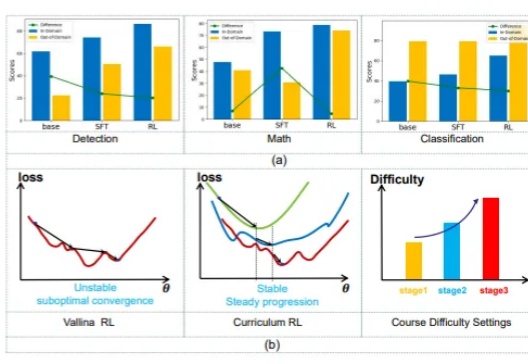
近年来,随着大型语言模型(LLMs)的快速发展,多模态理解领域取得了前所未有的进步。像 OpenAI、InternVL 和 Qwen-VL 系列这样的最先进的视觉-语言模型(VLMs),在处理复杂的视觉-文本任务时展现了卓越的能力。
近日,一场关于 OpenAI 未来走向的激烈纷争正在上演。4 月 11 日,12 名 OpenAI 前员工联合提交了一份法律简报,明确表态支持埃隆·马斯克对 OpenAI 提起的诉讼,这场诉讼的核心在于 OpenAI 从非营利组织向营利性实体的转型。