AI资讯新闻榜单内容搜索-o

AITNT-国内领先的一站式人工智能新闻资讯网站
# 热门搜索 #
搜索: o
具身智能新时代!VLA迎来最强基础模型Magma:UI导航、机器人操作全能

具身智能新时代!VLA迎来最强基础模型Magma:UI导航、机器人操作全能

具身智能新时代!VLA迎来最强基础模型Magma:UI导航、机器人操作全能

Magma是一个新型多模态基础模型,能够理解和执行多模态任务,适用于数字和物理环境:通过标记集合(SoM)和标记轨迹(ToM)技术,将视觉语言数据转化为可操作任务,显著提升了空间智能和任务泛化能力。
来自主题: AI技术研报
8622 点击    2025-03-11 10:49
「古董」GPU也能跑DeepSeek同款GRPO!显存只需1/10,上下文爆涨10倍

「古董」GPU也能跑DeepSeek同款GRPO!显存只需1/10,上下文爆涨10倍

「古董」GPU也能跑DeepSeek同款GRPO!显存只需1/10,上下文爆涨10倍

开源微调神器Unsloth带着黑科技又来了:短短两周后,再次优化DeepSeek-R1同款GRPO训练算法,上下文变长10倍,而显存只需原来的1/10!

来自主题: AI技术研报
6935 点击    2025-03-11 10:42
从 Manus 到 GO-1:当AI逐渐走入物理世界

从 Manus 到 GO-1:当AI逐渐走入物理世界

从 Manus 到 GO-1:当AI逐渐走入物理世界

创造智能时代的终极图景 —— 一个虚实交融、万物互联的实时数字孪生世界

来自主题: AI资讯
8232 点击    2025-03-11 10:09
从DeepSeek聊到AGI,Lex Fridman这期播客值得一听——投资笔记第208期

从DeepSeek聊到AGI,Lex Fridman这期播客值得一听——投资笔记第208期

从DeepSeek聊到AGI,Lex Fridman这期播客值得一听——投资笔记第208期

一期长达5小时的播客,究竟谁在听?MIT人工智能研究员、知名播客主持人及科技传播者Lex Fridman的对谈节目《Lex Fridman Podcast》近期推出了有关DeepSeek的一期内容: 截至3月7日,这一期节目在YouTube上获得了178万播放量和2.5万like(点赞),对DeepSeek所代表的AI大模型革新的解读,获得了大量科技界、商界从业者的关注。

来自主题: AI资讯
8923 点击    2025-03-11 09:42
优于o1预览版,推理阶段KV缓存缩减一半,LightTransfer降本还能增效

优于o1预览版,推理阶段KV缓存缩减一半,LightTransfer降本还能增效

优于o1预览版,推理阶段KV缓存缩减一半,LightTransfer降本还能增效

LLM 在生成 long CoT 方面展现出惊人的能力,例如 o1 已能生成长度高达 100K tokens 的序列。然而,这也给 KV cache 的存储带来了严峻挑战。

来自主题: AI技术研报
7359 点击    2025-03-11 09:32
哥大本科生靠AI横扫硅谷大厂offer,学校震怒!预言码农两年内淘汰准备退学

哥大本科生靠AI横扫硅谷大厂offer,学校震怒!预言码农两年内淘汰准备退学

哥大本科生靠AI横扫硅谷大厂offer,学校震怒!预言码农两年内淘汰准备退学

哥大的大二学生Roy Lee,靠AI作弊顺利取得亚马逊、Meta、TikTok等大厂的offer!被告发后,哥大在11日将举行听证会,但小哥表示,自己已经买了单程票,到时自己并不会在学校,甚至可能退学。如今,小哥已经成了网红,AI作弊神器Interview Coder卖60美元一个月,公司收入快破百万了。
来自主题: AI资讯
9013 点击    2025-03-10 22:16
已节省数百万GPU小时!字节再砍MoE训练成本,核心代码全开源

已节省数百万GPU小时!字节再砍MoE训练成本,核心代码全开源

已节省数百万GPU小时!字节再砍MoE训练成本,核心代码全开源

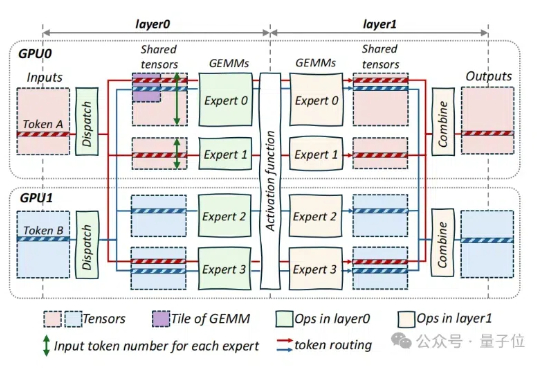
字节对MoE模型训练成本再砍一刀,成本可节省40%! 刚刚,豆包大模型团队在GitHub上开源了叫做COMET的MoE优化技术。

来自主题: AI技术研报
9410 点击    2025-03-10 21:57