
AI癌症检测新突破:Paige扩展癌症筛查至40多种器官与组织
AI癌症检测新突破:Paige扩展癌症筛查至40多种器官与组织月6日,专注于下一代人工智能技术的公司Paige近日宣布其旗舰产品Paige PanCancer Detect实现了重大升级。这款AI应用是首个能够检测多种组织和器官癌症的工具,最初于2024年初推出时已能帮助病理学家检测超过17种不同的组织癌症。
来自主题: AI资讯
8799 点击 2025-02-08 12:58

 搜索
月6日,专注于下一代人工智能技术的公司Paige近日宣布其旗舰产品Paige PanCancer Detect实现了重大升级。这款AI应用是首个能够检测多种组织和器官癌症的工具,最初于2024年初推出时已能帮助病理学家检测超过17种不同的组织癌症。
DeepSeek的V3模型仅用557.6万的训练成本,实现了与OpenAI O1推理模型相近的性能,这在全球范围内引发连锁反应。由于不用那么先进的英伟达芯片就能实现AI能力的飞跃,英伟达在1月27日一天跌幅高达17%,市值一度蒸发6000亿美元。

现在,要想往视频里毫无违和感地添加任何东西,只需一张图就够了。
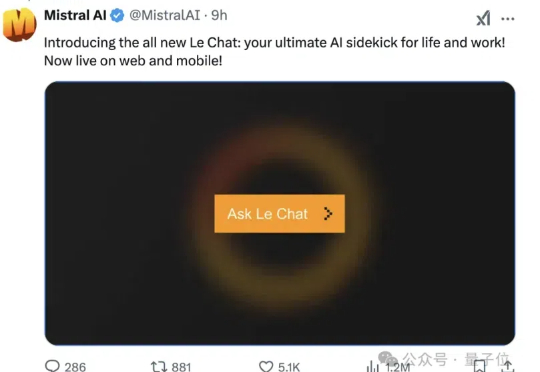
欧洲OpenAI”Mistral AI有新动作了! Le Chat(法语“猫”)全新升级,官方自称它是“您生活和工作的终极AI助手”。
IEEE/CVF国际计算机视觉与模式识别会议(CVPR)是人工智能领域最具学术影响力的顶级会议之一,将于今年 6月11日至6月15日在美国田纳西州举行。
AI的新进展频频,人才动态也愈加重磅。 新年第一则大牛人事动向,引发业内关注。 许主洪,IEEE Fellow,新加坡管理大学终身教授,被曝加盟阿里。
各位同学好,我是来自 Unlock-DeepSeek 开源项目团队的骆师傅。先说结论,我们(Datawhale X 似然实验室)使用 3 张 A800(80G) 计算卡,花了 20 小时训练时间,做出了可能是国内首批 DeepSeek R1 Zero 的中文复现版本,我们把它叫做 Datawhale-R1,用于 R1 Zero 复现教学。
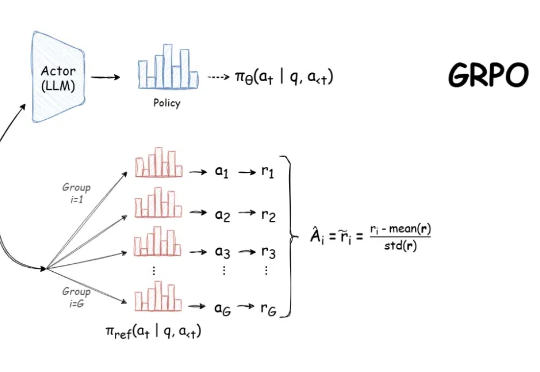
自 DeepSeek-R1 发布以来,群组相对策略优化(GRPO)因其有效性和易于训练而成为大型语言模型强化学习的热门话题。R1 论文展示了如何使用 GRPO 从遵循 LLM(DeepSeek-v3)的基本指令转变为推理模型(DeepSeek-R1)。
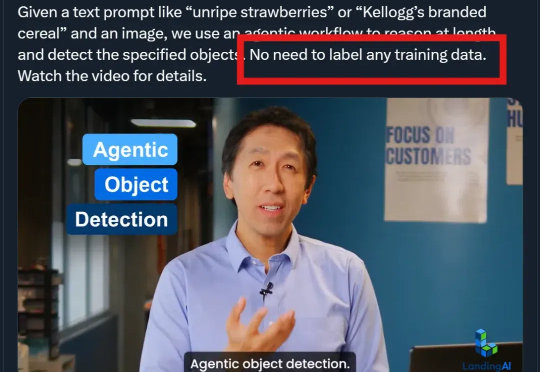
刚刚,AI大牛吴恩达官宣创业公司新成果——Agentic Object Detection
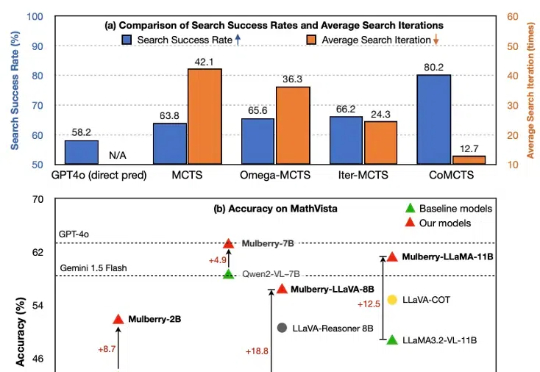
尽管多模态大语言模型(MLLM)在简单任务上最近取得了显著进展,但在复杂推理任务中表现仍然不佳。费曼的格言可能是这种现象的完美隐喻:只有掌握推理过程的每一步,才能真正解决问题。然而,当前的 MLLM 更擅长直接生成简短的最终答案,缺乏中间推理能力。本篇文章旨在开发一种通过学习创造推理过程中每个中间步骤直至最终答案的 MLLM,以实现问题的深入理解与解决。