只招1%的天才,这家中国公司让硅谷难安
只招1%的天才,这家中国公司让硅谷难安在刚刚成立的一年多时间里,DeepSeek一直不声不响,V2模型的发布成为其破圈的关键。由于模型结构层面的突破性创新,使得其将模型成本大大降低,也被业内戏称为AI届拼多多。这之后,DeepSeek也真正引发了硅谷的恐慌,OpenAI正迎来一个最强劲的对手。
来自主题: AI资讯
7290 点击 2025-01-26 13:24

 搜索
在刚刚成立的一年多时间里,DeepSeek一直不声不响,V2模型的发布成为其破圈的关键。由于模型结构层面的突破性创新,使得其将模型成本大大降低,也被业内戏称为AI届拼多多。这之后,DeepSeek也真正引发了硅谷的恐慌,OpenAI正迎来一个最强劲的对手。

在达沃斯世界经济论坛上,OpenAI 首席财务官 Sarah Friar 抛出了这颗重磅炸弹,“它们会像真正的同事一样思考问题,遇到困难会后退一步思考,尝试新的解决方案。这不再是科幻,而是即将在 2025 年实现的现实。”

最近这帮人我也不知道是因为啥,连续聊了3天跃问了,就是阶跃星辰那个手机APP。一直看我文章的老粉丝可能知道,跃问在我这儿一直都是iPhone16的AI识图启动器,但是我自己确实已经有段时间没去深度体验了。
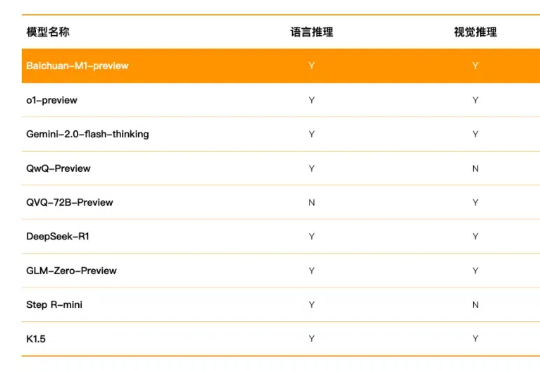
就在本周,Kimi 的新模型打开了强化学习 Scaling 新范式,DeepSeek R1 用开源的方式「接班了 OpenAI」,谷歌则把 Gemini 2.0 Flash Thinking 的上下文长度延伸到了 1M。1 月 24 日上午,百川智能重磅发布了国内首个全场景深度思考模型,把这一轮军备竞赛推向了高潮。

这款产品就是百度文库联合百度网盘最新推出的自由画布。在众多1V1对话式Chatbot竞相升级的大潮中,自由画布却另辟蹊径,宣称要“为用户提供一个全方位的创作空间”,让内容创作的全流程得以在同一个平台多线程并行处理,且支持多模态。
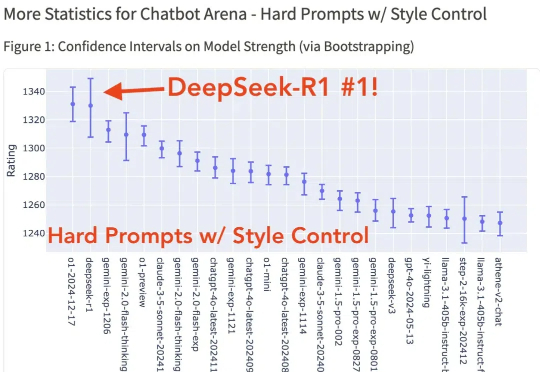
“神秘东方力量”DeepSeek给硅谷带来的影响,还在不断泛起涟漪——刚刚,DeepSeek-R1跻身大模型竞技榜前三。以开源、便宜20倍的“身价”与ChatGPT-4o(2024.11.20)并列。
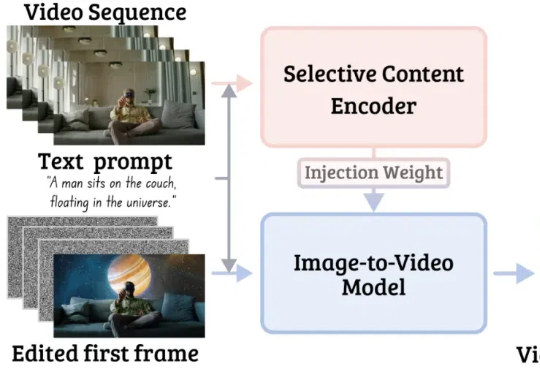
论文一作刘少腾,Adobe Research实习生,香港中文大学博士生(DV Lab),师从贾佳亚教授。主要研究方向是多模态大模型和生成模型,包含图像视频的生成、理解与编辑。作者Tianyu Wang、Soo Ye Kim等均为Adobe Research Scientist。
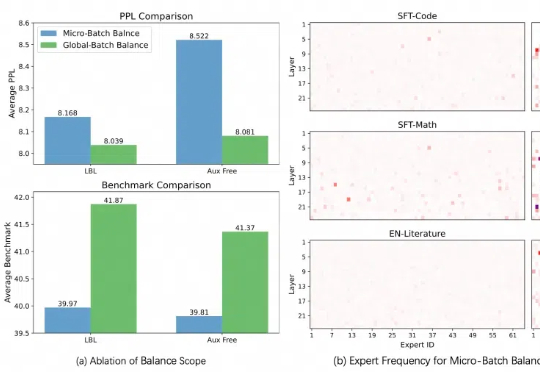
本周,在阿里云通义千问 Qwen 团队提交的一篇论文中,研究人员发现了目前最热门的 MoE(混合专家模型)训练中存在的一个普遍关键问题,并提出一种全新的方法——通过轻量的通信将局部均衡放松为全局均衡,使得 MoE 模型的性能和专家特异性都得到了显著的提升。
视觉版o1的初步探索,阶跃星辰&北航团队推出“慢感知”。研究人员认为:1)目前多模领域o1-like的模型,主要关注文本推理,对视觉感知的关注不够。2)精细/深度感知是一个复杂任务,且是未来做视觉推理的重要基础。

最近,妙鸭相机在新年之际有了新动作——上线 2.0 版本,支持「拍」Live 动态写真。时隔一年半,它能再次掀起水花吗?