ACL 2024 | 对25个开闭源模型数学评测,GPT-3.5-Turbo才勉强及格
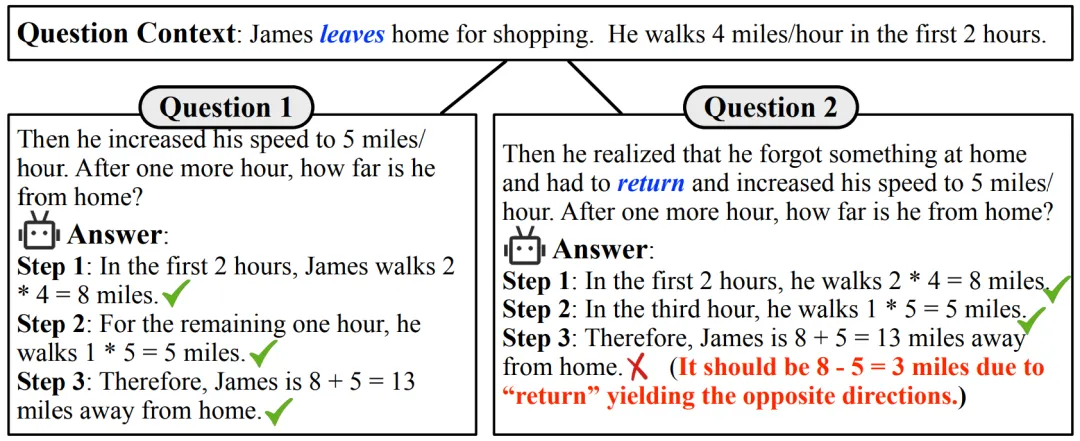
ACL 2024 | 对25个开闭源模型数学评测,GPT-3.5-Turbo才勉强及格大型语言模型(LLMs)在解决问题方面的非凡能力日益显现。最近,一个值得关注的现象是,这些模型在多项数学推理的基准测试中获得了惊人的成绩。以 GPT-4 为例,在高难度小学应用题测试集 GSM8K [1] 中表现优异,准确率高达 90% 以上。同时,许多开源模型也展现出了不俗的实力,准确率超过 80%。
搜索
大型语言模型(LLMs)在解决问题方面的非凡能力日益显现。最近,一个值得关注的现象是,这些模型在多项数学推理的基准测试中获得了惊人的成绩。以 GPT-4 为例,在高难度小学应用题测试集 GSM8K [1] 中表现优异,准确率高达 90% 以上。同时,许多开源模型也展现出了不俗的实力,准确率超过 80%。
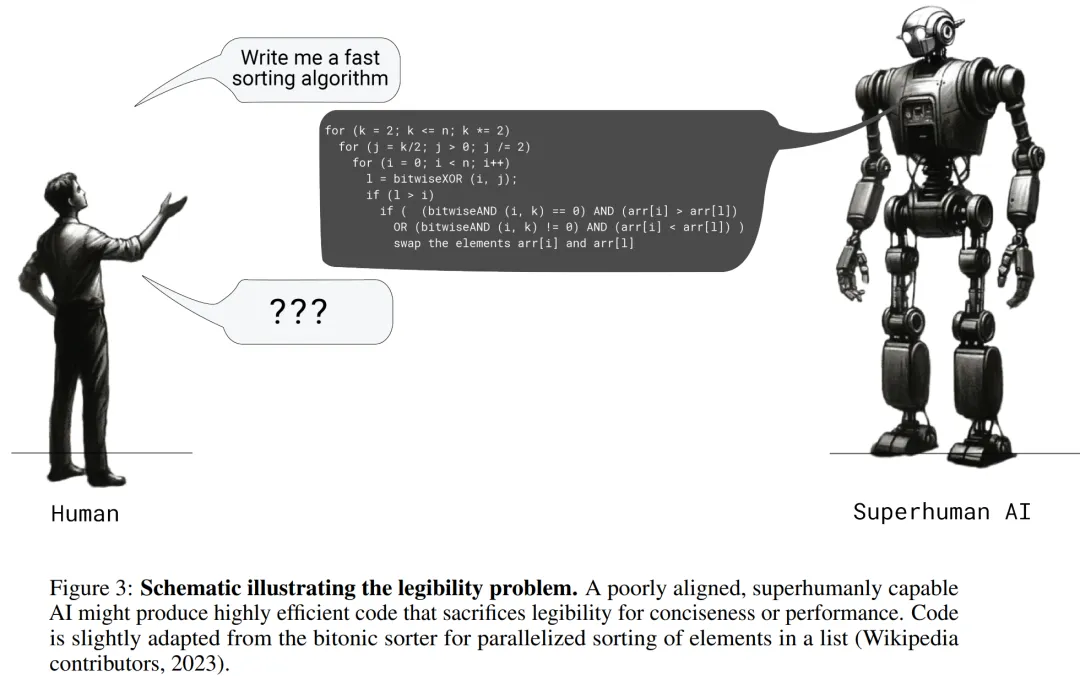
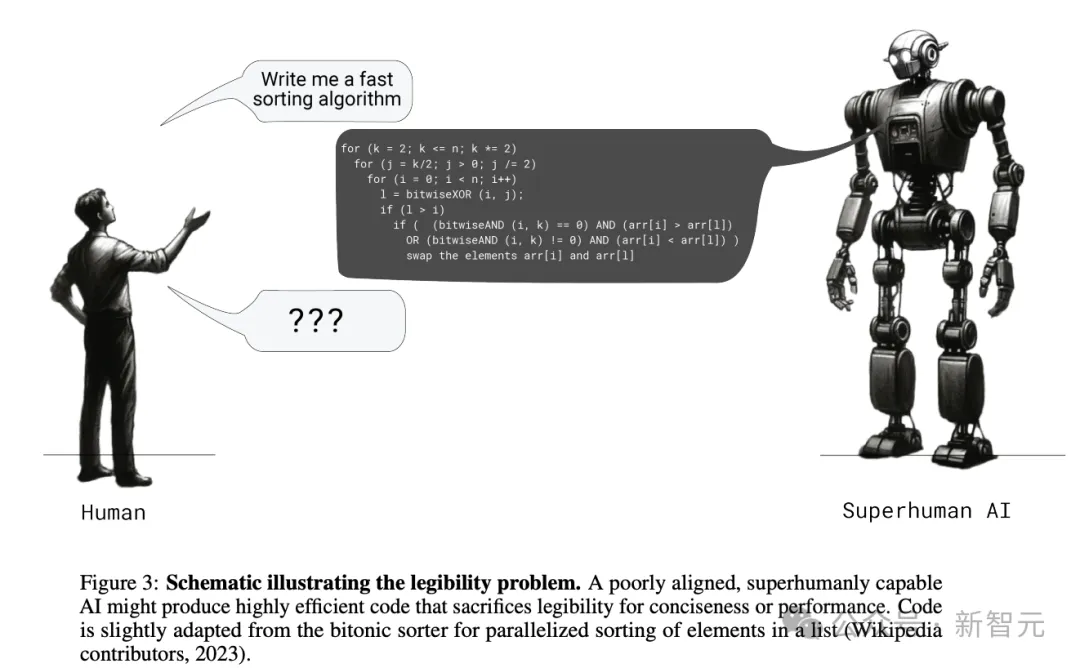
OpenAI超级对齐团队遗作:两个大模型博弈一番,输出更好懂了
离开快手创业后,「李岩」悄悄拿到了快手联合创始人宿华、红点创投以及经纬创投的3200万美金种子轮融资。
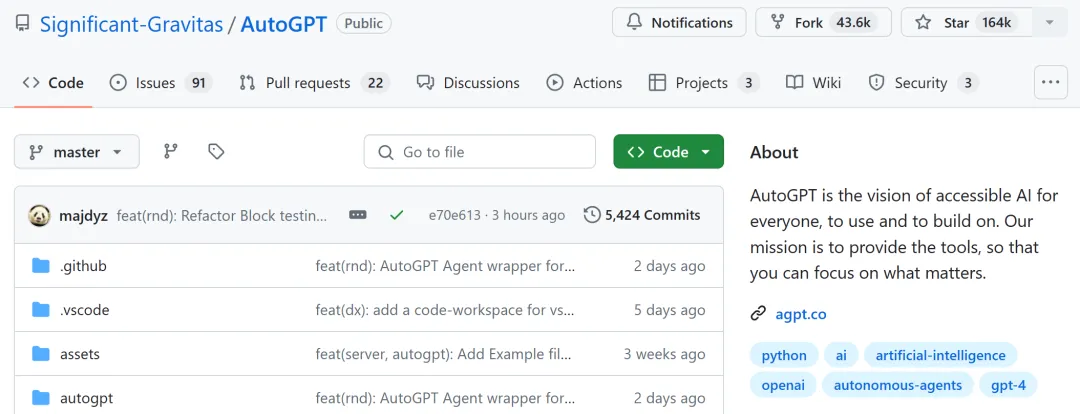
还记得去年 AI 大牛 Andrej Karpathy 大力宣传的「AutoGPT」项目吗?它是一个由 GPT-4 驱动的实验性开源应用程序,可以自主实现用户设定的任何目标,展现出了自主 AI 的发展趋势。
好家伙!为了揭秘Transformer内部工作原理,陈丹琦团队直接复现——
让大小模型相互博弈,就能实现生成内容可读性的提升!
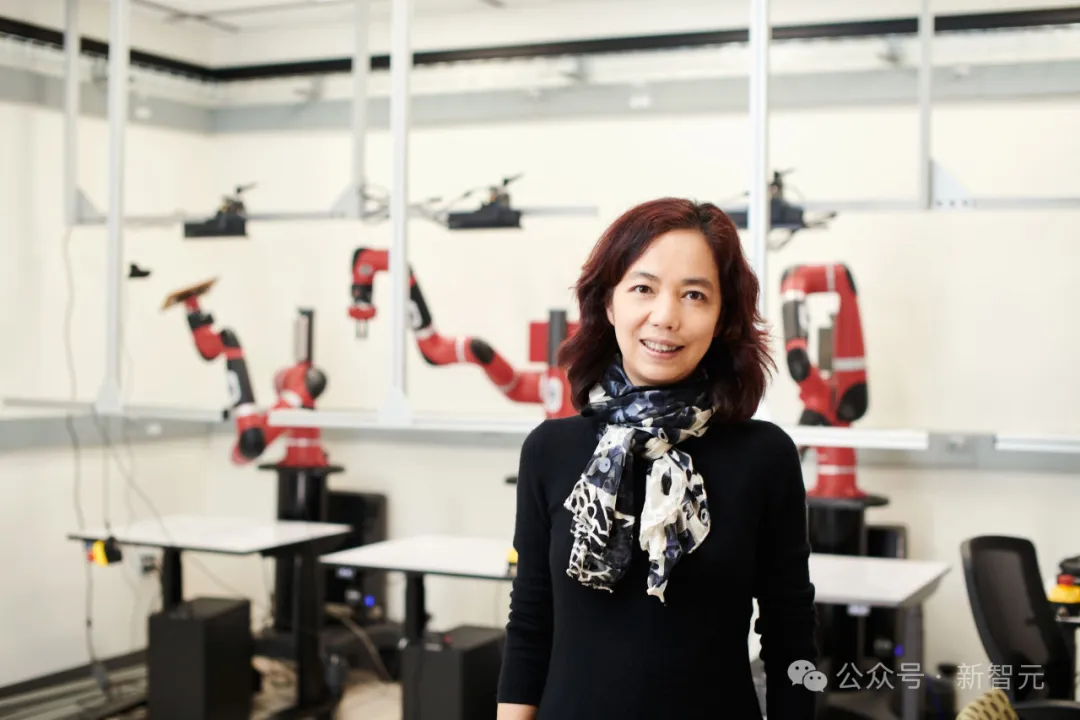
「AI教母」创业,3个月就干出了估值10亿的AI独角兽。
当我们不停在CoT等领域大下苦功、试图提升LLM推理准确性的同时,OpenAI的对齐团队从另一个角度发现了华点——除了准确性,生成答案的清晰度、可读性和可验证性也同样重要。
创业夫妻店雇AI做设计,显示器爆单成行业品牌No.1。这背后,不仅是3亿用户出海业务给的底气,也是因为一个团队一心做好了3件事。
给全球 80 亿人提供大规模、按需的个性化教育。