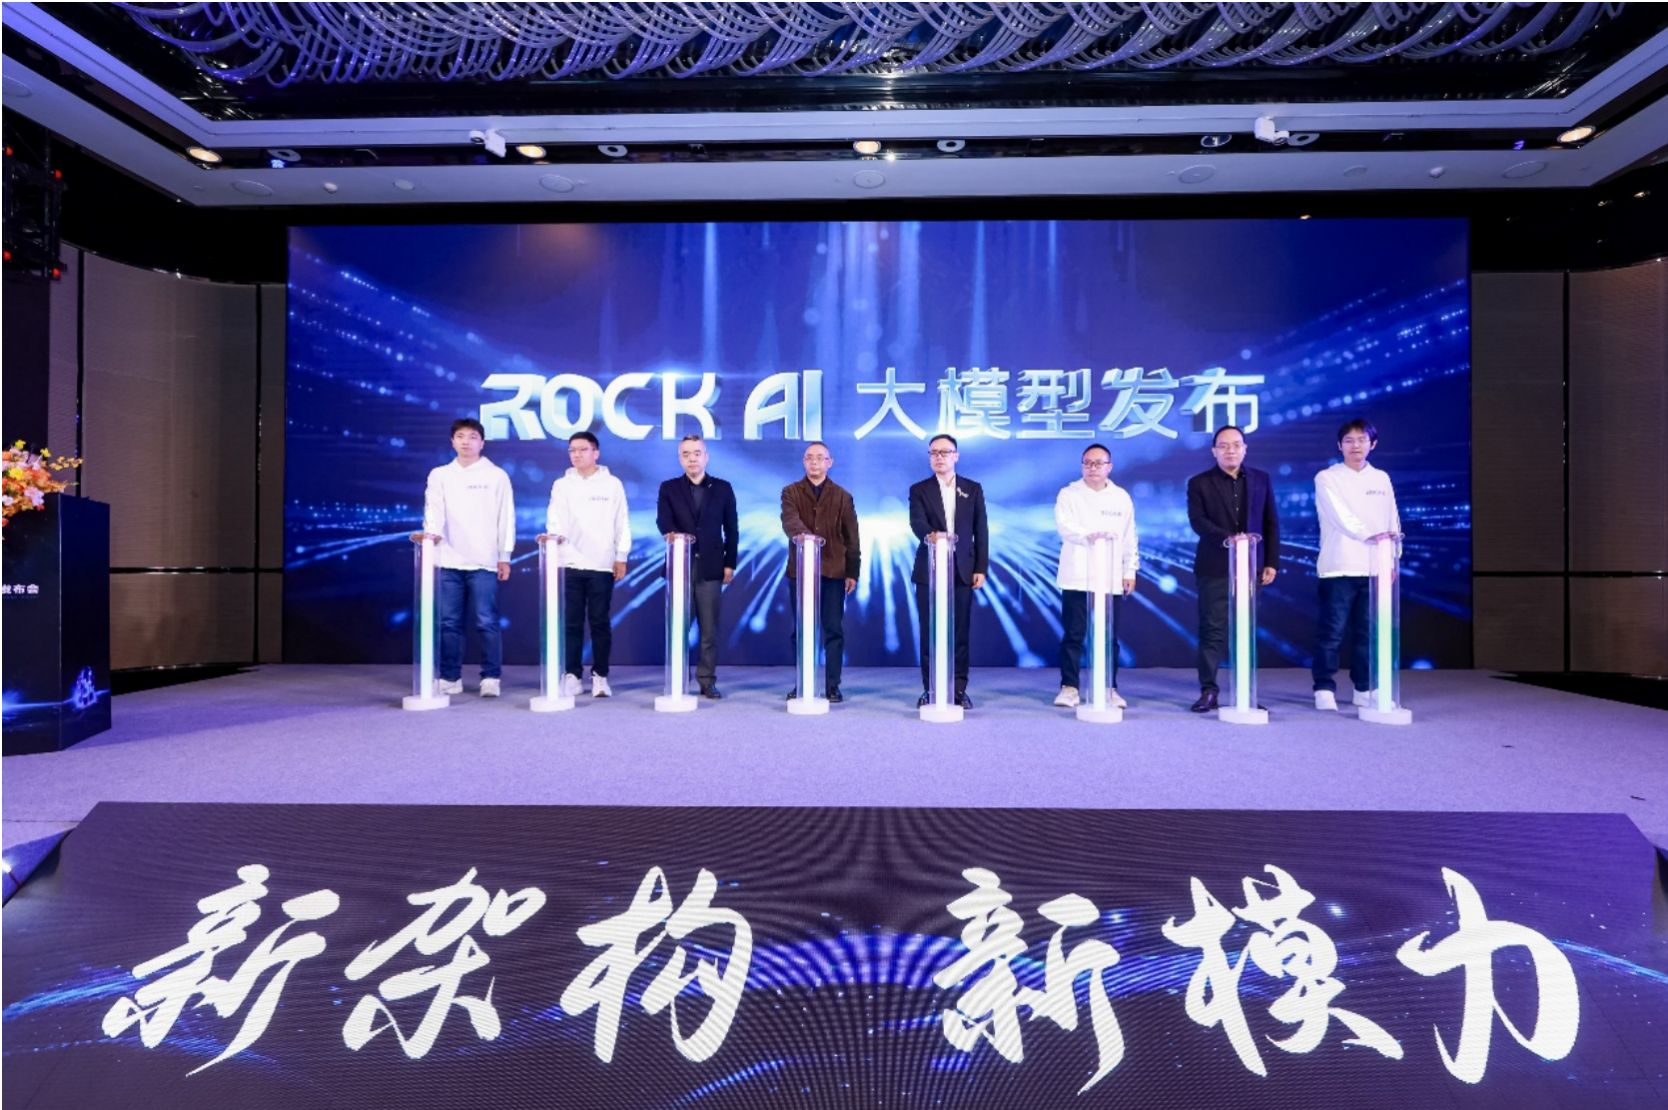
摆脱Transformer依赖?这家AI初创公司推出国内首个非Attention机制大模型
摆脱Transformer依赖?这家AI初创公司推出国内首个非Attention机制大模型以大规模著称的Transformer,在实际应用中的高算力和高成本,让不少中小型企业望而却步。
来自主题: AI资讯
7934 点击 2024-01-28 12:05

 搜索
以大规模著称的Transformer,在实际应用中的高算力和高成本,让不少中小型企业望而却步。

OpenAI联创、前特斯拉AI总监Karpathy发文,用自动驾驶诠释AGI!
药物与靶标之间的结合亲和力的预测对于药物发现至关重要。然而,现有方法的准确性仍需提高。另一方面,大多数深度学习方法只关注非共价(非键合)结合分子系统的预测,而忽略了在药物开发领域越来越受到关注的共价结合的情况。

一张名为《大模型的深渊》的图,在去年广为流行。吃瓜群众惊诧地发现,原来绝大多数大模型,都挤在深不见底的层级,“宣称自己快要落地的”“再等等决定啥时候落地的”“什么落地不落地的”“怎么还有这么多没听说过的大模型啊”……

ChatGPT悄悄更新个大功能!看起来要把插件系统迭代掉了。
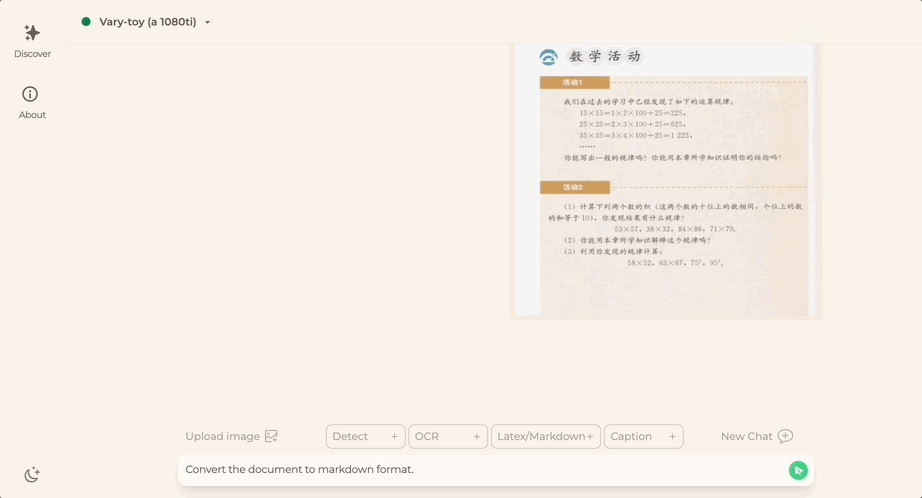
一款名为Vary-toy的“年轻人的第一个多模态大模型”来了!模型大小不到2B,消费级显卡可训练,GTX1080ti 8G的老显卡轻松运行。

GPT-4再次重磅更新,推出了整合了画图、插件、代码等所有工具的All Tools功能。
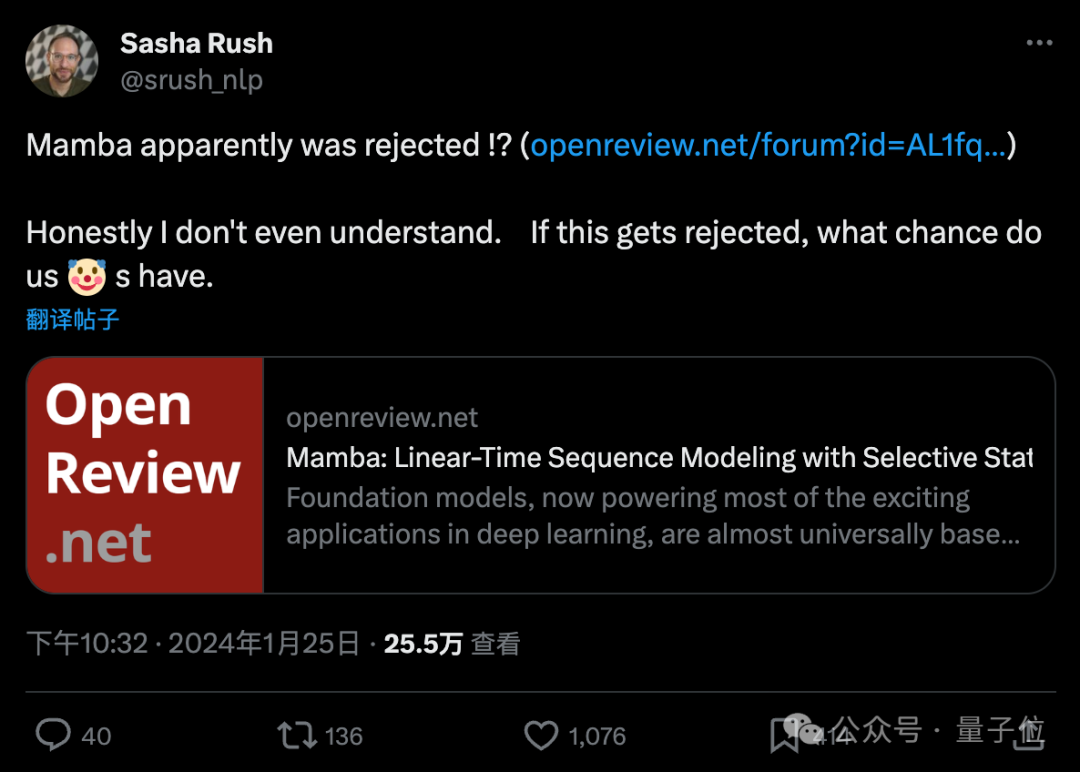
一项ICLR拒稿结果让AI研究者集体破防,纷纷刷起小丑符号。争议论文为Transformer架构挑战者Mamba,开创了大模型的一个新流派。发布两个月不到,后续研究MoE版本、多模态版本等都已跟上。

Deepfake最新受害者出现了——全球顶流,霉霉女士(Taylor Swift)。
全新GPT-4 Turbo预览模型据介绍,该模型能更完整彻底地完成代码生成等任务,以减少模型未完成任务的“惰性”情况。