前华为盘古负责人王云鹤,创业做RSI,掏出1250亿参数智能体大模型
前华为盘古负责人王云鹤,创业做RSI,掏出1250亿参数智能体大模型主模型参数1250亿,激活参数60亿。
来自主题: AI资讯
8758 点击 2026-11-06 10:51

 搜索
主模型参数1250亿,激活参数60亿。
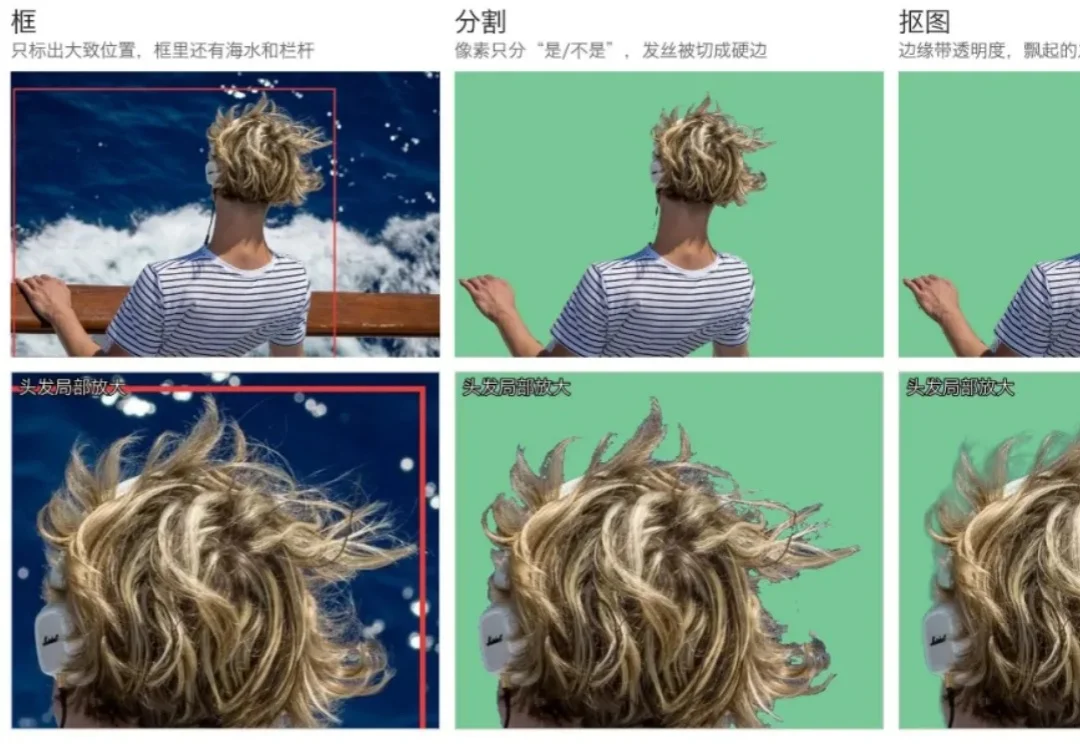
让视觉模型在图里找一样东西,它通常会给出一个框。可如果这样东西根本不在图里呢?
写下需求、等待 AI 生成、打开预览页面,如今已成为许多 AI 编程工具的标准流程:用户即使不会写代码,也能用几句话做出一个网页或小工具。
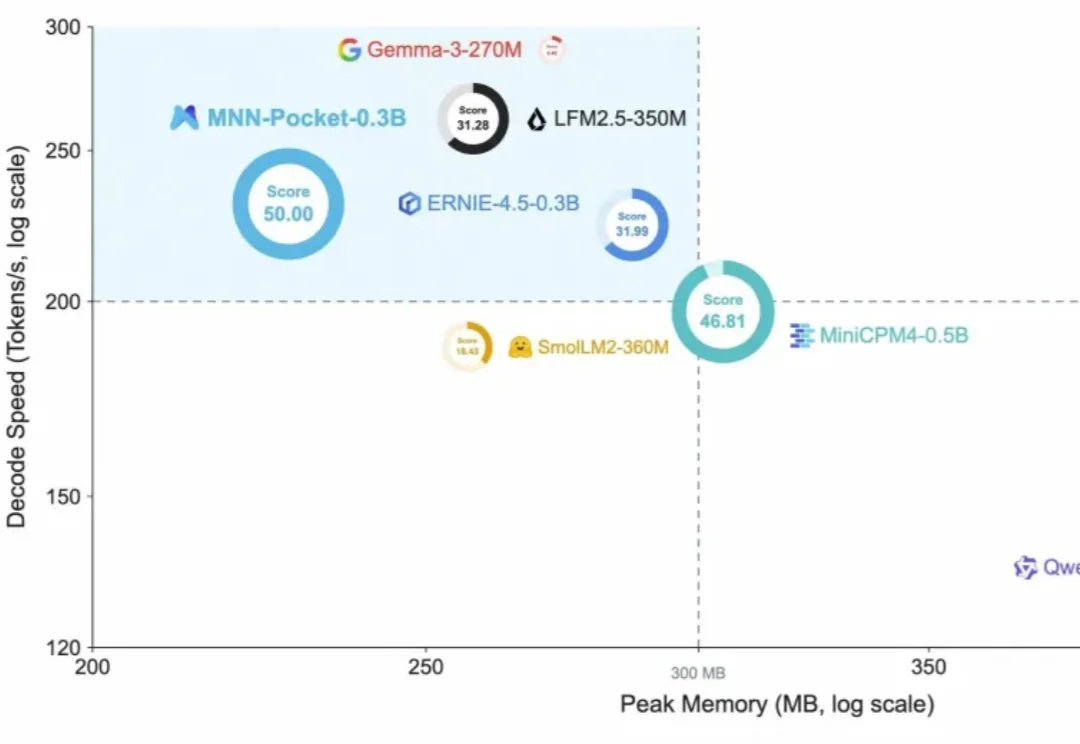
把大模型运行在手机上,已经有了不少探索。
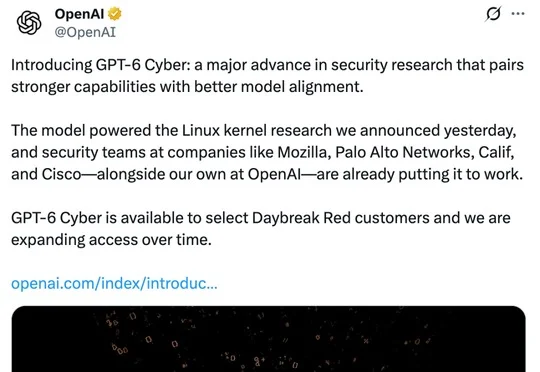
OpenAI推出主攻安全研究的GPT-6 Cyber,在ExploitGym得分48.5%超GPT-5.6 Cyber的32.1%,已发现81个Firefox新漏洞并为948个Linux漏洞开发利用程序,目前仅向Daybreak Red认证客户开放,OpenAI同时设立10亿美元一线防御者资助计划。
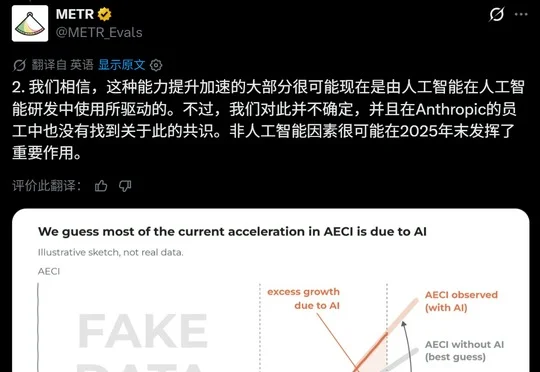
METR 调查报告称,Anthropic 过去一年的基准能力进步约等于此前两年,其中约 80% 的 AI 研究加速来自 AI 辅助人类研发,但距离完整的递归自我改进仍有差距。
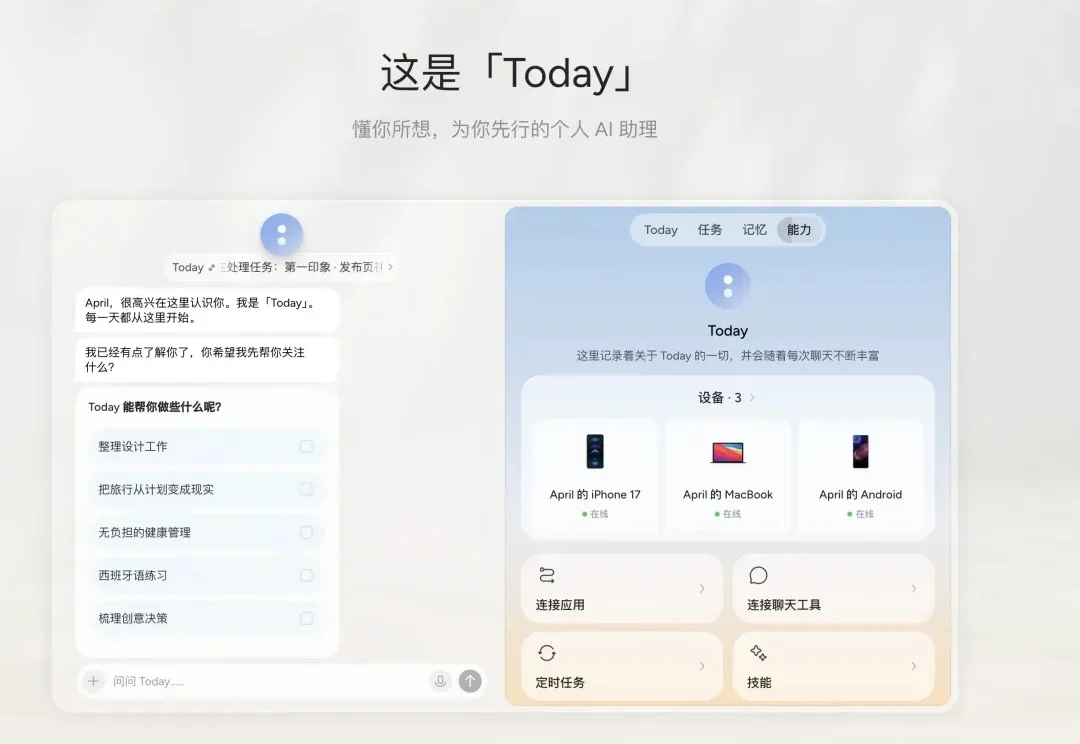
DeepSeek Harness 团队前几天发了篇关于 Super-agent 设计探索的长文,想用 Router + Worker 双层架构,把一个人管理多个 Agent 的负担交给系统。文章出来后讨论不少,大多关注这套调度机制是怎么设计的。
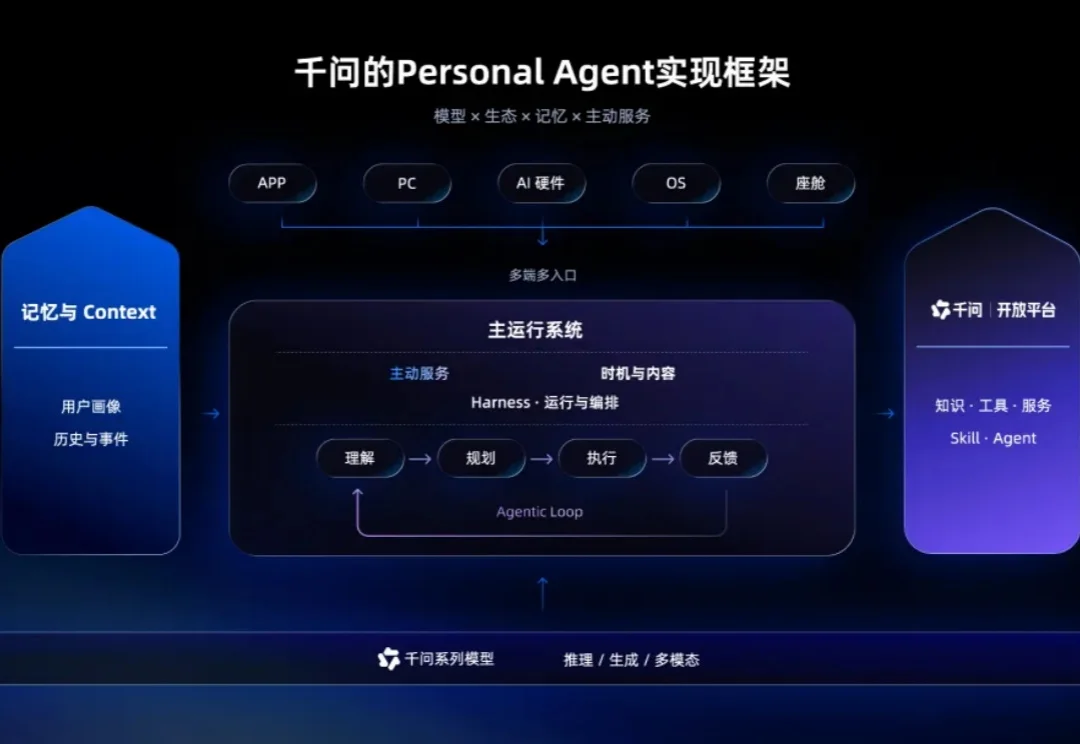
Personal Agent 撕开了一道 AI 应用的口子。
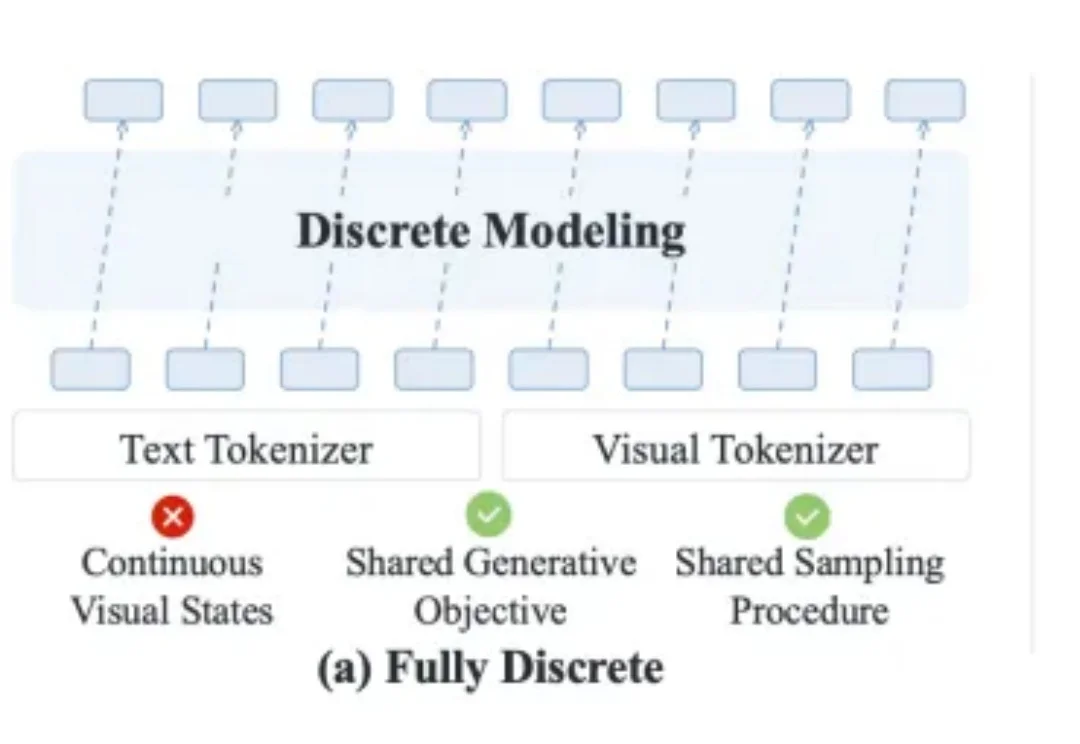
走向物理 AI 时代,构建一个能真正统一语言与视觉的多模态基座模型是关键一步。然而,语言本质上是有序的 Token 序列,视觉则是连续的高维像素分布,两者在信息结构上存在天然的鸿沟。如何在一个模型内统一这两种截然不同的分布,一直是一个备受争论的话题。
OpenAI 最近公布了一组 ChatGPT 的新数据,有几个变化挺有意思: