具身大模型R1时刻:LIBERO终结者,99.9%背后的物理推理新范式
具身大模型R1时刻:LIBERO终结者,99.9%背后的物理推理新范式机器人拉个拉链,到底需不需要“脑子”?
来自主题: AI技术研报
8551 点击 2026-05-11 16:10

 搜索
机器人拉个拉链,到底需不需要“脑子”?
这是一个“等待被大厂吞没”的行业,还是可能长出像Adobe那样的工具型公司?
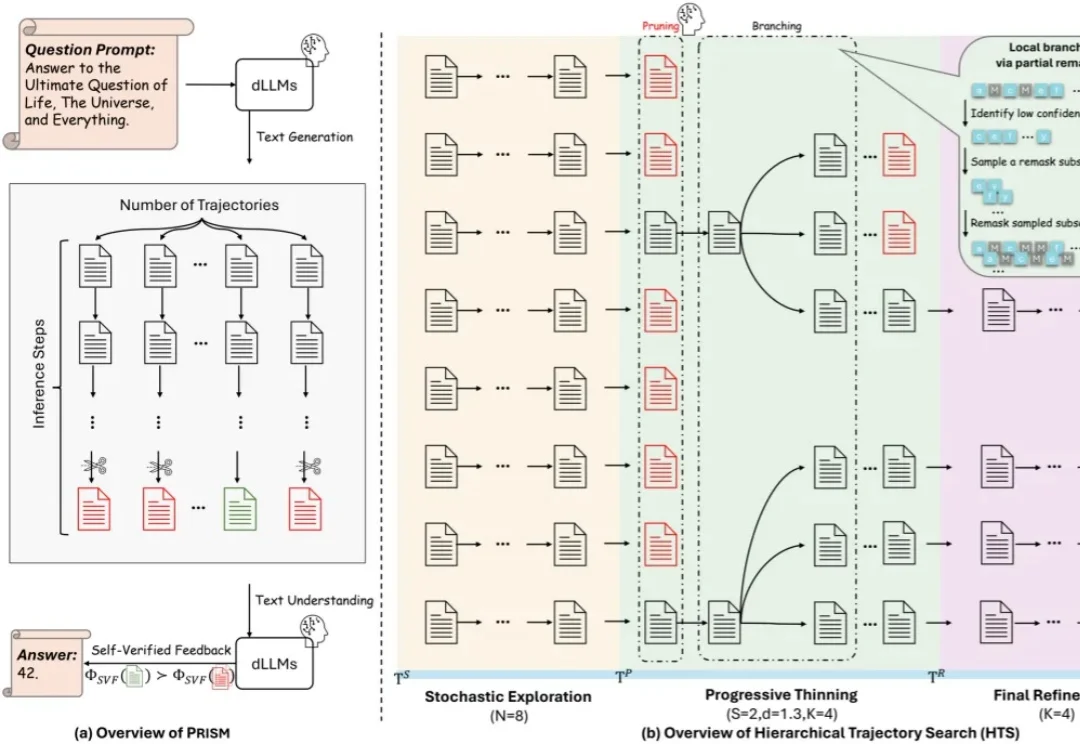
近年来,大模型能力提升的焦点正在从「训练时扩展」转向「推理时扩展」。从 Best-of-N、Self-Consistency 到更复杂的搜索与验证框架,Test-Time Scaling 已经成为提升大模型复杂推理能力的重要范式。
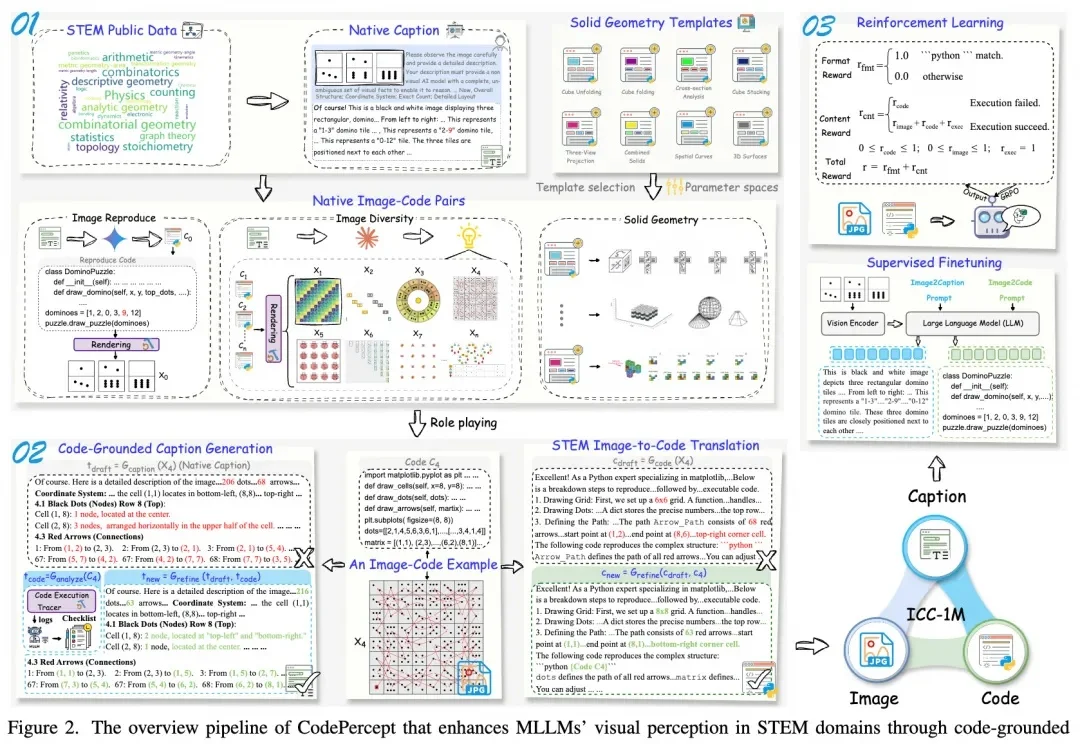
当多模态大语言模型(MLLMs)在面对科学、技术、工程和数学(STEM)领域的视觉推理题时频频「翻车」,一个根本性的问题摆在了所有研究者面前:大模型做不出理科题,究竟是因为「脑子笨」(推理能力受限),还是因为「眼神差」(视觉感知缺陷)?
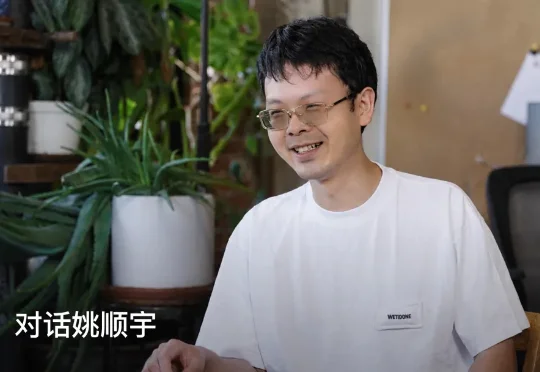
他人生最大的一次跨步是博士毕业,毅然决然离开深造9年的物理,来到崭新的AI行业。过去两年,他先后在Anthropic和Google DeepMind出任研究科学家,参与了Claude 3.7、4.5、Gemini 3等关键模型的开发过程。
飞拓星驰(FitX AI)宣布完成数百万美金融资,由日初资本领投,光点资本跟投。这笔融资将用于Fit-OS空间智能 Agent 平台的研发,以及首款客厅 AI Native 终端的量产准备——预计 2027 年 CES 全球首发。
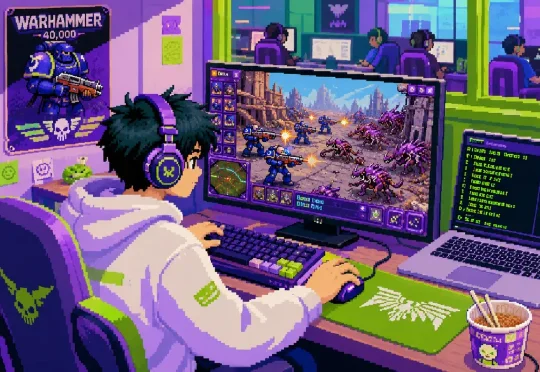
Slock是一个号称AI版Slack的AI群聊。基本形态是一个群聊网页,你首先要接入自己本地电脑的Agent,再把他们拉到一个群里。然后就可以像在工作群指挥人一样,指挥你的Agent们干活啦。
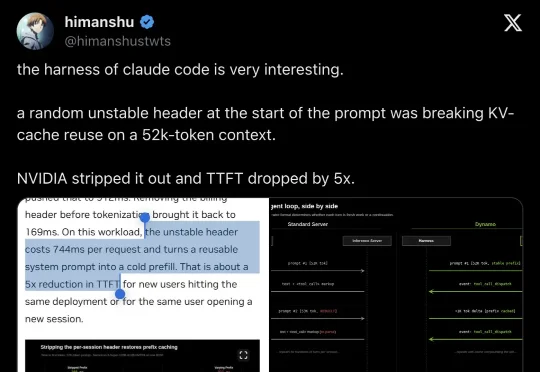
NVIDIA Dynamo 团队发现,Claude Code 向自定义端点发送请求时,prompt 最前面会带一行 session-specific billing header。这行 header 每个 session 都变,导致 52K token 的稳定前缀在 KV cache 中无法复用——TTFT 从 168ms 飙到 912ms。Dynamo 加了一个 `
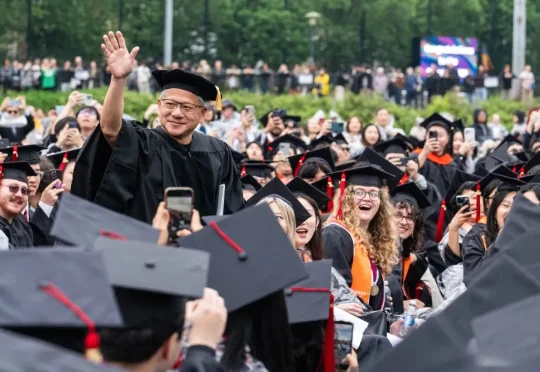
就在今天,Carnegie Mellon University(CMU:卡内基梅隆大学)2026 年毕业典礼上,身价逼近 1860 亿美元的「皮衣刀客」黄仁勋站上演讲台,接过科学与技术荣誉博士学位。
说实话,我本来觉得这种教程没必要再写了,网上一堆。但是真正用起来之后,发现如果有一篇系统快速上手指南系统,就不会卡在一些特别傻、但又没人告诉你的地方。所以这篇文章,我就结合自己的使用经验,从头给大家串一遍,写一个真正小白能用得上的上手指南。