DeepSeek-R1推理智能从哪儿来?谷歌新研究:模型内心多个角色吵翻了
DeepSeek-R1推理智能从哪儿来?谷歌新研究:模型内心多个角色吵翻了过去两年,大模型的推理能力出现了一次明显的跃迁。在数学、逻辑、多步规划等复杂任务上,推理模型如 OpenAI 的 o 系列、DeepSeek-R1、QwQ-32B,开始稳定拉开与传统指令微调模型的差距。直观来看,它们似乎只是思考得更久了:更长的 Chain-of-Thought、更高的 test-time compute,成为最常被引用的解释。
搜索
过去两年,大模型的推理能力出现了一次明显的跃迁。在数学、逻辑、多步规划等复杂任务上,推理模型如 OpenAI 的 o 系列、DeepSeek-R1、QwQ-32B,开始稳定拉开与传统指令微调模型的差距。直观来看,它们似乎只是思考得更久了:更长的 Chain-of-Thought、更高的 test-time compute,成为最常被引用的解释。
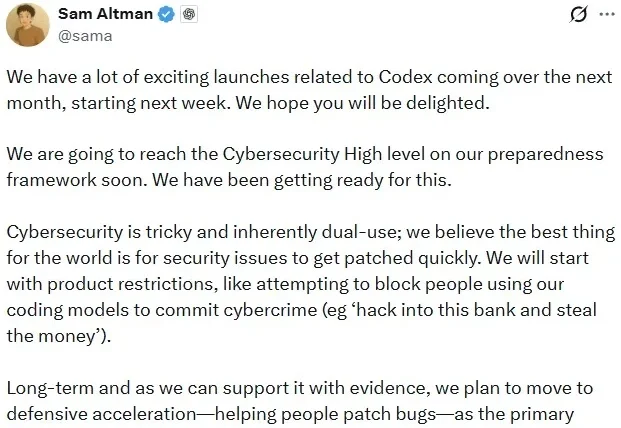
100%是用Codex写的。还有内部爆料说,Codex让他们仅用三天时间就搭出了服务器,三周就发布了APP。人类程序员,真的要退出历史舞台了?
进入到 2026 年,OpenAI 在关注消费级产品(如 ChatGPT、社交应用)之外,开始将一部分重心转向企业级市场。
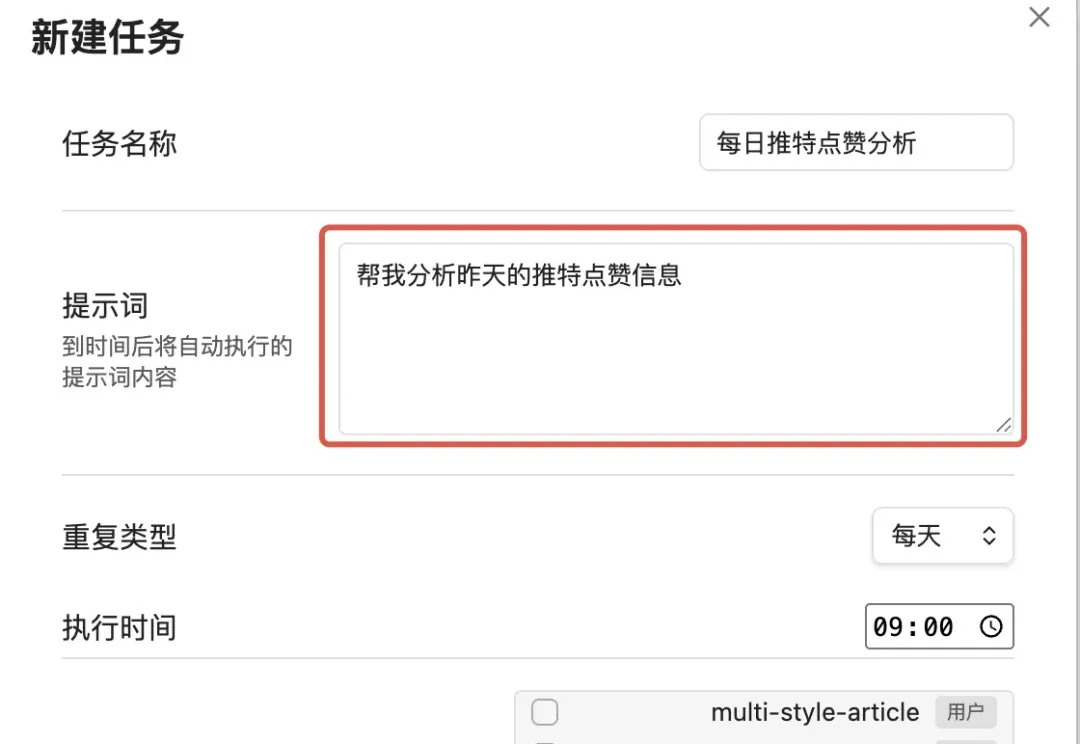
我一直有一个习惯,就每天都会刷 Twitter。倒也不是为了打发时间,而是因为在 AI 这个领域,Twitter 几乎是最前沿的信息源。新论文、新产品、行业八卦、技术突破,很多时候,等中文媒体跟进报道,已经是三五天后的事了。
嗨大家好!我是阿真! 了解我的人都知道,虽然我混得不怎么样,但是我的朋友都牛逼且靠谱,前几天藏师傅(@歸藏的AI工具箱)跟我说有个大佬有新产品要上了,这个情况我都是二话不说直接冲的。
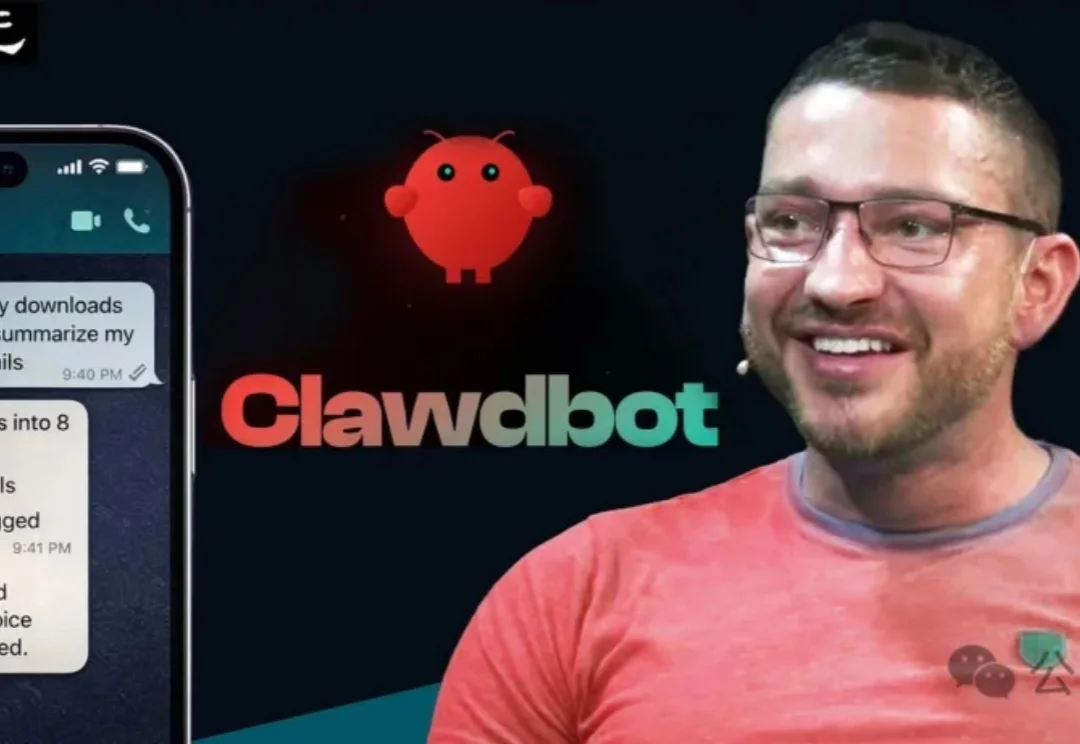
7×24h「全职AI员工」实火!退休码农造出神级Clawdbot,在硅谷红遍半边天,就连谷歌大佬也入局了。
斯坦福与英伟达联合发布重磅论文 TTT-Discover,打破「模型训练完即定型」的铁律。它让 AI 在推理阶段针对特定难题「现场长脑子」,不惜花费数百美元算力,只为求得一次打破纪录的极值。从重写数学猜想到碾压人类代码速度,这种「激进进化」正在重新定义机器发现的边界。
2026开年,OpenAI的「推理之父」Jerry Tworek离职了。顶尖大脑因方向冲突和资源倾斜而出走,从这一刻起,硅谷的「Open」或许只剩下一个名字,而非一家真正的AGI实验室。
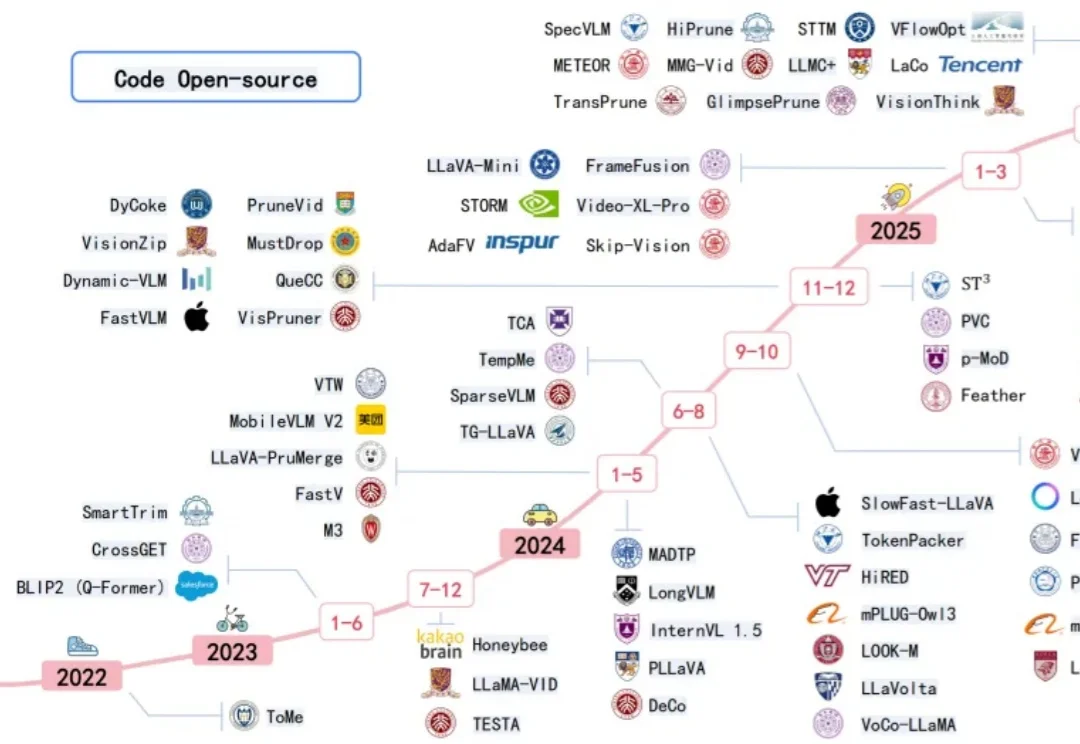
近年来多模态大模型在视觉感知,长视频问答等方面涌现出了强劲的性能,但是这种跨模态融合也带来了巨大的计算成本。高分辨率图像和长视频会产生成千上万个视觉 token ,带来极高的显存占用和延迟,限制了模型的可扩展性和本地部署。
在长期以来的 AI 研究版图中,具身智能虽然在机器人操作、自动化系统与现实应用中至关重要,却常被视为「系统工程驱动」的研究方向,鲜少被认为能够在 AI 核心建模范式上产生决定性影响。