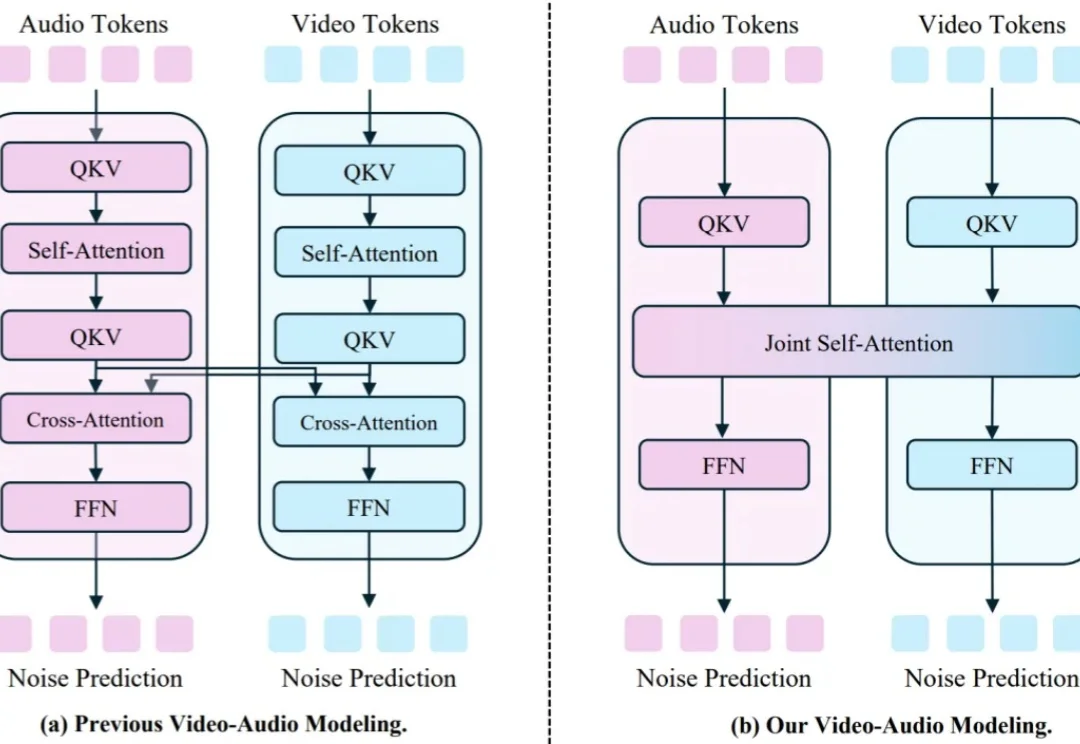
港大联合字节跳动提出JoVA: 一种基于联合自注意力的视频-音频联合生成模型
港大联合字节跳动提出JoVA: 一种基于联合自注意力的视频-音频联合生成模型视频 - 音频联合生成的研究近期在开源与闭源社区都备受关注,其中,如何生成音视频对齐的内容是研究的重点。
来自主题: AI技术研报
9339 点击 2025-12-30 10:27

 搜索
视频 - 音频联合生成的研究近期在开源与闭源社区都备受关注,其中,如何生成音视频对齐的内容是研究的重点。
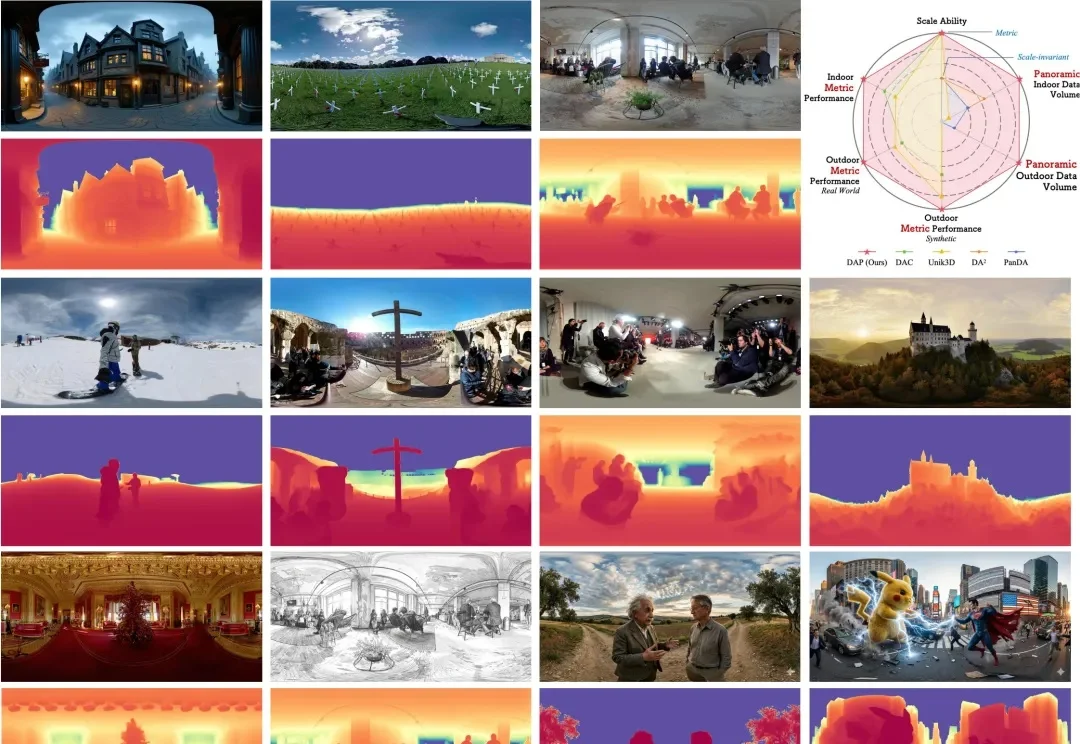
在空间智能(Spatial Intelligence)飞速发展的今天,全景视角因其 360° 的环绕覆盖能力,成为了机器人导航、自动驾驶及虚拟现实的核心基石。然而,全景深度估计长期面临 “数据荒” 与 “模型泛化差” 的瓶颈。
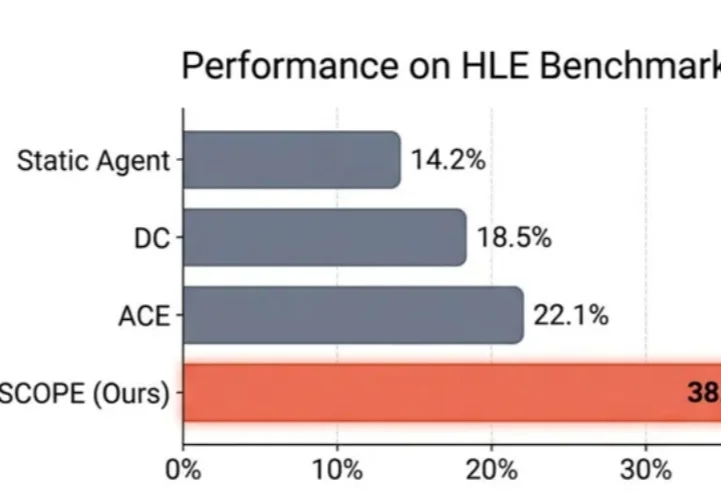
在 LLM Agent 领域,有一个常见的问题:Agent 明明 "看到了" 错误信息,却总是重蹈覆辙。
在电影与虚拟制作中,「看清一个人」从来不是看清某一帧。导演通过镜头运动与光线变化,让观众在不同视角、不同光照条件下逐步建立对一个角色的完整认知。然而,在当前大量 customizing video generation model 的研究中,这个最基本的事实,却往往被忽视。

世界模型的场景,不止在自动驾驶方面。 极客公园近期接触到的 Deep Optica,刚刚完成由 BV 百度风投、零以创投参与的种子轮融资,正试图从「判断方式」本身入手,为这一高度不确定的过程提供一种更加结构化的路径。
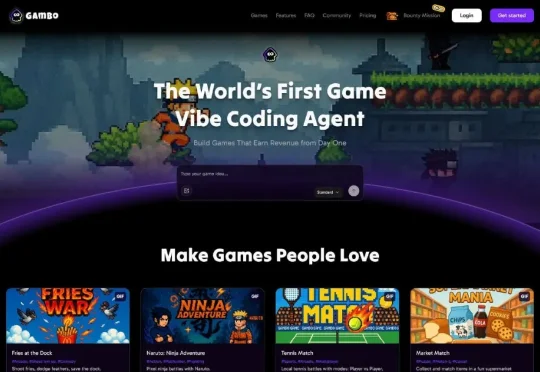
在 Gambo 里,你不需要敲代码、不需要学美术、不需要处理角色、动画、地图、音效之间的复杂关系。你只需要不断地告诉它:你要做什么类型的游戏、希望有什么机制、哪里需要改得更好玩一点。
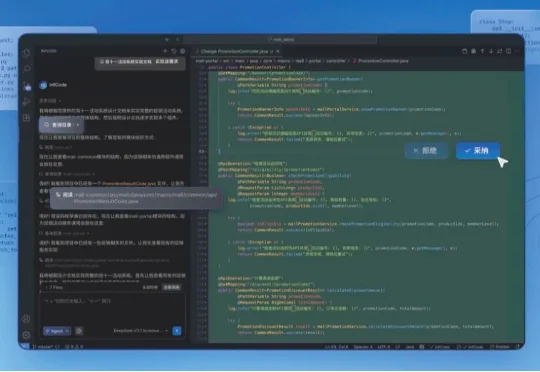
企业级场景和Vibe Coding,很大程度是相悖的。 文|邓咏仪 编辑|苏建勋 仅用半年时间,杨萍就目睹了AI Coding赛道有多疯狂。 2024年,Vibe Coding赛道发展如火如荼。Cur
惊到了!Claude Code之父 Boris Cherny 刚跟大神卡帕西友好互动了“9级大地震”的帖子,后脚就在X上放出自己过去一个月使用CC的真实生产数据:
百万年薪急招一名高管!
更多英伟达收购「TPU之父」创业公司Groq的细节曝光了—— 主打一个黄仁勋BOSS直聘。