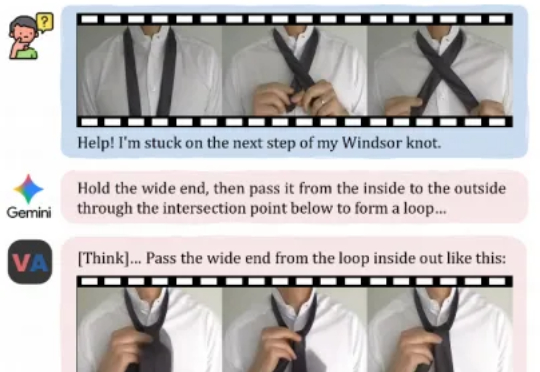
AI问答,直接「拍」给你看!来自快手可灵&香港城市大学
AI问答,直接「拍」给你看!来自快手可灵&香港城市大学今天,来自快手可灵团队和香港城市大学的研究者们,正在尝试打破这一界限。他们提出了一个全新的任务范式——「视频作为答案」,并发布了相应模型VANS。而这项工作则开创性地提出了Video-Next Event Prediction任务,要求模型直接生成一段动态视频作为回答。
来自主题: AI技术研报
9900 点击 2025-11-22 11:34

 搜索
今天,来自快手可灵团队和香港城市大学的研究者们,正在尝试打破这一界限。他们提出了一个全新的任务范式——「视频作为答案」,并发布了相应模型VANS。而这项工作则开创性地提出了Video-Next Event Prediction任务,要求模型直接生成一段动态视频作为回答。

就在一周前,全宇宙最火爆的推理框架 SGLang 官宣支持了 Diffusion 模型,好评如潮。团队成员将原本在大语言模型推理中表现突出的高性能调度与内核优化,扩展到图像与视频扩散模型上,相较于先前的视频和图像生成框架,速度提升最高可达 57%:
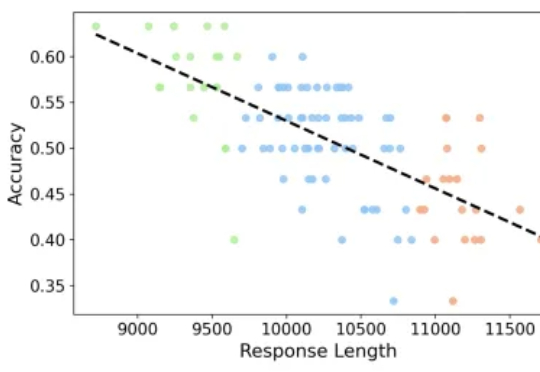
专注推理任务的 Large Reasoning Models 在数学基准上不断取得突破,但也带来了一个重要问题:越想越长、越长越错。本文解读由 JHU、UNC Charlotte 等机构团队的最新工作
前沿AI竞赛在2025年11月达到高潮。48小时内,谷歌推出Gemini 3 Pro宣称在主要推理基准测试中领先,而OpenAI立即用GPT-5.1-Codex-Max反击,这是一款专门训练用于通过创新"压缩"(compaction)技术自主工作超过24小时的专业编码模型[43]。加上Claude Sonnet 4.5已确立的编码统治地位和激进的安全过滤器,开发者面临前所未有的选择:
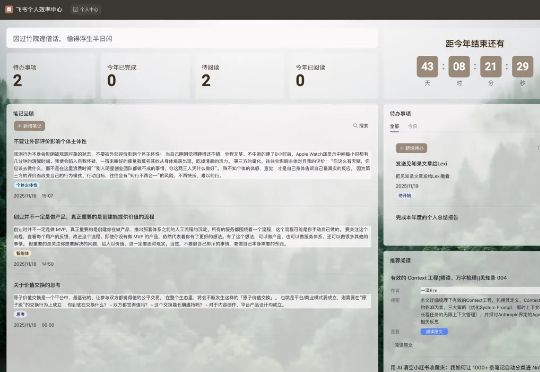
想搭一个 AI 应用,就一定要走 Coding 这条路吗? 最近我干了件事:只用了一个飞书多维表格,把一堆 AI 效率产品的事给办了。起因是飞书多维表格全面上线了新功能,「应用模式」和「AI 工作流」。
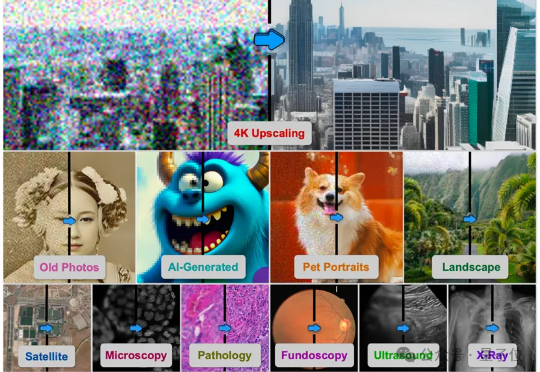
由德克萨斯A&M大学、斯坦福大学、Snap公司、CU Boulder大学、德克萨斯大学奥斯汀分校、加州理工大学、Topaz Labs以及加州大学Merced分校的研究者联合提出的基于AI智能体的方法4KAgent针对不同类型的图像以及需求对图像进行智能修复并放大到4K分辨率,带来优秀的视觉感知效果。该工作已被NeurIPS 2025接收。
AI Everywhere。 我们正进入一个万物皆 AI 的世界。 从《钢铁侠》中无所不能的助理「贾维斯」(him),到电影《她》里善解人意的情感伴侣「萨曼莎」(her),这些一度只存在于科幻中的场景
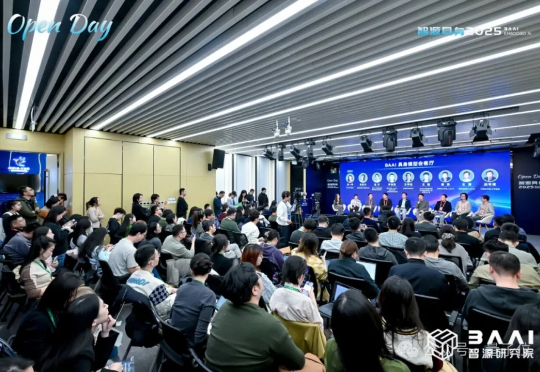
昨天,具身智能的圈子“炸”了。不是因为某家公司发布了新产品,而是因为一场“具身武林大会”—— 2025智源具身智能Open Day。现场有多火爆?这么说吧,银河通用、智元、星海图、自变量、原力灵机、加速进化、北京人形、星源智、优必选、
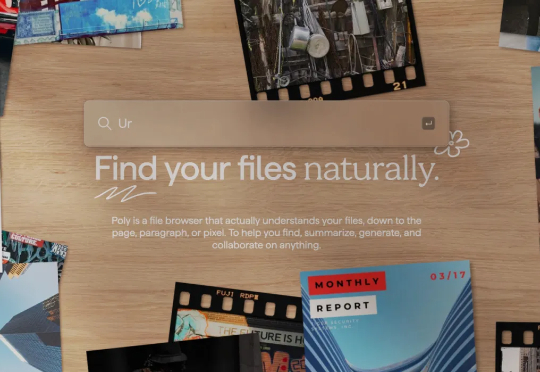
一家名为 Poly 的 YC 孵化创业公司宣布完成了 800 万美元的种子轮融资,由 Felicis 领投。这本身并不特别,但让我深感震撼的是他们想要解决的问题:彻底重新发明文件系统本身。Poly 的创始人 Abhay Agarwal 说了一句让我印象深刻的话:"在 AI 优先的世界里,文件系统本身必须进化。
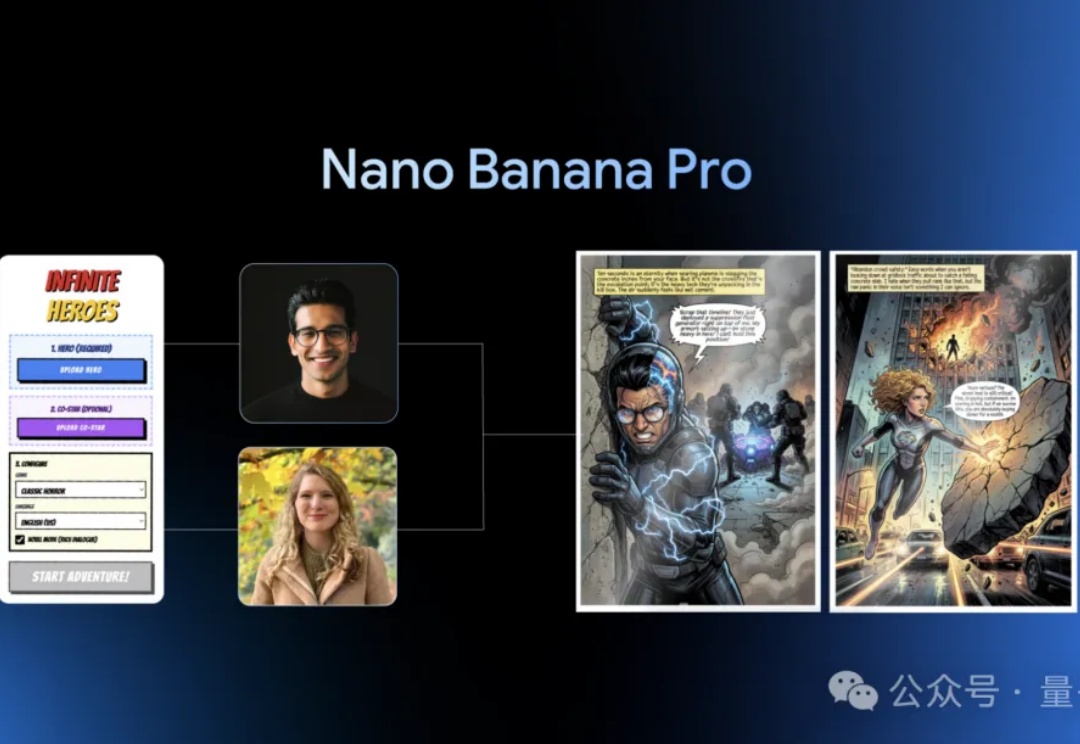
谷歌乘胜追击!Gemini 3 Pro好评如潮没两天,最强文生图模型Nano Banana也推出Pro版本。