下一代目标检测模型:3B参数MLLM Rex-Omni首度超越Grounding DINO,统一10+视觉任务
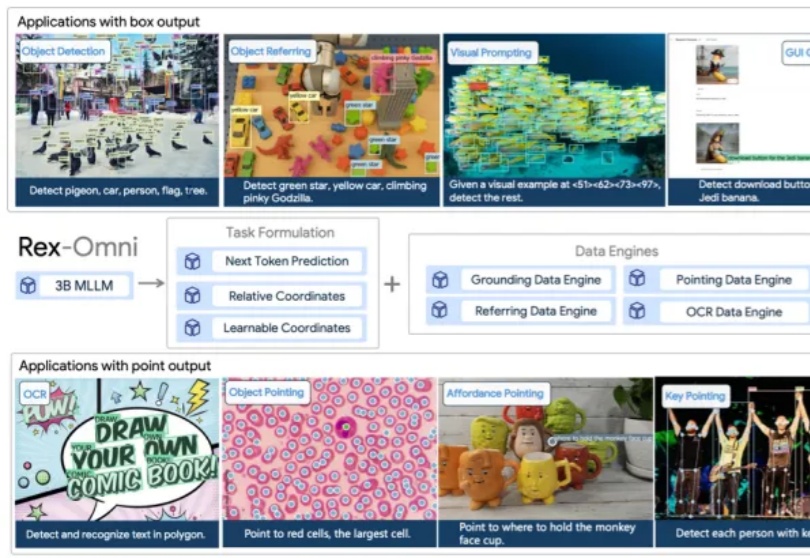
下一代目标检测模型:3B参数MLLM Rex-Omni首度超越Grounding DINO,统一10+视觉任务多模态大语言模型(MLLM)在目标定位精度上被长期诟病,难以匹敌传统的基于坐标回归的检测器。近日,来自 IDEA 研究院的团队通过仅有 3B 参数的通用视觉感知模型 Rex-Omni,打破了这一僵局。
搜索
多模态大语言模型(MLLM)在目标定位精度上被长期诟病,难以匹敌传统的基于坐标回归的检测器。近日,来自 IDEA 研究院的团队通过仅有 3B 参数的通用视觉感知模型 Rex-Omni,打破了这一僵局。
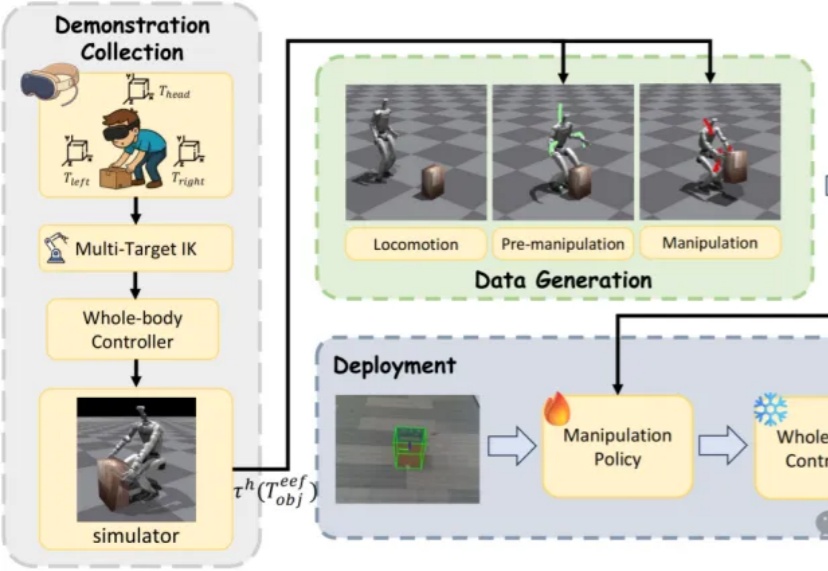
近日,来自北京大学与BeingBeyond的研究团队提出DemoHLM框架,为人形机器人移动操作(loco-manipulation)领域提供一种新思路——仅需1次仿真环境中的人类演示,即可自动生成海量训练数据,实现真实人形机器人在多任务场景下的泛化操作,有效解决了传统方法依赖硬编码、真实数据成本高、跨场景泛化差的核心痛点。
Llama4性能造假丑闻,OpenAI烧钱的速度远超过了盈利能力;另外一方面:国产模型凭借足够强大的性能与超高性价比,迅速占领了国际开源模型市场。是时候再次为国产AI鼓掌了!
谷歌DeepMind的IMO金牌模型,完整技术全公开了!
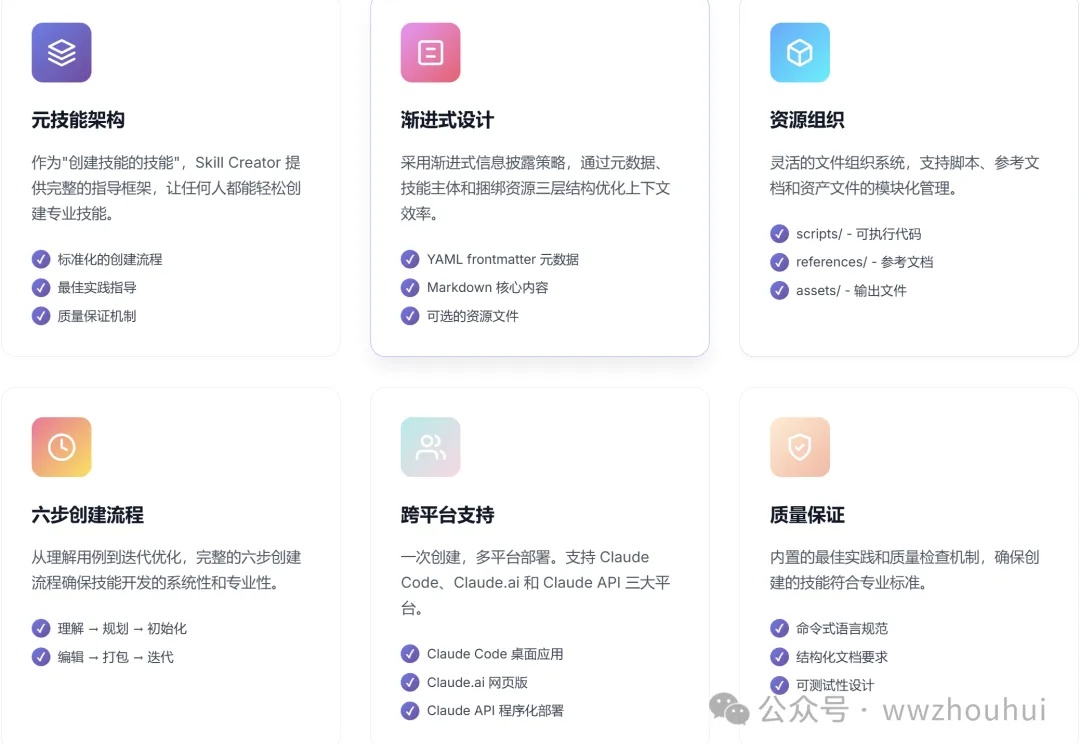
skill‑creator 是 Anthropic 在 Claude Skills 体系中提供的“元技能”。它本身是一个可直接在 Claude 对话中调用的 Skill,专门用于 帮助用户快速创建、编辑、打包其他自定义 Skill,从而让 Claude 能够在特定业务场景下拥有专业化的能力。
Anthropic 周三宣布与英国新锐云服务商 Fluidstack 达成一项雄心勃勃的数据中心合作协议,将投入 500 亿美元在美国多地建设设施以满足其不断增长的计算需求。
在这个AI生成视频泛滥的时代,我们习惯看到“AI一键出片”“模版复刻”,却少有真正能触碰商业大片质感的作品。
本文档分析 CAMEL 项目中 hybrid_browser_toolkit 的技术实现,覆盖其架构设计、核心功能与通信协议。
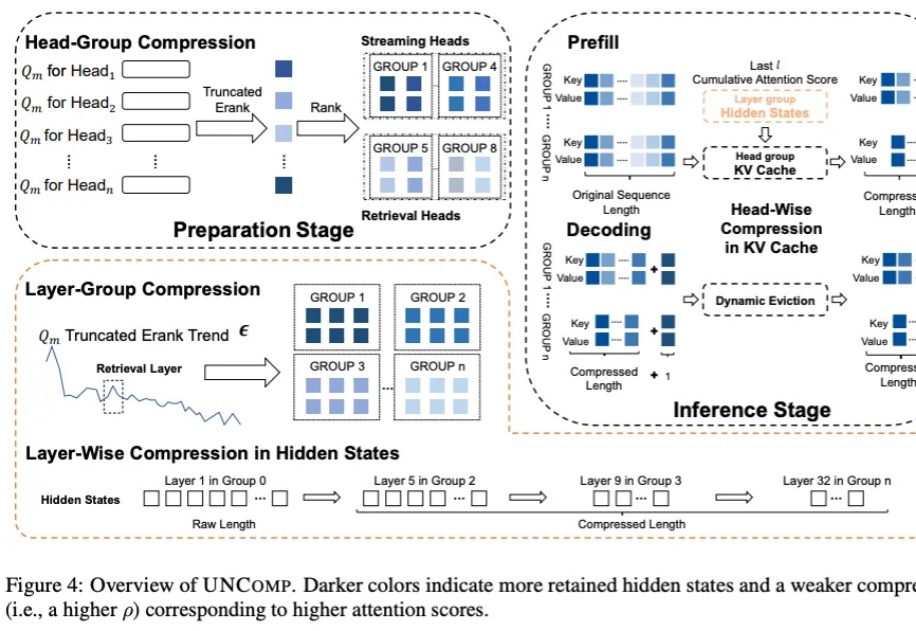
我们都知道 LLM 中存在结构化稀疏性,但其底层机制一直缺乏统一的理论解释。为什么模型越深,稀疏性越明显?为什么会出现所谓的「检索头」和「检索层」?
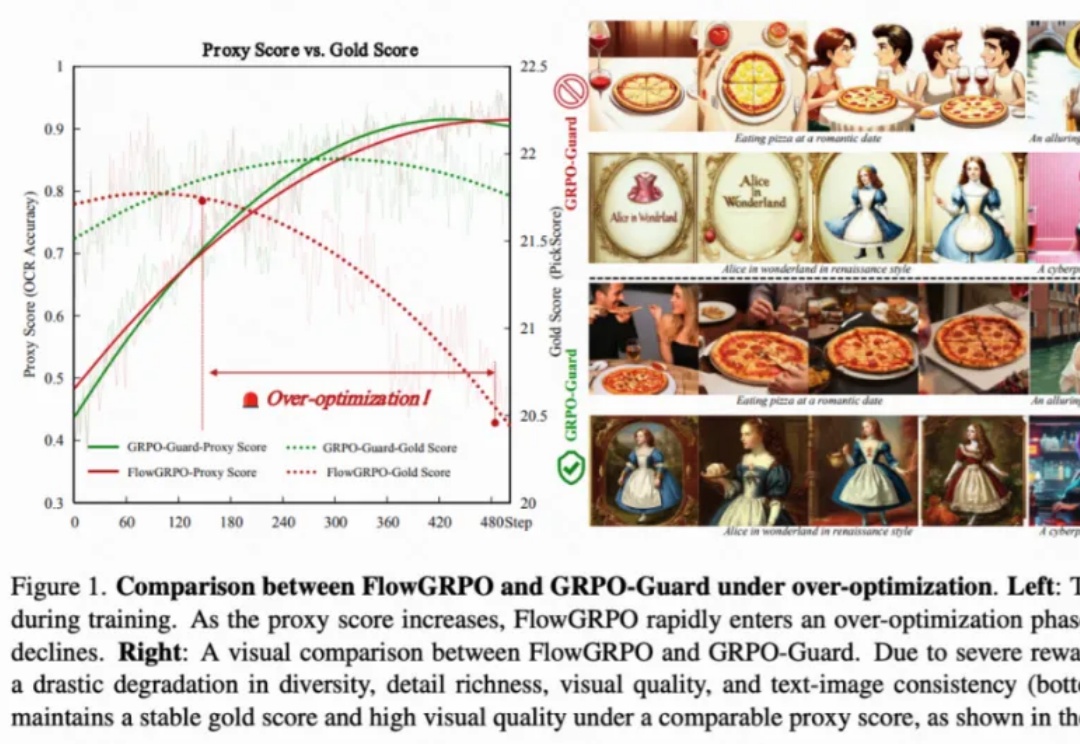
目前,GRPO 在图像和视频生成的流模型中取得了显著提升(如 FlowGRPO 和 DanceGRPO),已被证明在后训练阶段能够有效提升视觉生成式流模型的人类偏好对齐、文本渲染与指令遵循能力。