两周复刻DeepSeek-OCR!两人小团队还原低token高压缩核心,换完解码器更实用
两周复刻DeepSeek-OCR!两人小团队还原低token高压缩核心,换完解码器更实用两人小团队,仅用两周就复刻了之前被硅谷夸疯的DeepSeek-OCR?? 复刻版名叫DeepOCR,还原了原版低token高压缩的核心优势,还在关键任务上追上了原版的表现。完全开源,而且无需依赖大规模的算力集群,在两张H200上就能完成训练。
搜索
两人小团队,仅用两周就复刻了之前被硅谷夸疯的DeepSeek-OCR?? 复刻版名叫DeepOCR,还原了原版低token高压缩的核心优势,还在关键任务上追上了原版的表现。完全开源,而且无需依赖大规模的算力集群,在两张H200上就能完成训练。
Kuyda 和她的团队开始痴迷于一个比喻:当前的聊天机器人相当于 AI 界面的 MS-DOS 时代,而将会出现某种类似 Windows 或 MacOS 的时刻。Wabi不是另一个代码生成工具,也不是开发者的辅助工具,而是一个真正面向大众市场的消费产品,专为非技术人员设计。
杨红霞,是中国大模型领域一个无法绕开的名字。人们从 M6 模型(阿里达摩院发布的万亿参数 AI 大模型)开始熟知她,而她又在最近走出创业隐匿模式,正式向世界宣告自己已经是一名创业者,并希望能够做出下一
过去两年,AI靠模仿人类席卷世界。但强化学习之父Richard Sutton却说:「GenAI的时代正在结束。」他带着图灵奖的荣光,加入一家几乎没人听过的公司——ExperienceFlow.AI,他要让AI不靠人类数据喂养,而靠「经验」觉醒。
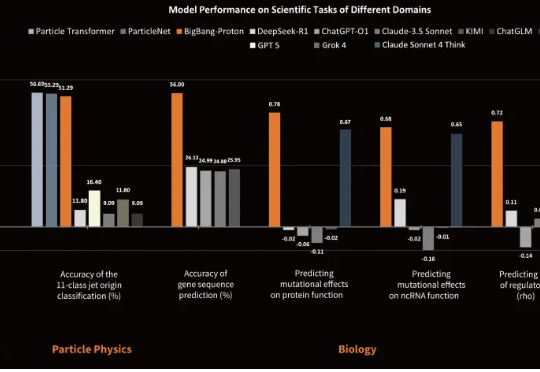
近日,专注于研发物质世界基座模型的公司超越对称(上海)技术有限公司(超对称)发布了新版基座模型 BigBang-Proton,成功实现多个真实世界的专业学科问题与 LLM 的统一预训练和推理,挑战了 Sam Altman 和主流的 AGI 技术路线。
目前,最先进的对齐方法是使用知识蒸馏(Knowledge Distillation, KD)在所有 token 上最小化 KL 散度。然而,最小化全局 KL 散度并不意味着 token 的接受率最大化。由于小模型容量受限,草稿模型往往难以完整吸收目标模型的知识,导致直接使用蒸馏方法的性能提升受限。在极限场景下,草稿模型和目标模型的巨大尺寸差异甚至可能导致训练不收敛。
AI 视频初创公司 Video Rebirth 今日宣布完成 5000 万美元的融资。本轮融资参与方阵容强大,包括全球及新加坡的头部美元基金、互联网巨头、中国及韩国老牌游戏上市公司、全球领先的芯片企业及知名家族办公室,募集资金将主要用于视频模型的持续迭代、顶尖人才招募及全球市场拓展。
AI卷走饭碗,17万大军一夜失业。别慌,Scale AI新作一锤定音:全球六大顶尖AI,现在能自动处理的事情连3%都不到。来自Scale AI和Center for AI Safety最新研究,一句话戳破了真相:虽然AI很聪明,但还不够实用。目前,AI自动化率还不到3%。值得一提的是,论文参与者中,还有Alexandr Wang本尊,曾在Scale AI期间完成的研究。
半天干完6个月的活儿,AI科学家才是真卷王。
新星闪耀!28位学者获1800万美元,华人天才齐上阵。AI2050瞄准AI普惠与安全。一文速览谷歌前CEO看好的AI方向和研究项目。