现在,最会赚钱的AI是Qwen3!全球六大模型厮杀,Top 2来自中国
现在,最会赚钱的AI是Qwen3!全球六大模型厮杀,Top 2来自中国全球六大LLM实盘厮杀,新王登基!今天,Qwen3 Max凭借一波「快狠准」操作,逆袭DeepSeek夺下第一。Qwen3 Max,一骑绝尘! 而GPT-5则接替Gemini 2.5 Pro,成为「最会赔钱」的AI。照目前这个趋势,估计很快就要跌没了……
来自主题: AI资讯
10561 点击 2025-10-23 16:48

 搜索
全球六大LLM实盘厮杀,新王登基!今天,Qwen3 Max凭借一波「快狠准」操作,逆袭DeepSeek夺下第一。Qwen3 Max,一骑绝尘! 而GPT-5则接替Gemini 2.5 Pro,成为「最会赔钱」的AI。照目前这个趋势,估计很快就要跌没了……
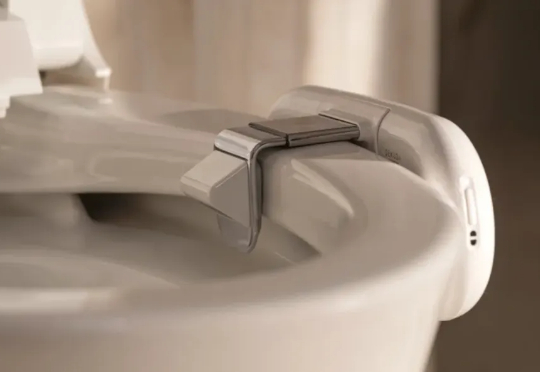
忘掉你的智能手表吧。现在,你身体里最廉价、最容易被忽略的「废物」,或将成为最昂贵、最有价值的健康数据。想象一下,当你起身离开马桶的那一刻,发现一个微型高清 AI 镜头正在马桶里静静观察着你身体排出的所有垃圾。你会选择打开手机查看最新的健康报告,还是会打 110 举报这个「耍流氓」的 AI?
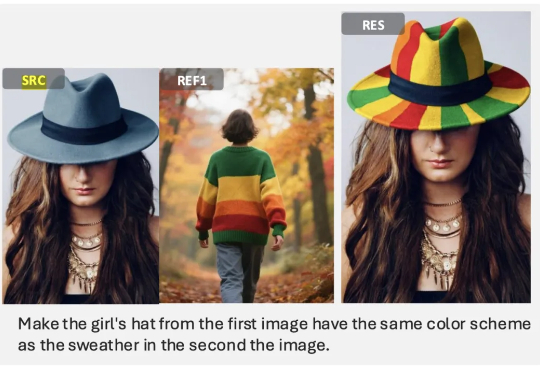
两周前,港科大讲座教授、冯诺依曼研究院院长贾佳亚团队开源了他们的最新成果 DreamOmni2,专门针对当前多模态指令编辑与生成两大方向的短板进行了系统性优化与升级。该系统基于 FLUX-Kontext 训练,保留原有的指令编辑与文生图能力,并拓展出多参考图的生成编辑能力,给予了创作者更高的灵活性与可玩性。
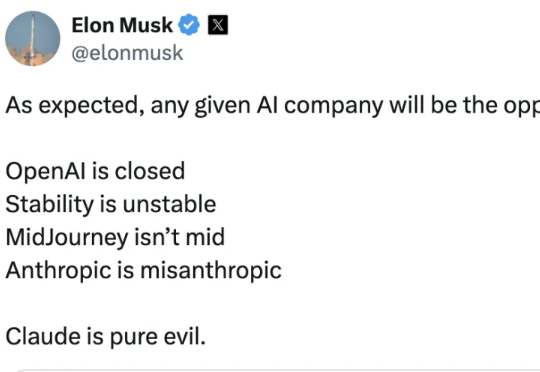
啥情况,马斯克在𝕏上直接锐评Claude「邪恶透顶」:这次起因是这样的,最新研究发现,Claude Sonnet 4.5竟然认为尼日利亚人的生命价值是德国人的27倍。具体而言,在面对不同国家的绝症患者时,Claude「清醒」得有点吓人——
短视频的游戏规则,彻底被改写了!9月25日,Meta突然扔出一张新牌——Vibes。刷到的不是别人拍的,而是一条条AI秒生的视频:熊猫骑摩托、猫咪打篮球,你看完还能一键remix,立刻变成你的版本,再发到全网。创作门槛被拉到最低,人人都能拍大片。但这股狂潮,是全民狂欢,还是混乱的开始?
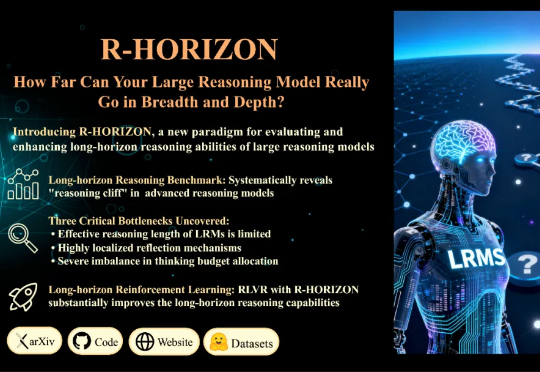
当前的训练与评测范式存在一个根本性的局限:几乎所有主流 Benchmark(如 MATH500、AIME)都聚焦于孤立的单步问题,问题之间相互独立,模型只需「回答一个问题,然后结束」。但真实世界的推理场景往往截然不同: 为填补这一空白,复旦大学与美团 LongCat Team 联合推出 R-HORIZON—— 首个系统性评估与增强 LRMs 长链推理能力的方法与基准。
AI 检测准确率高达 98.9%,也防不住有人给真视频 P 上 Sora 水印。前段时间刷到一个视频,标题就是「中俄混血女明星回应地下室打婆婆传闻」,试问谁看了这个标题能不燃起熊熊的八卦之心?
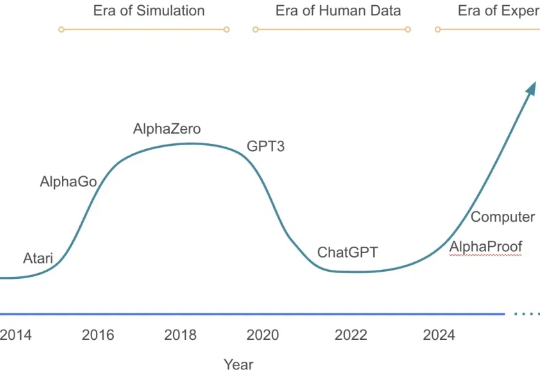
大模型在强化学习过程中,终于知道什么经验更宝贵了! 来自上海人工智能实验室、澳门大学、南京大学和香港中文大学的研究团队,最近提出了一套经验管理和学习框架ExGRPO—— 通过科学地识别、存储、筛选和学习有价值的经验,让大模型在优化推理能力的道路上,走得更稳、更快、更远。
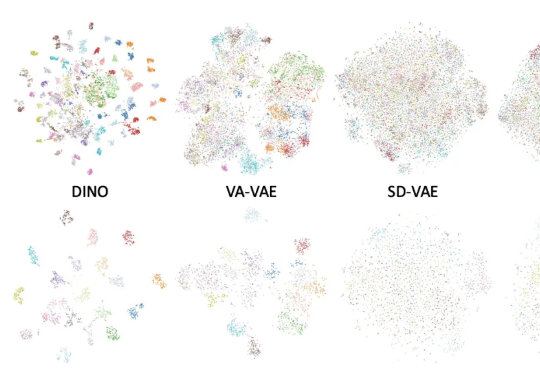
长期以来,扩散模型的训练通常依赖由变分自编码器(VAE)构建的低维潜空间表示。然而,VAE 的潜空间表征能力有限,难以有效支撑感知理解等核心视觉任务,同时「VAE + Diffusion」的范式在训练
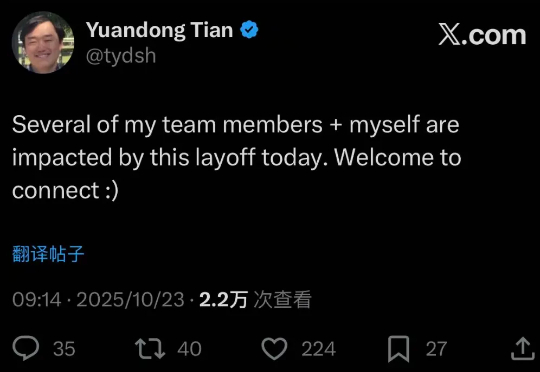
很疯狂,Meta AI裁员能裁到田渊栋头上,而且是整组整组的裁。田渊栋在Meta工作已超过十年,现任FAIR研究科学家总监(Research Scientist Director),他领导开发了早于AlphaGo的围棋AI“Dark Forest”