
RL新思路!复旦用游戏增强VLM通用推理,性能匹敌几何数据
RL新思路!复旦用游戏增强VLM通用推理,性能匹敌几何数据复旦大学NLP实验室研发Game-RL,利用游戏丰富视觉元素和明确规则生成多模态可验证推理数据,通过强化训练提升视觉语言模型的推理能力。创新性地提出Code2Logic方法,系统化合成游戏任务数据,构建GameQA数据集,验证了游戏数据在复杂推理训练中的优势。
来自主题: AI技术研报
10372 点击 2025-10-21 10:05

 搜索
复旦大学NLP实验室研发Game-RL,利用游戏丰富视觉元素和明确规则生成多模态可验证推理数据,通过强化训练提升视觉语言模型的推理能力。创新性地提出Code2Logic方法,系统化合成游戏任务数据,构建GameQA数据集,验证了游戏数据在复杂推理训练中的优势。
今天凌晨,Anthropic 上线了「Claude Code on the web」(即网页版 Claude Code)功能,这种全新的方式可以让用户直接从浏览器中委派编程任务。目前,网页版 Claude Code 处于 Beta 阶段,作为研究预览版向 Pro 和 Max 用户开放使用。
C.ai 之后,AI 陪伴还可能长出怎样的新物种?前 B 站副总裁刘斌新选择了一条非共识路线——从游戏陪伴切入,打造「逗逗游戏伙伴」。目前「逗逗游戏伙伴」已经拿下千万用户、月活突破 200 万,成为 AI 陪伴赛道里的另类黑马,如今,它正以「Hakko AI」之名加速出海。
刚刚,DeepSeek 推出了全新的视觉文本压缩模型 DeepSeek-OCR。 该模型最大的突破在于极高的压缩效率: 20 个节点每天可处理 3300 万页数据,硬件要求仅为 A100-40G。
美国麻省理工学院李巨团队在国际顶尖学术期刊Nature上发表了一篇研究论文,展示了一种多模态机器人平台CRESt(Copilot for Real-world Experimental Scientists),通过将多模态模型(融合文本知识、化学成分以及微观结构信息)驱动的材料设计与高通量自动化实验相结合,大幅提升催化剂的研发速度和质量。
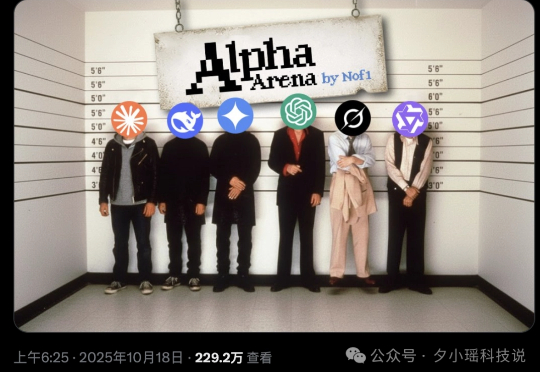
这世上有太多 AI benchmark 了,但没有一个 benchmark 能让你心跳加速。 直到近日,AlphaArena 出现了。 这是由初创团队 NOF1 推出的一个「AI 炒币实盘竞技场」,现在已开放全网围观:竞技场地址:https://nof1.ai/
在某种程度上,GPT-5可以被视作是o3.1。 该观点出自OpenAI研究副总裁Jerry Tworek的首次播客采访,而Jerry其人,正是o1模型的主导者之一。
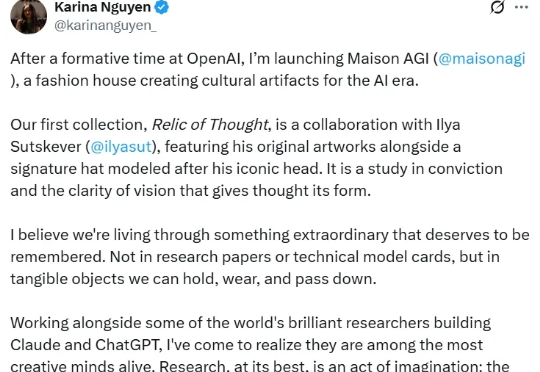
前OpenAI研究员Karina Nguyen宣布创立时尚品牌Maison AGI,首个系列就前OpenAI研究员Karina Nguyen宣布创立时尚品牌Maison AGI,首个系列就与Ilya Sutskever合作,甚至要推出一顶以他头型为原型的帽子。她称,这可能是人类在被AI超越前,最后一次「手作」。当科学家成了灵感缪斯,研究员开始做纪念品,AI的故事,正从技术革命变成人类的自我信仰。
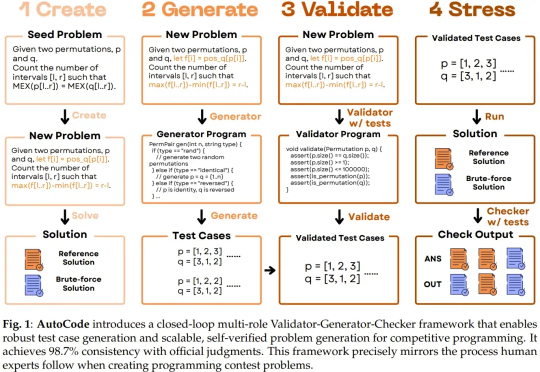
随着大型语言模型(LLM)朝着通用能力迈进,并以通用人工智能(AGI)为最终目标,测试其生成问题的能力也正变得越来越重要。尤其是在将 LLM 应用于高级编程任务时,因为未来 LLM 编程能力的发展和经济整合将需要大量的验证工作。
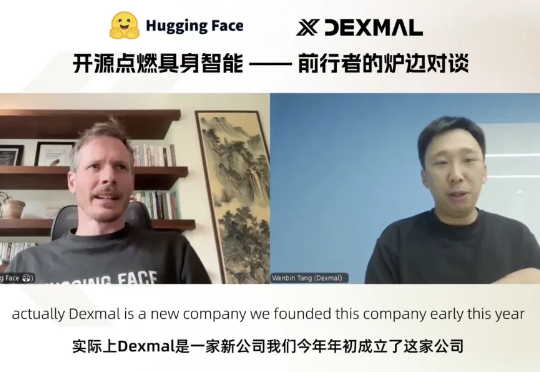
“很多模型在模拟器里完美运行,但一到现实就彻底失灵。” 在最新一次线上对谈中,Dexmal联合创始人唐文斌与Hugging Face联合创始人Thomas Wolf指出了当前机器人研究的最大痛点。