AI资讯新闻榜单内容搜索-o

AITNT-国内领先的一站式人工智能新闻资讯网站
# 热门搜索 #
搜索: o
谷歌领投2000万美金,OpenAI、DeepMind天使投资人也集体下注:这家公司要做AI时代的"通用集成层"

谷歌领投2000万美金,OpenAI、DeepMind天使投资人也集体下注:这家公司要做AI时代的"通用集成层"

谷歌领投2000万美金,OpenAI、DeepMind天使投资人也集体下注:这家公司要做AI时代的"通用集成层"

我最近深入研究了一家名为 StackOne 的伦敦创业公司,他们刚刚完成了由 GV(Google Ventures)领投的 2000 万美元 A 轮融资,这不仅仅是一个简单的融资消息,而是整个企业软件生态系统即将迎来根本性变革的信号。

来自主题: AI资讯
9551 点击    2025-08-13 17:41
首尔AI标注公司获1.2亿融资,无代码神器叫板硅谷巨头!AI安全战争正式打响

首尔AI标注公司获1.2亿融资,无代码神器叫板硅谷巨头!AI安全战争正式打响

首尔AI标注公司获1.2亿融资,无代码神器叫板硅谷巨头!AI安全战争正式打响

一面是Meta豪掷143亿美元下注Scale AI,一面是OpenAI紧急切断合作——当全球目光聚焦硅谷之时,一家藏身首尔的初创公司悄然撕开了AI安全市场的裂口。

来自主题: AI资讯
10095 点击    2025-08-13 17:18
6秒造一个「视频博主」,Pika让一切图片开口说话

6秒造一个「视频博主」,Pika让一切图片开口说话

6秒造一个「视频博主」,Pika让一切图片开口说话

制作一个视频需要几步?可以简单概括为:拍摄 + 配音 + 剪辑。 还记得 veo3 发布时引起的轰动吗?「音画同步」功能的革命性直接把其他视频生成模型按在地上摩擦,拍摄 + 配音 + 粗剪一键搞定。

来自主题: AI资讯
9758 点击    2025-08-13 16:59
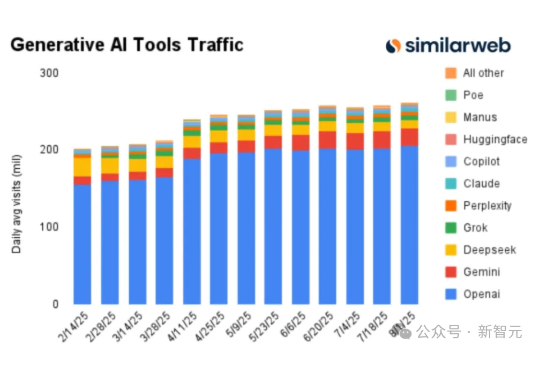
倒反天罡!AI新贵345亿美元报价谷歌浏览器,此前碰瓷Tiktok未果

倒反天罡!AI新贵345亿美元报价谷歌浏览器,此前碰瓷Tiktok未果

倒反天罡!AI新贵345亿美元报价谷歌浏览器,此前碰瓷Tiktok未果

AI应用又爆出大冷门事件。 成立仅三年的AI初创公司Perplexity正式向谷歌发出收购要约,计划以345亿美元全现金形式收购Chrome浏览器业务。

来自主题: AI资讯
10411 点击    2025-08-13 16:33
研究者警告:强化学习暗藏「策略悬崖」危机,AI对齐的根本性挑战浮现

研究者警告:强化学习暗藏「策略悬崖」危机,AI对齐的根本性挑战浮现

研究者警告:强化学习暗藏「策略悬崖」危机,AI对齐的根本性挑战浮现

强化学习(RL)是锻造当今顶尖大模型(如 OpenAI o 系列、DeepSeek-R1、Gemini 2.5、Grok 4、GPT-5)推理能力与对齐的核心 “武器”,但它也像一把双刃剑,常常导致模型行为脆弱、风格突变,甚至出现 “欺骗性对齐”、“失控” 等危险倾向。

来自主题: AI技术研报
10076 点击    2025-08-13 16:29
奥特曼公然叫板马斯克!重金杀入脑机接口,硅谷两大巨头彻底决裂

奥特曼公然叫板马斯克!重金杀入脑机接口,硅谷两大巨头彻底决裂

奥特曼公然叫板马斯克!重金杀入脑机接口,硅谷两大巨头彻底决裂

战火升级!马斯克还在X上和奥特曼口水战,奥特曼反手就密谋支持一家脑机接口公司,与马斯克的Neuralink正面对决。这场关乎人类未来的科技战争,已经从AI蔓延到了你的大脑!

来自主题: AI资讯
9125 点击    2025-08-13 16:24
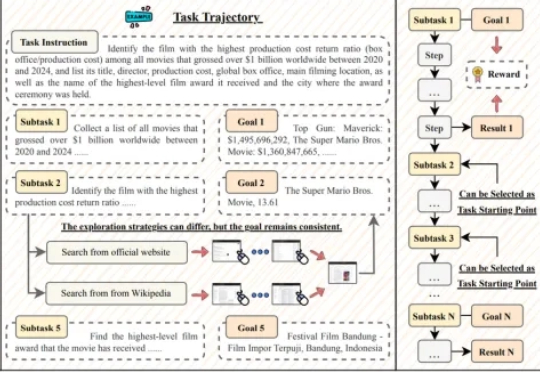
o3 Gemini 都翻车?首个可验证长链 GUI 数据集 VeriGUI 重磅开源,探索通用 Agent 能力边界

o3 Gemini 都翻车?首个可验证长链 GUI 数据集 VeriGUI 重磅开源,探索通用 Agent 能力边界

o3 Gemini 都翻车?首个可验证长链 GUI 数据集 VeriGUI 重磅开源,探索通用 Agent 能力边界

GUI 智能体正以前所未有的速度崛起,有望彻底改变人机交互的方式。然而,这一领域的进展正面临瓶颈:现有数据集大多聚焦于 10 步以内的短程交互,且仅验证最终结果,无法有效评估和训练智能体在真实世界中的长时程规划与执行能力。

来自主题: AI资讯
9393 点击    2025-08-13 16:17
大模型训练新突破!“不对称”训练让AI学会自我反思,推理零开销

大模型训练新突破!“不对称”训练让AI学会自我反思,推理零开销

大模型训练新突破!“不对称”训练让AI学会自我反思,推理零开销

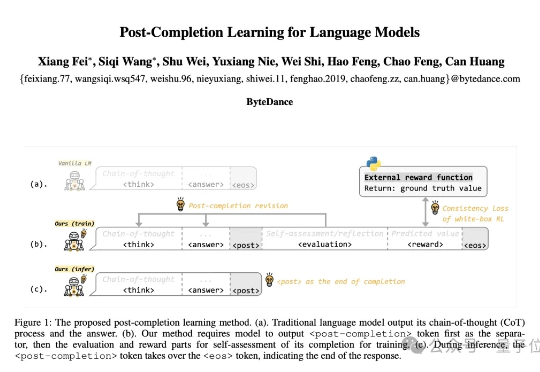
首次实现“训练-推理不对称”,字节团队提出全新的语言模型训练方法:Post-Completion Learning (PCL)。 在训练时让模型对自己的输出结果进行反思和评估,推理时却仅输出答案,将反思能力完全内化。

来自主题: AI资讯
8533 点击    2025-08-13 16:10
大型语言模型稳定强化学习的新路径:几何平均策略优化GMPO

大型语言模型稳定强化学习的新路径:几何平均策略优化GMPO

大型语言模型稳定强化学习的新路径:几何平均策略优化GMPO

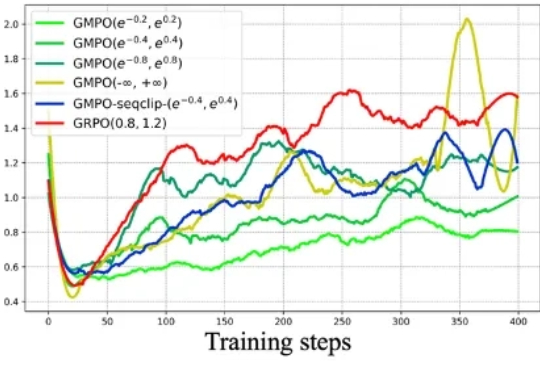
近年来,强化学习(RL)在大型语言模型(LLM)的微调过程中,尤其是在推理能力提升方面,取得了显著的成效。传统的强化学习方法,如近端策略优化(Proximal Policy Optimization,PPO)及其变种,包括组相对策略优化(Group Relative Policy Optimization,GRPO),在处理复杂推理任务时表现出了强大的潜力。

来自主题: AI技术研报
8591 点击    2025-08-13 16:03
Artificial Analysis 重磅发布《2025年Q2中国AI现状报告》:中国与美国差距已从一年缩短至3个月

Artificial Analysis 重磅发布《2025年Q2中国AI现状报告》:中国与美国差距已从一年缩短至3个月

Artificial Analysis 重磅发布《2025年Q2中国AI现状报告》:中国与美国差距已从一年缩短至3个月

Artificial Analysis 最近发布了《State of AI: China Q2 2025 Highlights Report》(2025年Q2 中国人工智能现状分析报告),聚焦中国 AI 发展现状。

来自主题: AI技术研报
13316 点击    2025-08-13 15:57