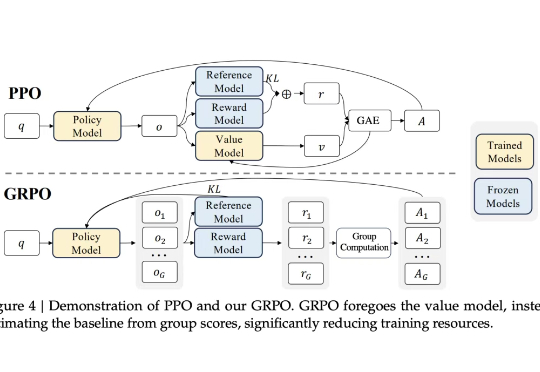
DeepSeek的GRPO会导致模型崩溃?看下Qwen3新范式GSPO
DeepSeek的GRPO会导致模型崩溃?看下Qwen3新范式GSPO众所周知,大型语言模型的训练通常分为两个阶段。第一阶段是「预训练」,开发者利用大规模文本数据集训练模型,让它学会预测句子中的下一个词。第二阶段是「后训练」,旨在教会模型如何更好地理解和执行人类指令。
来自主题: AI技术研报
10540 点击 2025-08-08 11:22

 搜索
众所周知,大型语言模型的训练通常分为两个阶段。第一阶段是「预训练」,开发者利用大规模文本数据集训练模型,让它学会预测句子中的下一个词。第二阶段是「后训练」,旨在教会模型如何更好地理解和执行人类指令。
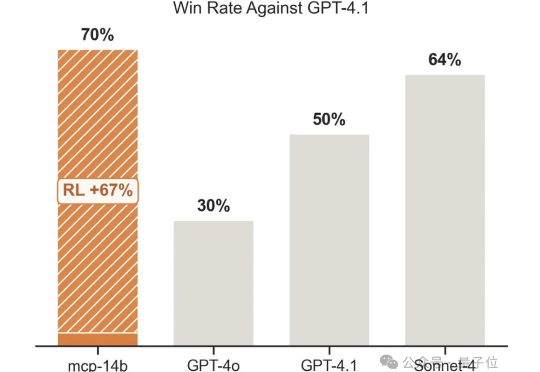
强化学习+任意一张牌,往往就是王炸。专注于LLM+RL的科技公司OpenPipe提出全新开源强化学习框架——MCP·RL。
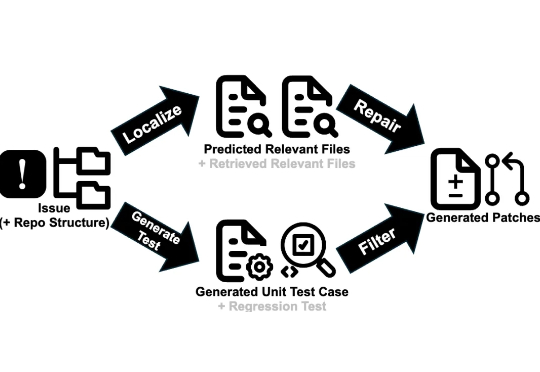
近日,一项由北京大学、字节跳动 Seed 团队及香港大学联合进行的研究,提出了一种名为「SWE-Swiss」的完整「配方」,旨在高效训练用于解决软件工程问题的 AI 模型。研究团队推出的 32B 参数模型 SWE-Swiss-32B,在权威基准 SWE-bench Verified 上取得了 60.2% 的准确率,在同尺寸级别中达到了新的 SOTA。

凌晨1点,在万众瞩目的境况下,OpenAI的直播正式开始。GPT-5,终于来了。
一个半小时之前,Ghat GPT 5,千呼万唤始出来,然后端了许多公司。刚刚研读了 GPT5 完整技术文档,先分享一下技术细节。刚刚研读了 GPT5 完整技术文档,先分享一下技术细节。
FlowSpeech的开发初衷源于一个感人故事。一位年过八旬的美国老人因长期病痛失去说话能力,但通过AI工具ListenHub继续与他人分享自己的人生经历。这个真实案例启发了开发团队,促使他们研发出专门针对书面语向口语转换的TTS技术解决方案。
AI药物研发领域,又一家黑马公司诞生了!就在今天,AI制药公司Chai Discovery宣布完成7000万美元(约合人民币5亿元)的A轮融资。就在今天,AI制药公司Chai Discovery宣布完成7000万美元(约合人民币5亿元)的A轮融资。

被挖怕了!保密员工名字还不够,奥特曼为“防挖”又出新招—— 开启新一期员工期权兑现计划,按照5000亿美元的估值来兑现。 股权变钞票!这下人才总能留住一部分了吧。
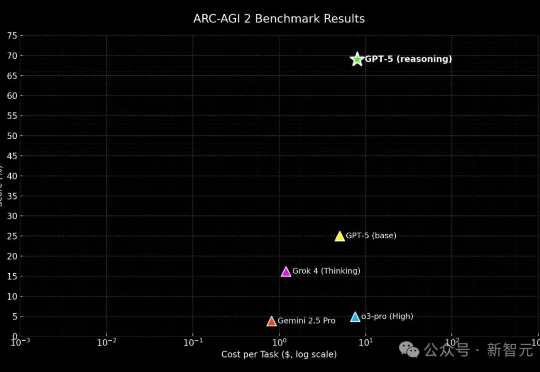
GPT-5终于要来了,就在刚刚,已经有人通过Copilot放出了GPT-5的惊人实测,推理能力强到离谱。明天凌晨,GPT-5、GPT-5 Mini和GPT-5 Nano全家桶将悉数登场,全网已经high起来了。
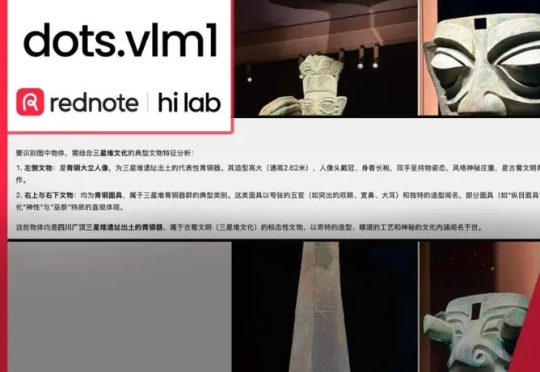
擅长「种草」的小红书正加大技术自研力度,两个月内接连开源三款模型!最新开源的首个多模态大模型dots.vlm1,基于自研视觉编码器构建,实测看穿色盲图,破解数独,解高考数学题,一句话写李白诗风,视觉理解和推理能力都逼近Gemini 2.5 Pro闭源模型。