一张图生成任意场景3D模型,部分遮挡也不怕|IDEA x 光影焕像联合开源
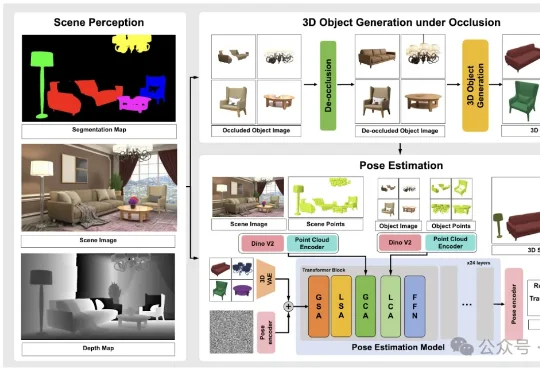
一张图生成任意场景3D模型,部分遮挡也不怕|IDEA x 光影焕像联合开源IDEA研究院张磊团队与香港科技大学谭平团队联合推出SceneMaker框架,有望攻克这一问题。 它以视启未来的万物检测模型DINO-X与光影焕像的万物3D生成模型Triverse为基础,实现了从任意开放世界图像(室内/室外/合成图等)到带Mesh的3D场景的完整重建。
搜索
IDEA研究院张磊团队与香港科技大学谭平团队联合推出SceneMaker框架,有望攻克这一问题。 它以视启未来的万物检测模型DINO-X与光影焕像的万物3D生成模型Triverse为基础,实现了从任意开放世界图像(室内/室外/合成图等)到带Mesh的3D场景的完整重建。
昨天,家里在新加坡上学的小孩在群里给我安利了一个 AI 产品。 她说得真的很坚定:“这个真的好用,我们班好多人都在用。” 我点开链接一看,名字叫 Answer AI。 第一反应其实挺真实的:不会又是拍照搜题吧?这条路在国内早就被卷烂了。作业帮、小猿搜题来回打,最后还被“双减”一脚干停了一阵子 🤣。
比如 2025 年新推出的 Botanic Atlas 项目,这是个交互式的世界植物地图,收录了超过 3 万种植物的标本,我们可以在地图上看到它们分布在哪儿,还能了解相关知识。
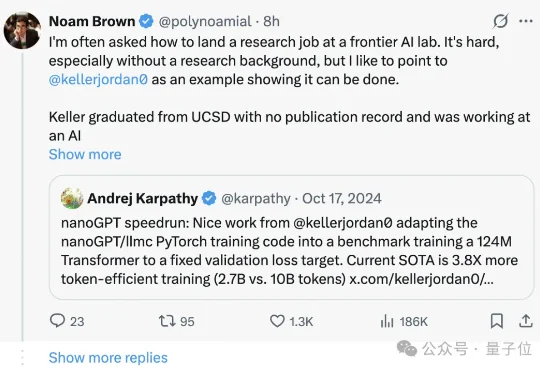
如果没有PhD,是不是就和前沿AI研究没关系了?至少在Noam Brown看来,未必。这位OpenAI 研究员、o1的核心贡献者,刚刚分享了一串“非典型研究员”的经历。
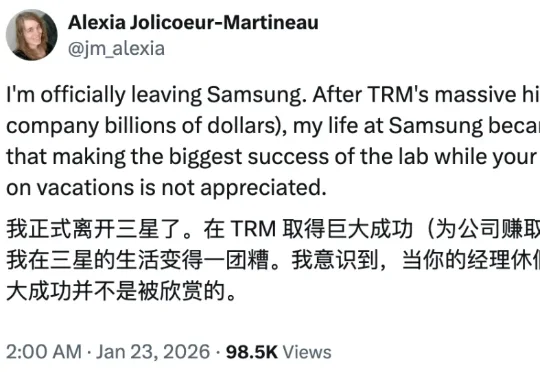
还记得三个月前,来自三星的一位研究员的独作论文发布即爆火,颠覆了递归推理模型架构,让一个仅包含 700 万个参数的网络,性能比肩甚至超越 o3-mini 和 Gemini 2.5 Pro 等尖端语言模型,震惊了大量业内研究人士。
2026年1月,前OpenAI CTO Mira Murati创办的明星公司Thinking Machines Lab遭遇「灭顶之灾」:联合创始人Barret Zoph因办公室恋情丑闻被降职后心生不满,联合另外两名核心骨干向Mira逼宫索权,遭拒后被当场开除。然而仅不到一小时,三人便集体叛逃回OpenAI,在老东家的迎接下风光回朝。
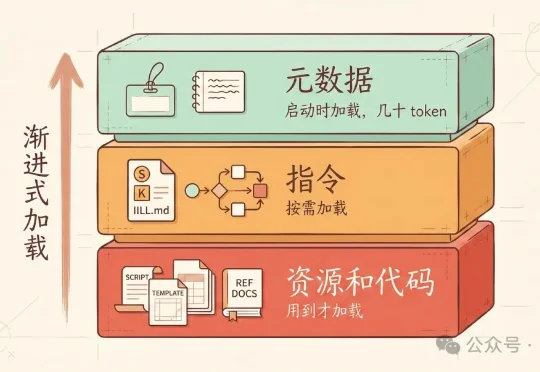
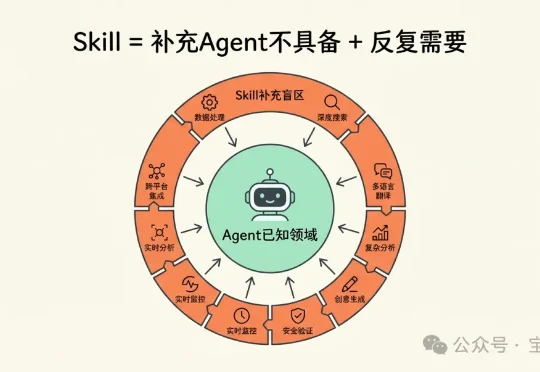
上篇文章别把整个 GitHub 装进 Skills,Skills 的正确用法发出去后,收到一些质疑:“说 skill 能做配图 prompt 不行。本来 skill 就是加载 md,没 skill 之前我们用 prompt 模板照样也是能做流程编排。” “现在大部分 skill 不就是长一点的提示词吗?为什么说'单纯靠提示词做不了'?”
这篇《Skills 的最正确用法,是将整个 Github 压缩成你自己的超级技能库》绝对是一篇绝佳的入门指南,但也要注意:这种用法,还当不起“最”正确用法。 我不是来抬杠的,而是想聊聊:怎么更好地使用
真没想到,MiniMax Agent 居然赶在春节前又放了个大招!MiniMax 桌面端 + 专家模式同步上线!说实话,MiniMax 这迭代效率着实太高了,追的我测评都有点肝不动了
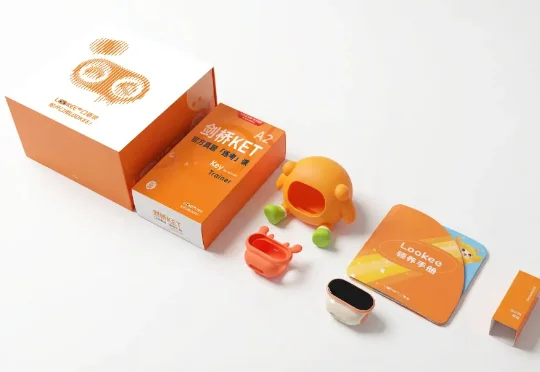
LOOKEE口语侠以无屏陪伴形态,重点切入6-12岁儿童的口语学习场景。无屏化的优势不仅是保护视力,它更通过移除视觉依赖,迫使孩童回归“听”与“说”的语言本质,在纯粹的音频交互中理解问题并给出回应,构建内在的语言逻辑。