NeurIPS 2026|小红书 × 复旦大学用DR-Rubric为开放式强化学习构建评分标准
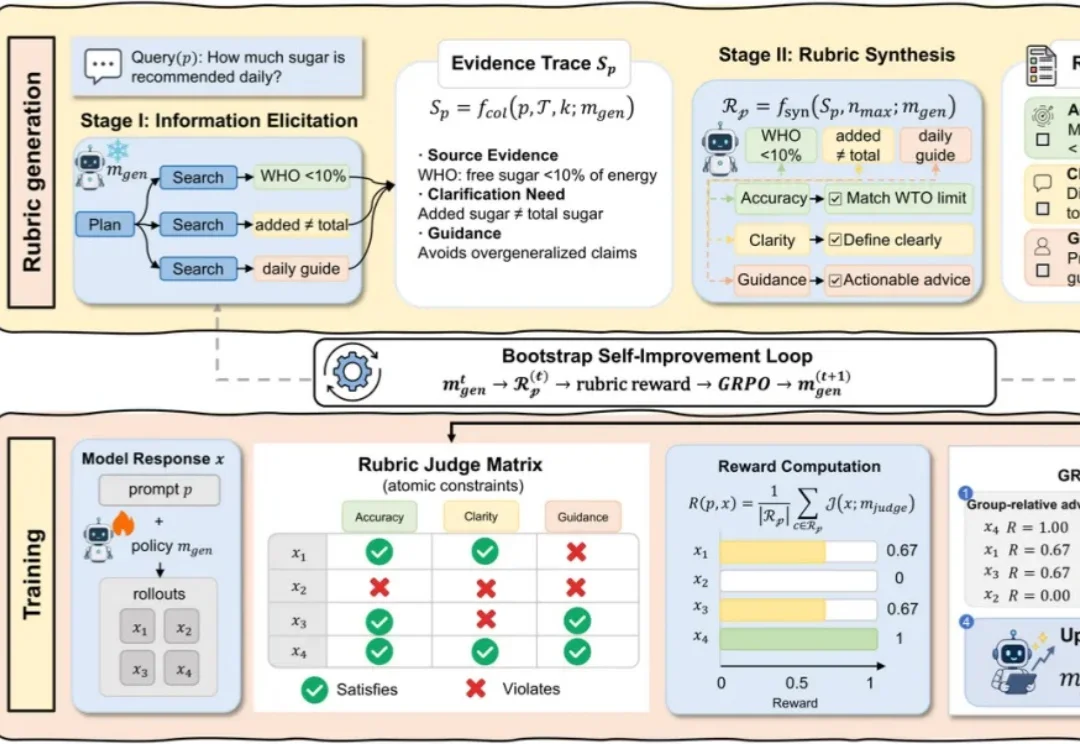
NeurIPS 2026|小红书 × 复旦大学用DR-Rubric为开放式强化学习构建评分标准让大模型回答一道数学题,通常还能拿标准答案判断对错。可如果问题换成「梳理一个领域的研究进展」「比较几种技术路线」或者「给出有依据的专业建议」,怎样才算答得好?答案没有唯一版本,遗漏关键事实、混淆概念、论证不充分,都可能藏在一段看起来很流畅的文字里。
搜索
让大模型回答一道数学题,通常还能拿标准答案判断对错。可如果问题换成「梳理一个领域的研究进展」「比较几种技术路线」或者「给出有依据的专业建议」,怎样才算答得好?答案没有唯一版本,遗漏关键事实、混淆概念、论证不充分,都可能藏在一段看起来很流畅的文字里。
AI 生图和改图已经很强了,却依然救不了双 11 期间疯狂加班的设计师。
不到十天,数学界经历了一场终极过山车!
你可能不信,Claude Code 现在差不多 90% 的代码,是 Claude 自己敲的。
世界模型赛道仍在源源不断涌入最智慧的大脑。
设定一些不合理的目标,然后告诉模型:这非常合理!
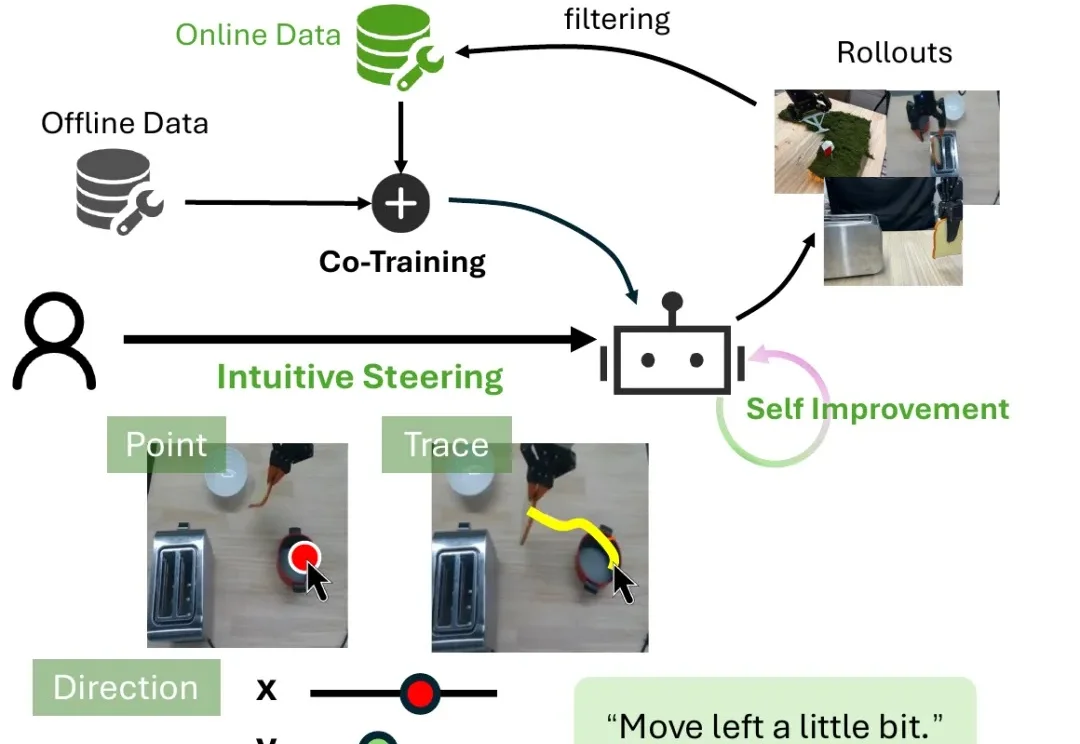
看着机器人抓偏了杯子、迟迟对不准面包机的插口,人们可能会忍不住提醒:“往左一点,再往前一点。”这些对人类来说再简单不过的调整,对机器人却未必容易。
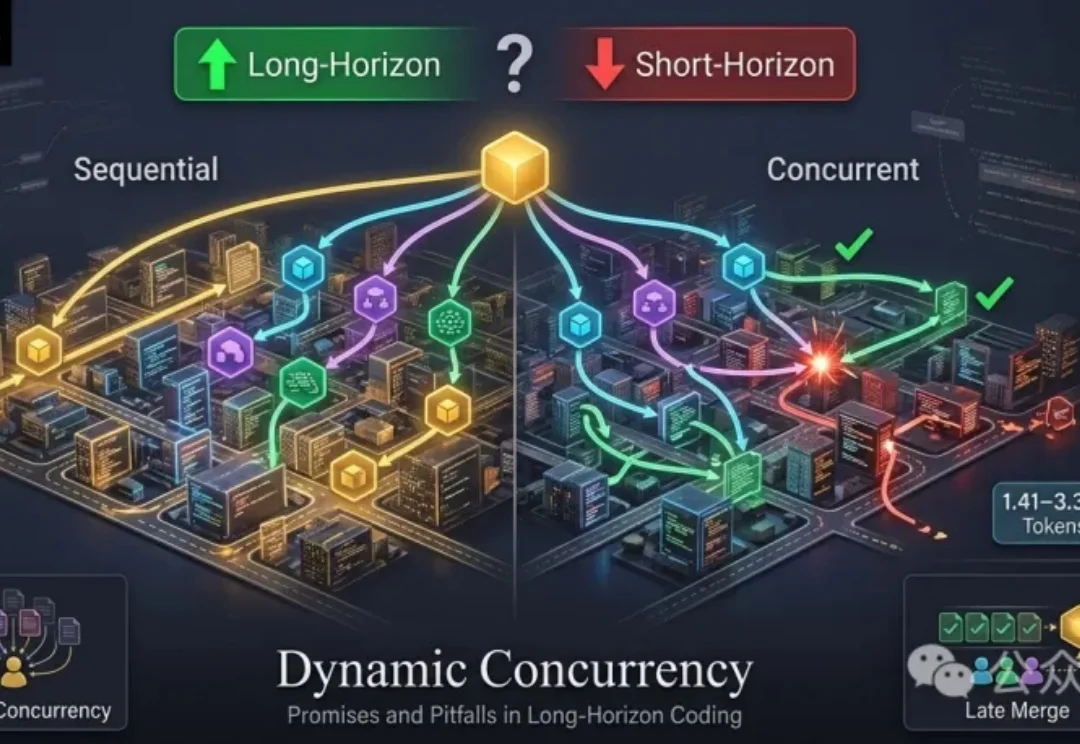
Coding Agent正在进入新的发展阶段。过去,它们主要修复Bug、解决GitHub Issue或实现相对独立的功能,SWE-bench等Benchmark已为此建立了成熟评测范式;如今它们开始承担从完整代码仓库生成、跨语言迁移,到需要持续探索与验证的长周期软件工程项目,任务规模和执行时间不断增长,单个Agent的上下文容量、推理能力和执行效率逐渐成为限制。
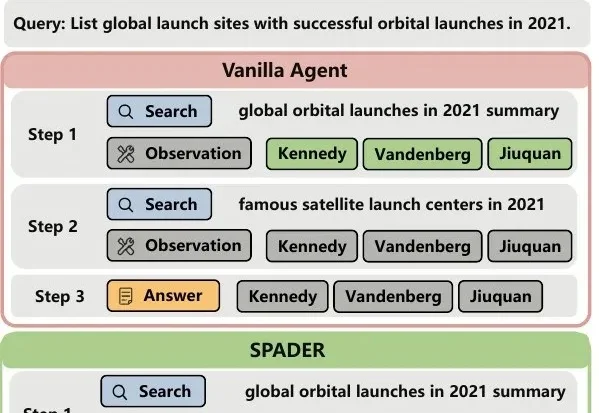
一句话概括:多答案问答要求智能体找全整个答案集合,而不是只搜到一个就停止。现有 RL 方法在此场景下存在两处错位:优势计算停留在轨迹级,信用分配粗糙;F1 奖励对头部与长尾实体一视同仁,智能体缺乏探索长尾的动力。
设想一个日常场景: 家庭机器人刚刚在茶几上看见一本书,去厨房完成几项任务后,接到取书的指令,却又开始挨个房间搜索。它已经试过一个打不开的抽屉,过了一会儿,还是回到同一个抽屉前反复尝试。