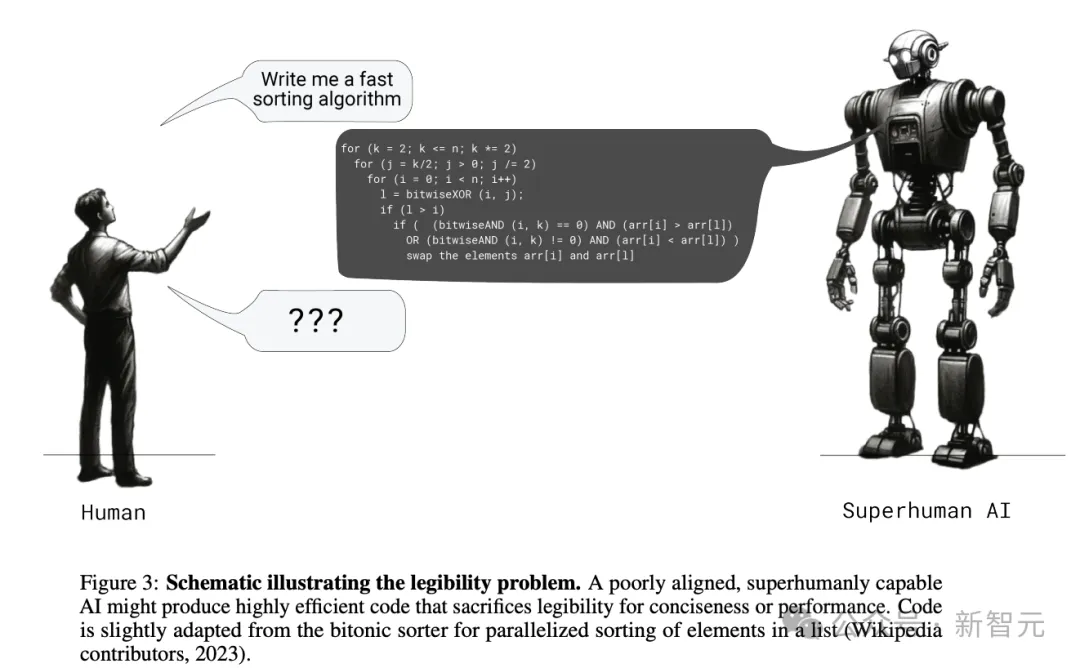
OpenAI超级对齐团队再发「绝唱」!首提「证明者-验证者」博弈,训练GPT说人话
OpenAI超级对齐团队再发「绝唱」!首提「证明者-验证者」博弈,训练GPT说人话当我们不停在CoT等领域大下苦功、试图提升LLM推理准确性的同时,OpenAI的对齐团队从另一个角度发现了华点——除了准确性,生成答案的清晰度、可读性和可验证性也同样重要。
来自主题: AI技术研报
6142 点击 2024-07-18 16:19

 搜索
当我们不停在CoT等领域大下苦功、试图提升LLM推理准确性的同时,OpenAI的对齐团队从另一个角度发现了华点——除了准确性,生成答案的清晰度、可读性和可验证性也同样重要。
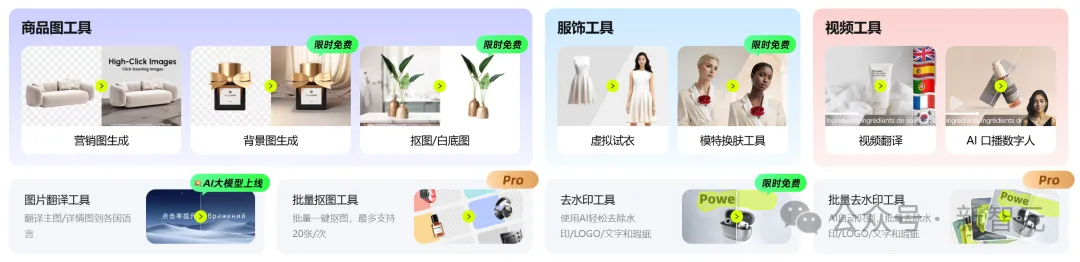
创业夫妻店雇AI做设计,显示器爆单成行业品牌No.1。这背后,不仅是3亿用户出海业务给的底气,也是因为一个团队一心做好了3件事。
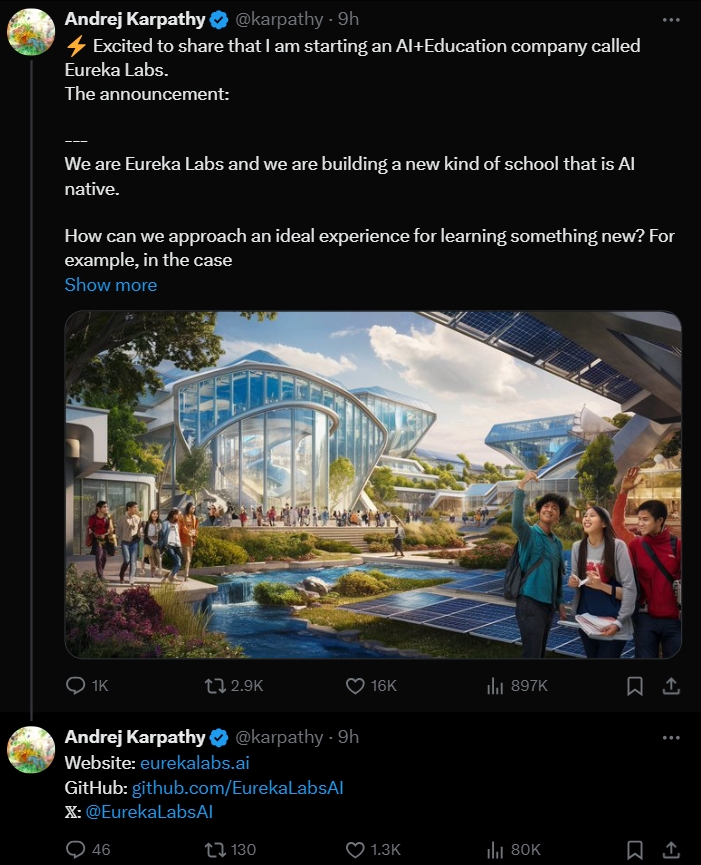
80亿人平分不到一个费曼,但可以受教于更多AI教学助理。
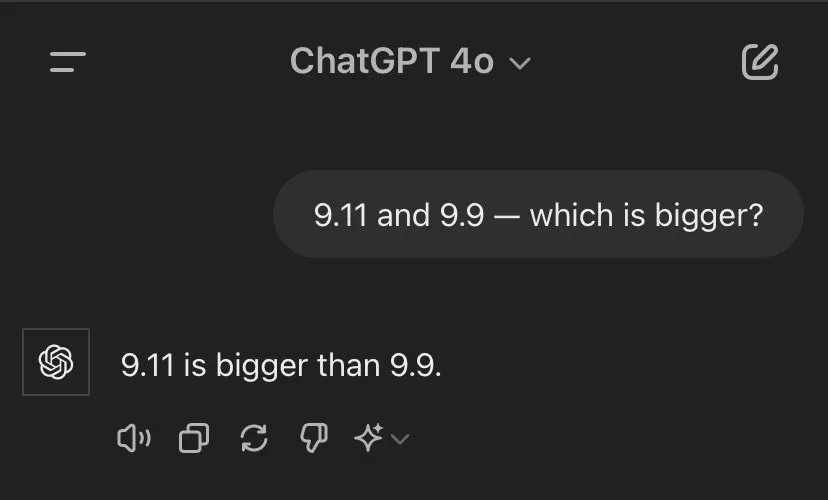
网友很好奇,Mathstral能不能搞定「9.11和9.9谁大」这一问题。

整个市场不再追求大而全,都在走小而精的路线了。

arXiv 不是同行评审期刊,所以发在 arXiv 上的论文不必被引用,这合理吗?

AI发展的浪潮席卷之下,大量媒体和电台的角色已经开始被廉价的人工智能克隆所取代。澳大利亚配音演员协会甚至表示,估计有5000名配音演员面临失业风险。
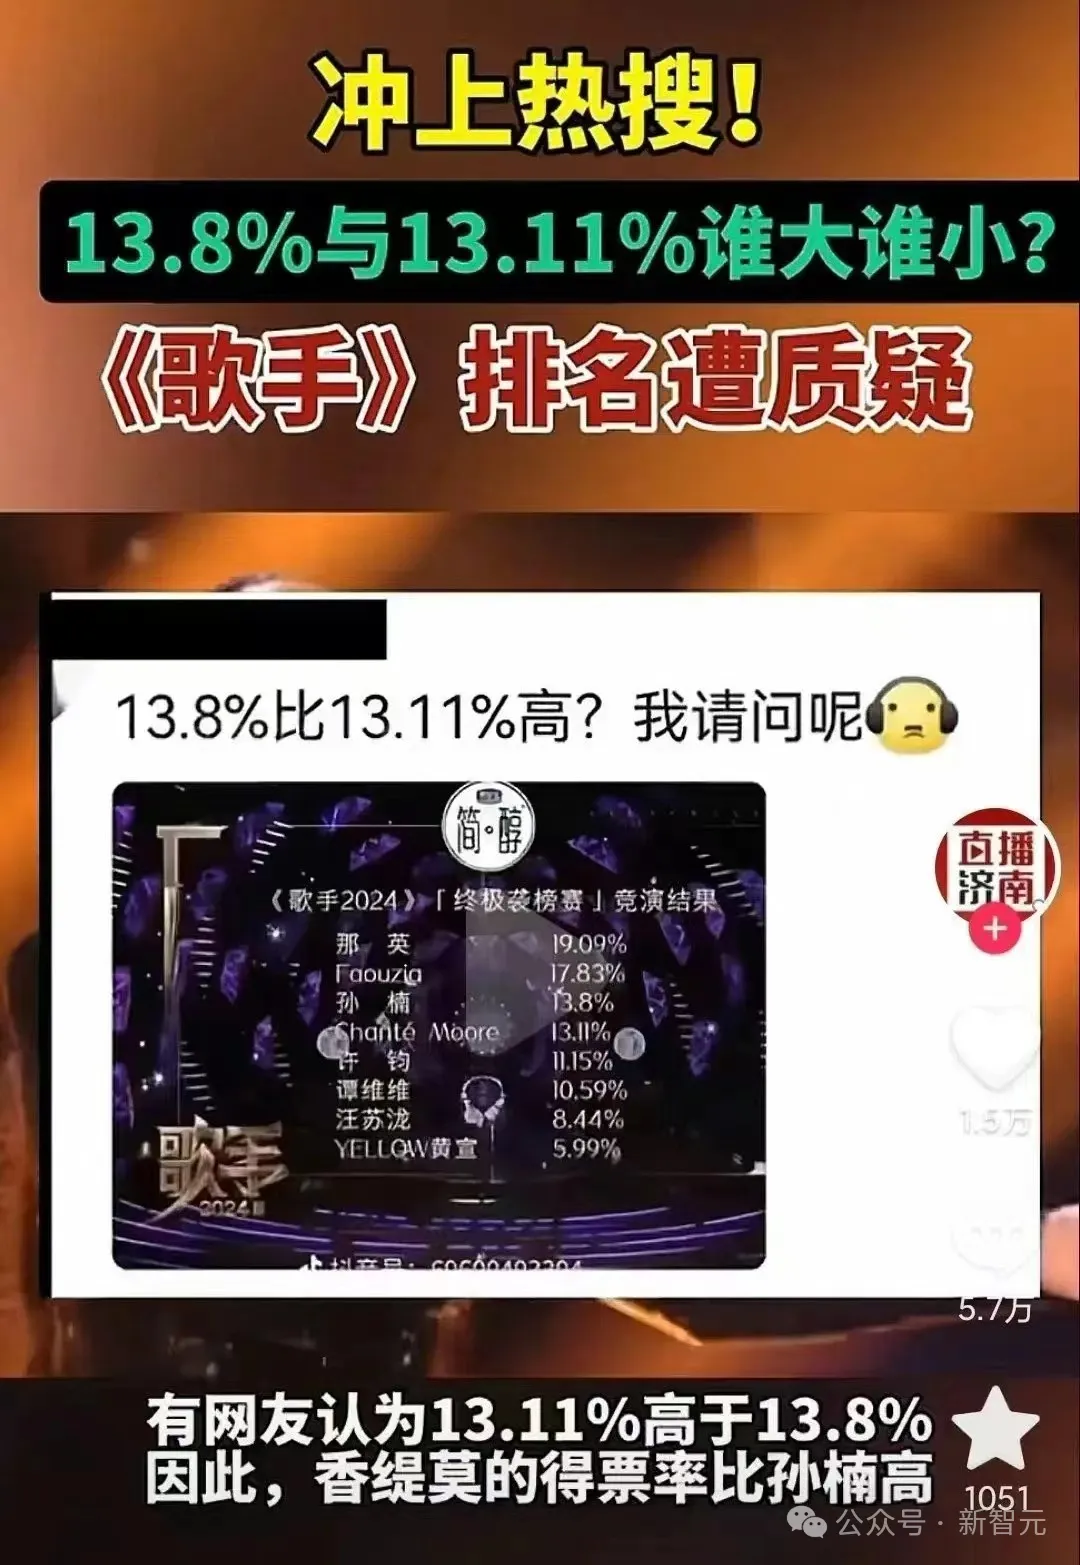
13.8和13.11哪个大?这个问题不光难倒了部分人类,还让一票大模型折戟。AI如今都能做AI奥数题了,但简单的常识问题对它们依然难如登天。其实,无论是比大小,还是卷心菜难题,都揭示了LLM在token预测上的一个重大缺陷。
AI侵权又来了……

比日常订单增长翻了四、五倍!