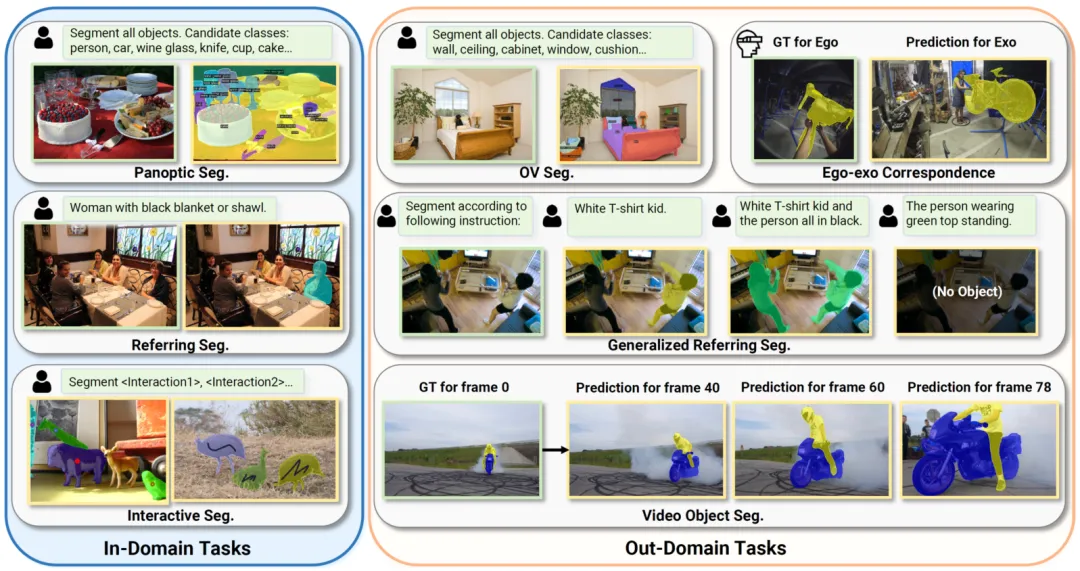
多模态大模型有了统一分割框架,华科PSALM多任务登顶,模型代码全开源
多模态大模型有了统一分割框架,华科PSALM多任务登顶,模型代码全开源最近,多模态大模型(LMM)取得了一系列引人注目的成就,特别是在视觉 - 语言任务上的表现令人瞩目。它们的成功不仅展现了多模态大模型在各个领域的实用性和灵活性,也为更多视觉场景下的应用探索了新的道路。
来自主题: AI技术研报
6864 点击 2024-04-08 15:49

 搜索
最近,多模态大模型(LMM)取得了一系列引人注目的成就,特别是在视觉 - 语言任务上的表现令人瞩目。它们的成功不仅展现了多模态大模型在各个领域的实用性和灵活性,也为更多视觉场景下的应用探索了新的道路。
随着以深度学习为代表的新一代人工智能技术不断取得突破,学术界与工业界逐渐意识到人工智能技术在图像、视频压缩领域的巨大应用潜力。

这两天,一个神秘的“音乐版Sora”产品被盛传即将发布,Suno和它比起来都不算什么。
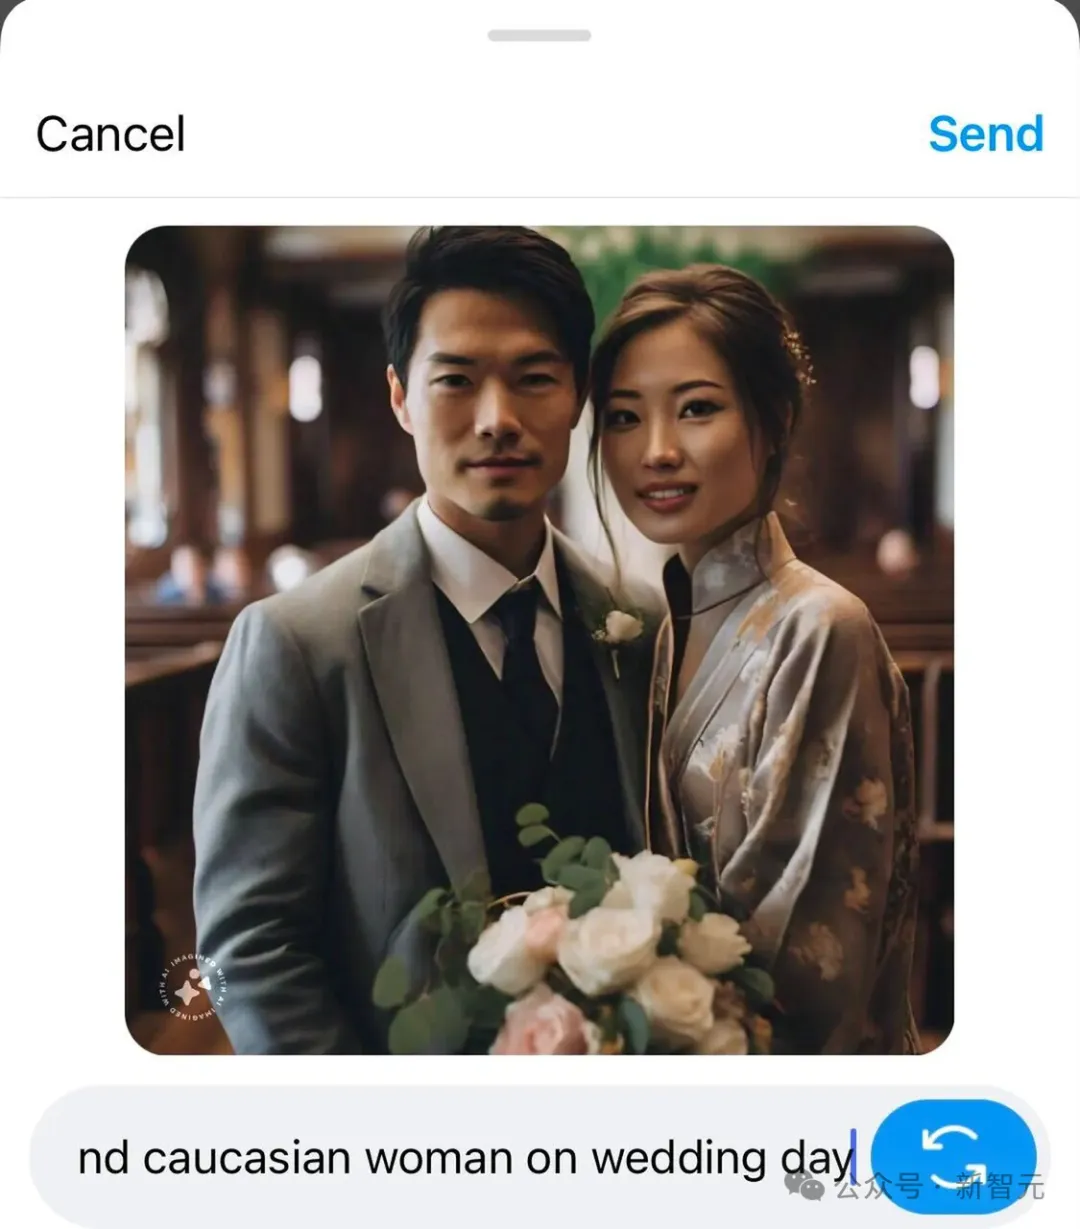
2026年的数据荒越来越近,硅谷大厂们已经为AI训练数据抢疯了!它们纷纷豪掷十数亿美元,希望把犄角旮旯里的照片、视频、聊天记录都给挖出来。不过,如果有一天AI忽然吐出了我们的自拍照或者隐私聊天,该怎么办?

比起App Store,如今的GPT Store几乎没有一战之力。
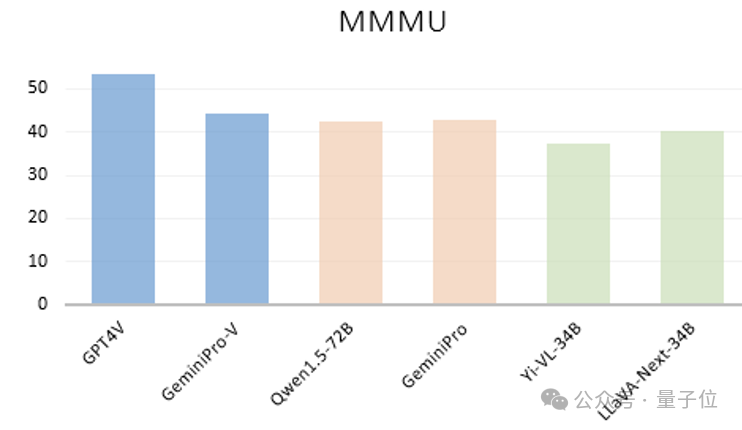
大模型不看图,竟也能正确回答视觉问题?!中科大、香港中文大学、上海AI Lab的研究团队团队意外发现了这一离奇现象。他们首先看到像GPT-4V、GeminiPro、Qwen1.5-72B、Yi-VL-34B以及LLaVA-Next-34B等大模型,不管是闭源还是开源,语言模型还是多模态,竟然只根据在多模态基准MMMU测试中的问题和选项文本,就能获得不错的成绩。
生成式AI的出现,让一切变得有所不同。
一家来自纽约的初创公司Hume AI发布了一款标榜为「第一个具有情商的对话式人工智能」的共情语音接口(EVI),并表示其能够从用户那里检测到53种不同的情绪。
秒懂视频的AI诞生了!KAUST和哈佛大学研究团队提出MiniGPT4-Video框架,不仅能理解复杂视频,甚至还能作诗配文。
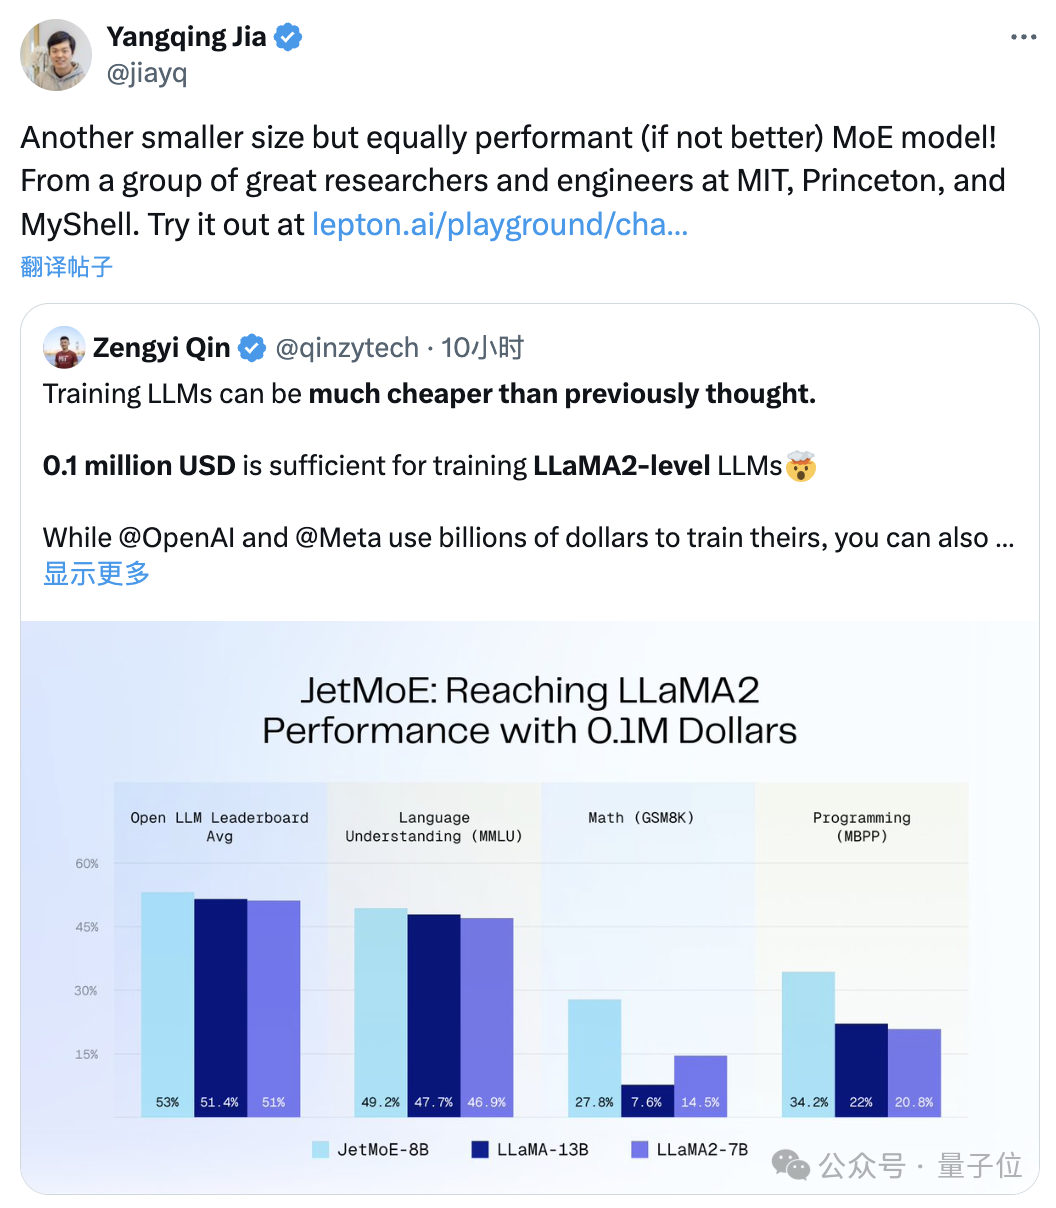
“只需”10万美元,训练Llama-2级别的大模型。尺寸更小但性能不减的MoE模型来了:它叫JetMoE,来自MIT、普林斯顿等研究机构。性能妥妥超过同等规模的Llama-2。