CVPR 2024 | 文本一键转3D数字人骨骼动画,阿尔伯塔大学提出MoMask框架
CVPR 2024 | 文本一键转3D数字人骨骼动画,阿尔伯塔大学提出MoMask框架想象一下,你仅需要输入一段简单的文本描述,就可以生成对应的 3D 数字人动画的骨骼动作。而以往,这通常需要昂贵的动作捕捉设备或是专业的动画师逐帧绘制。这些骨骼动作可以进一步的用于游戏开发,影视制作,或者虚拟现实应用。来自阿尔伯塔大学的研究团队提出的新一代 Text2Motion 框架,MoMask,正在让这一切变得可能。
搜索
想象一下,你仅需要输入一段简单的文本描述,就可以生成对应的 3D 数字人动画的骨骼动作。而以往,这通常需要昂贵的动作捕捉设备或是专业的动画师逐帧绘制。这些骨骼动作可以进一步的用于游戏开发,影视制作,或者虚拟现实应用。来自阿尔伯塔大学的研究团队提出的新一代 Text2Motion 框架,MoMask,正在让这一切变得可能。
今年 2 月份,OpenAI 发布了人工智能文生视频大模型 Sora,并放出了第一批视频片段,掀起了 AI 生成视频浪潮。目前,Sora 仍未进行公测,只有一些视觉艺术家、设计师、电影制作人等获得了 Sora 的访问权限。他们发布了一些 Sora 生成的视频短片,其连贯、逼真的生成效果令人惊艳。
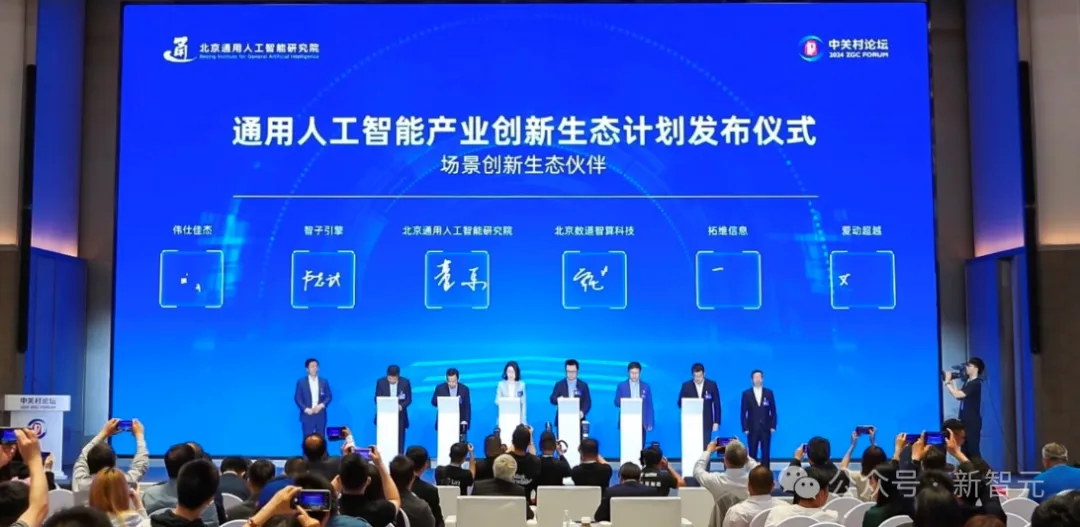
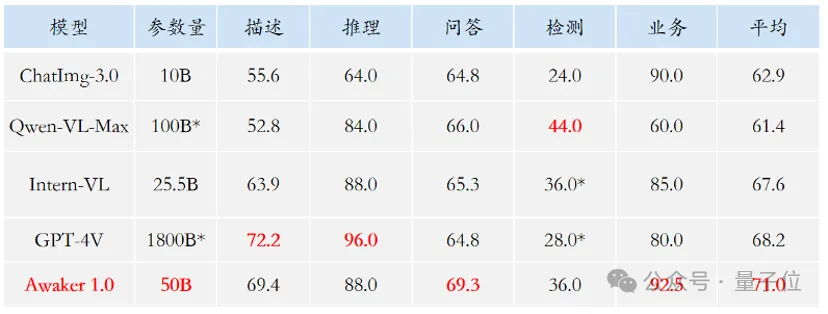
在4月27日召开的中关村论坛通用人工智能平行论坛上,人大系初创公司智子引擎隆重发布全新的多模态大模型Awaker 1.0,向AGI迈出至关重要的一步。
2024 年,Sora 一直活在聚光灯下
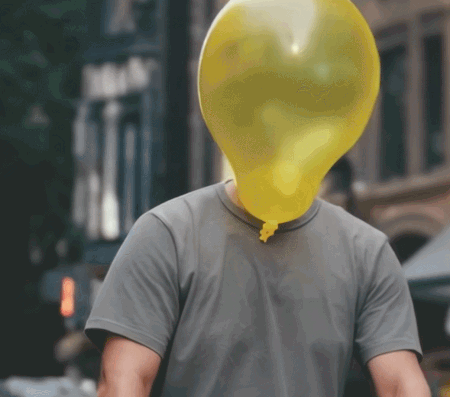
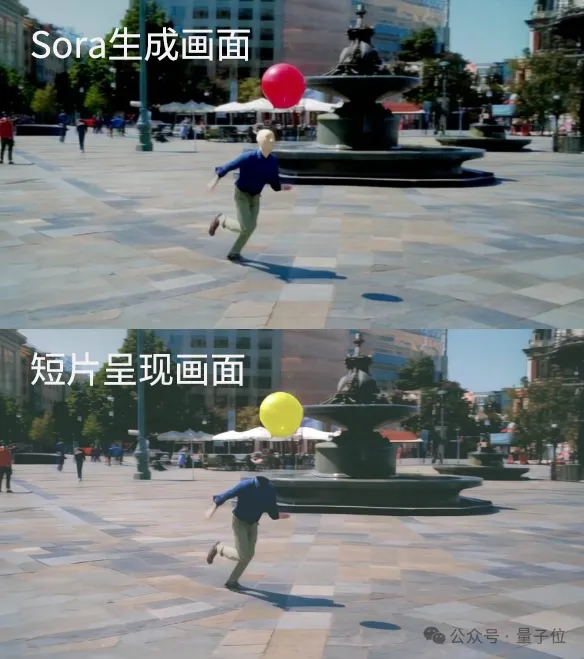
啊?Sora火爆短片《气球人》,也“造假”了???
训练模型搞得跟《饥饿游戏》似的,全球AI研究者,都在苦恼怎么才能喂饱这群数据大胃王。
又一个国产多模态大模型开源! XVERSE-V,来自元象,还是同样的无条件免费商用。
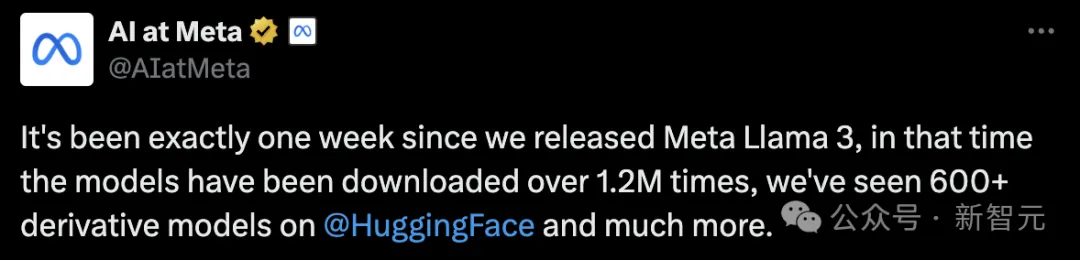
Llama 3诞生整整一周后,直接将开源AI大模型推向新的高度。
近期,大语言模型、文生图模型等大规模 AI 模型迅猛发展。在这种形势下,如何适应瞬息万变的需求,快速适配大模型至各类下游任务,成为了一个重要的挑战。受限于计算资源,传统的全参数微调方法可能会显得力不从心,因此需要探索更高效的微调策略。
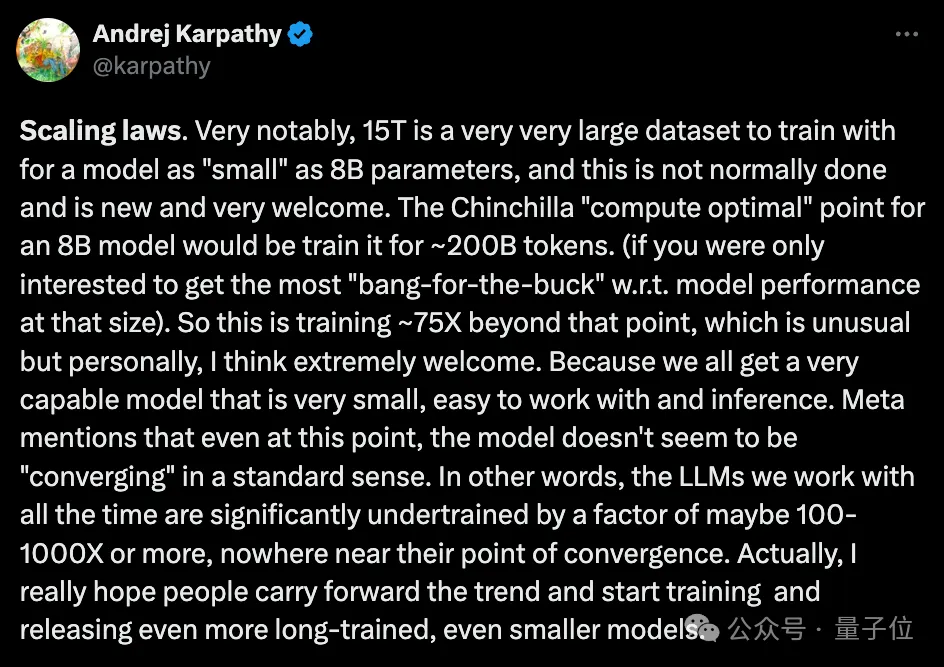
大模型力大砖飞,让LLaMA3演绎出了新高度: 超15T Token数据上的超大规模预训练,既实现了令人印象深刻的性能提升,也因远超Chinchilla推荐量再次引爆开源社区讨论。