
揭秘LLM“思考”之谜:推理即“梯度下降”,元学习框架解构训练过程,还给优化提供新思路
揭秘LLM“思考”之谜:推理即“梯度下降”,元学习框架解构训练过程,还给优化提供新思路近年来,大语言模型(LLM)以其卓越的文本生成和逻辑推理能力,深刻改变了我们与技术的互动方式。然而,这些令人瞩目的表现背后,LLM的内部机制却像一个神秘的“黑箱”,让人难以捉摸其决策过程。
来自主题: AI技术研报
7514 点击 2025-06-11 14:29

 搜索
近年来,大语言模型(LLM)以其卓越的文本生成和逻辑推理能力,深刻改变了我们与技术的互动方式。然而,这些令人瞩目的表现背后,LLM的内部机制却像一个神秘的“黑箱”,让人难以捉摸其决策过程。
SemiAnalysis全新硬核爆料,意外揭秘了OpenAI全新模型的秘密?据悉,新模型介于GPT-4.1和GPT-4.5之间,而下一代推理模型o4将基于GPT-4.1训练,而背后最大功臣,就是强化学习。
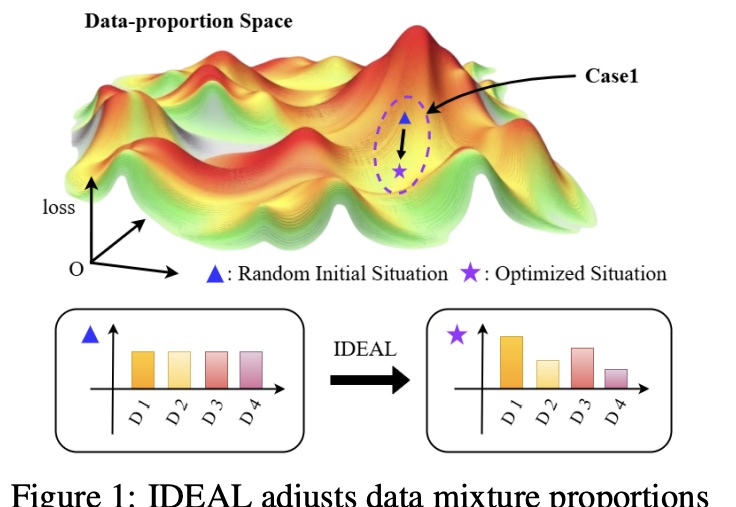
大幅缓解LLM偏科,只需调整SFT训练集的组成。
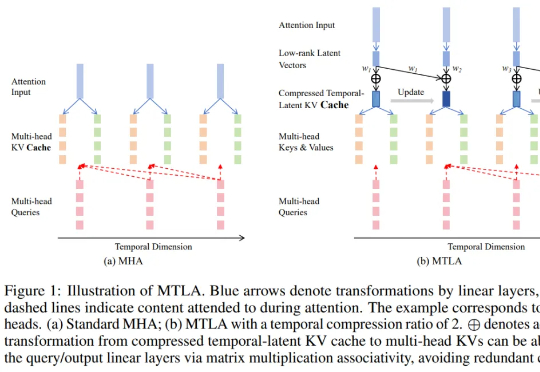
在大语言模型蓬勃发展的背景下,Transformer 架构依然是不可替代的核心组件。尽管其自注意力机制存在计算复杂度为二次方的问题,成为众多研究试图突破的重点
为什么语言模型能从预测下一个词中学到很多,而视频模型却从预测下一帧中学到很少?
大模型的落地能力,核心在于性能的稳定输出,而性能稳定的底层支撑,是强大的算力集群。其中,构建万卡级算力集群,已成为全球公认的顶尖技术挑战。

游戏直播等实时渲染门槛要被击穿了?Adobe 的一项新研究带来新的可能。
为什么语言模型很成功,视频模型还是那么弱?

给大模型当老师,让它一步步按你的想法做数据分析,有多难?

测试时扩展(Test-Time Scaling)极大提升了大语言模型的性能,涌现出了如 OpenAI o 系列模型和 DeepSeek R1 等众多爆款。那么,什么是视觉领域的 test-time scaling?又该如何定义?