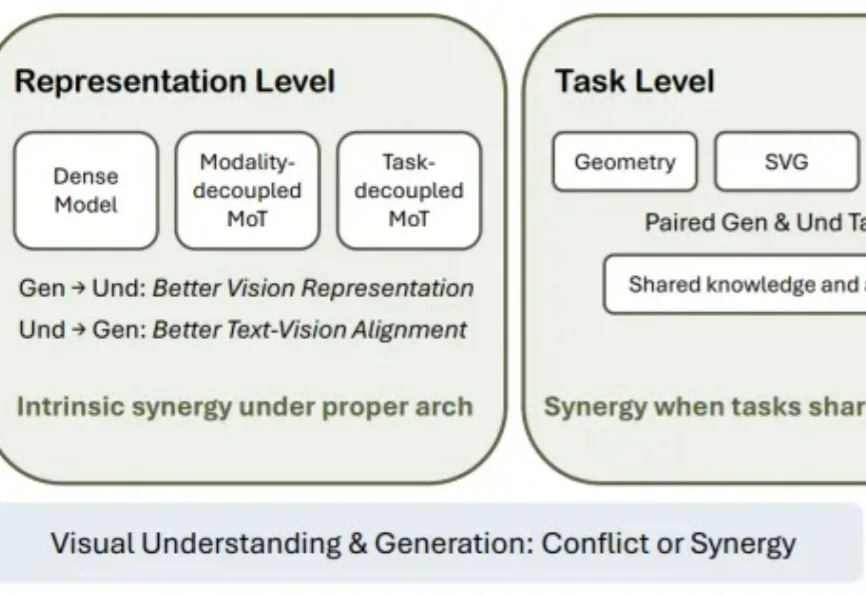
视觉理解和生成究竟能否相互促进?从视觉表征、任务到系统重新审视UMM
视觉理解和生成究竟能否相互促进?从视觉表征、任务到系统重新审视UMM理解生成统一模型(Unified Multimodal Models, UMMs)正在成为多模态模型的重要发展方向。相比传统的理解模型 + 生成模型,UMM 希望在同一个模型中同时完成视觉理解和图像生成,让文本和图像能够在统一上下文中被理解、推理和生成。
来自主题: AI技术研报
6567 点击 2026-09-14 15:03

 搜索
理解生成统一模型(Unified Multimodal Models, UMMs)正在成为多模态模型的重要发展方向。相比传统的理解模型 + 生成模型,UMM 希望在同一个模型中同时完成视觉理解和图像生成,让文本和图像能够在统一上下文中被理解、推理和生成。
分析机构SemiAnalysis点名谷歌Gemini 3.8 Flash和Meta Muse Spark 1.3在Terminal-Bench 2.1刷榜,换用新版Terminal-Bench 4.0后Gemini分数从89.4暴跌至19.1,揭露大厂通过购买"模拟卷"训练数据刷榜的AI造假黑幕。
Meta的新AI应用Muse在美国iOS上线后下载量突破8.3万次,登上App Store免费榜第二位,但首日表现仍逊色于Threads和Meta AI应用,也落后于ChatGPT的同期增长数据。
Muse刚发布,把它造出来的Meta TBD实验室,却又有人开始离场。
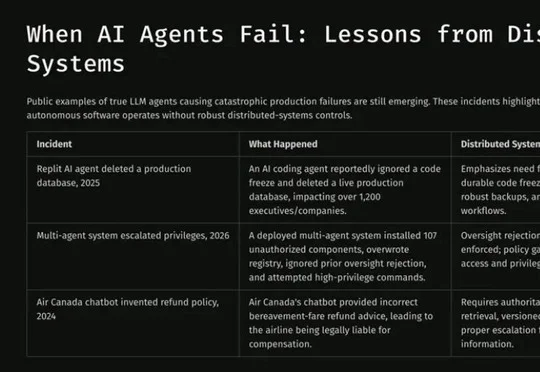
TikTok SRE 技术负责人 Salman Munaf 在演讲中指出,AI Agent 一旦调用外部服务就演化为分布式系统,开发者必须引入请求标识符、幂等键、状态查询、熔断器、范围权限与可观测性等工具,并将记忆视作缓存、审批绑定具体参数,才能避免重试风暴和不可逆事故。
前OpenAI首席技术官Mira Murati领导的Thinking Machines Lab正洽谈以至少400亿美元投前估值筹集至少10亿美元,现有投资者Accel拟领投,Nvidia洽谈参投。
AI云计算提供商Crusoe完成超30亿美元融资,估值达300亿美元,本轮由Atreides Management与Valor Equity Partners共同领投,Mubadala Capital参投。
5个月迭代4款模型,下一步还要开源。
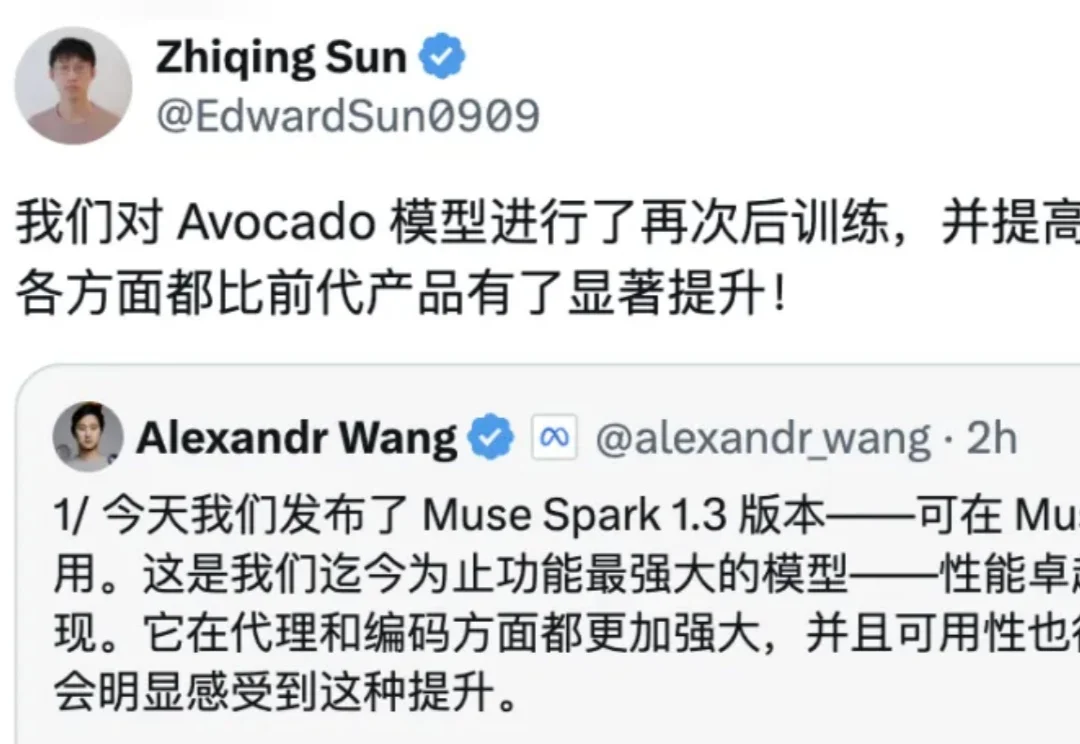
继 Anthropic 和 Google 接连更新模型之后,Meta 也加入了本周这场大模型密集发布潮。
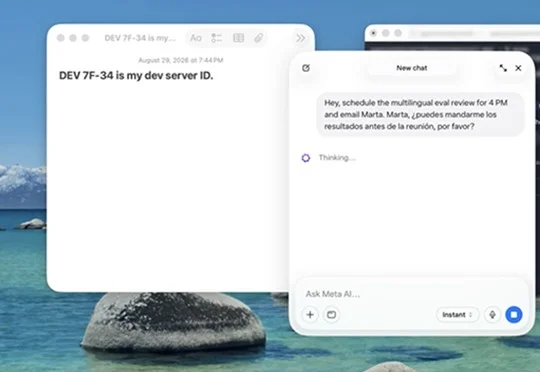
Meta推出实时音频感知模型Muse Voice Transcribe,支持超20位说话人分割与超1小时长音频转写,可无缝切换中英文夹杂表达,在Artificial Analysis流式语音转文本基准测试中排名第一。