独家|能量桥完成新⼀轮融资,Monolith领投,中科创星跟投
独家|能量桥完成新⼀轮融资,Monolith领投,中科创星跟投近日,能量桥科技(上海)有限公司(以下简称“能量桥”)宣布完成新一轮融资,由 Monolith 砺思资本领投,中科创星跟投。
来自主题: AI资讯
11308 点击 2026-05-19 14:57

 搜索
近日,能量桥科技(上海)有限公司(以下简称“能量桥”)宣布完成新一轮融资,由 Monolith 砺思资本领投,中科创星跟投。
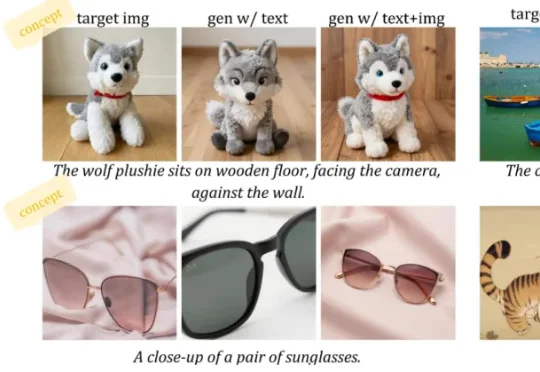
阿里巴巴 Z-Image 团队联合香港科技大学、加州大学圣地亚哥分校、香港中文大学等机构提出 D-OPSD(On-Policy Self-Distillation),首个针对少步扩散模型的在线策略自蒸馏框架。D-OPSD 无需奖励模型、无需成对偏好数据,
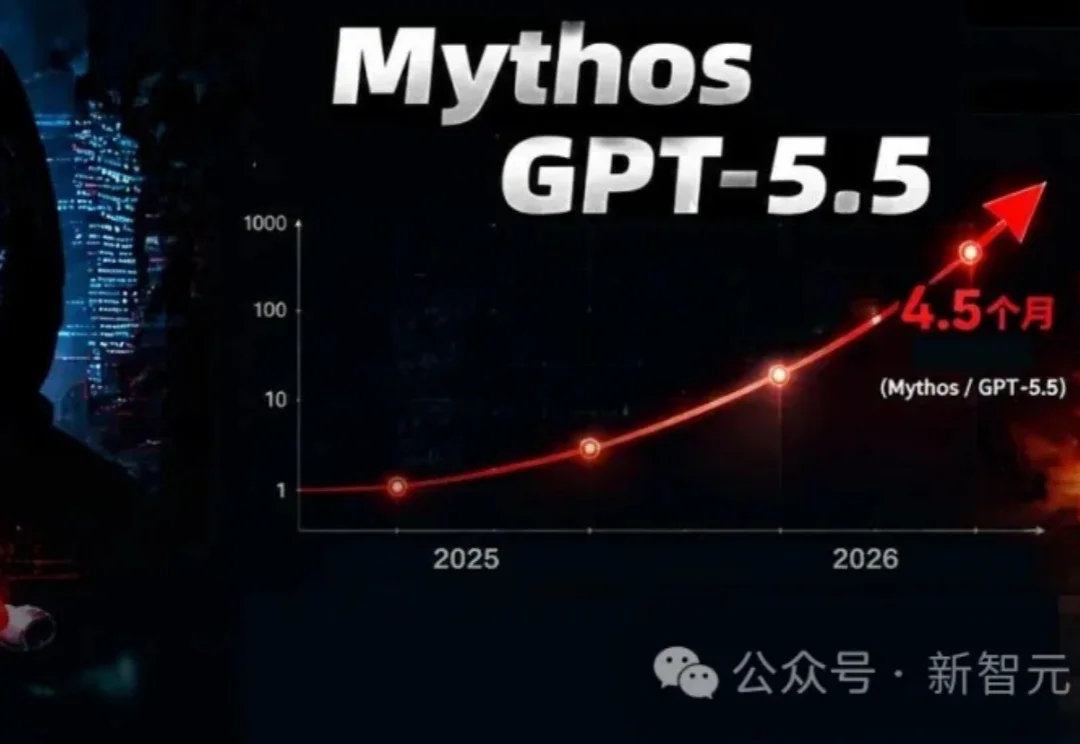
英国AI安全研究所(AISI)昨天扔下重磅炸弹:Mythos在模拟企业内网32步渗透任务中10次过6,GPT-5.5也跟着10次过3,连此前所有模型都没破过的Cooling Tower靶场都被首次攻破!更炸的是——Cyber能力翻倍周期一路压到4.5个月,瓶颈不是智力,是Token。这场ASI决赛,人类评测已经追不上AI了。
上个月我遇到一个挺尴尬的事。同事指着屏幕上一张零件截图问我:"这个法兰盘,外径多少,孔位怎么分布的?"我张嘴比划了半天,最后打开SolidWorks重新画了一遍给他看。明明脑子里是完整的三维造型,传到另一个人那里就变成了一堆说不清的数字和手势。
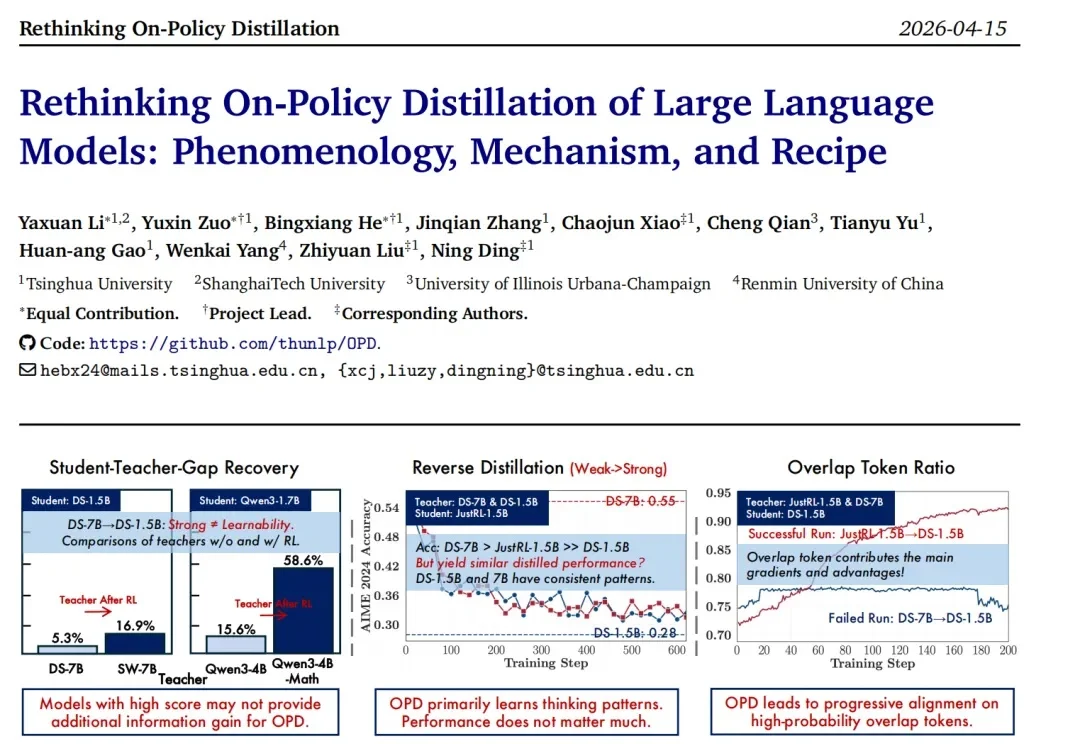
当下的大模型后训练(Post-training)pipeline 中,On-Policy Distillation(OPD)已经成为了明星技术。从 Qwen3、MiMo 到 GLM-5,业界纷纷采用 OPD 并报告了巨大的性能提升。相比于强化学习(RL)稀疏的结果奖励,OPD 提供了密集的 Token 级别监督信号,看起来就像是一顿「免费的午餐」。
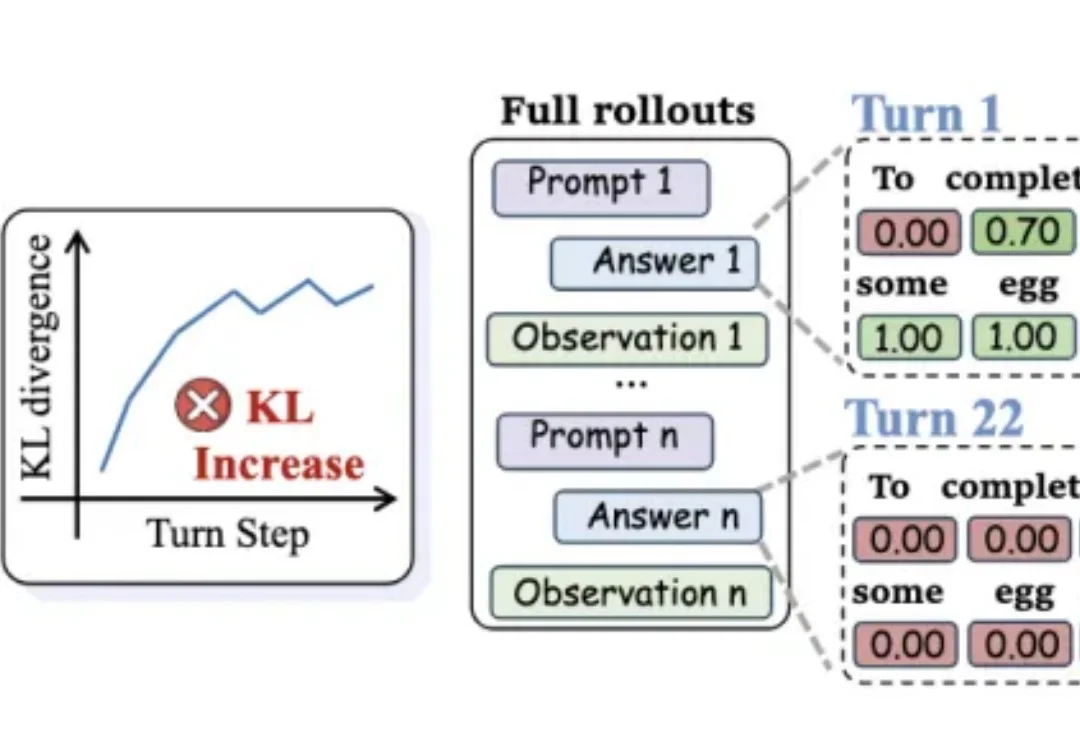
把强大模型的能力“蒸馏”给小模型,听起来很美—— 但放到多轮对话Agent场景里,效果往往一塌糊涂。
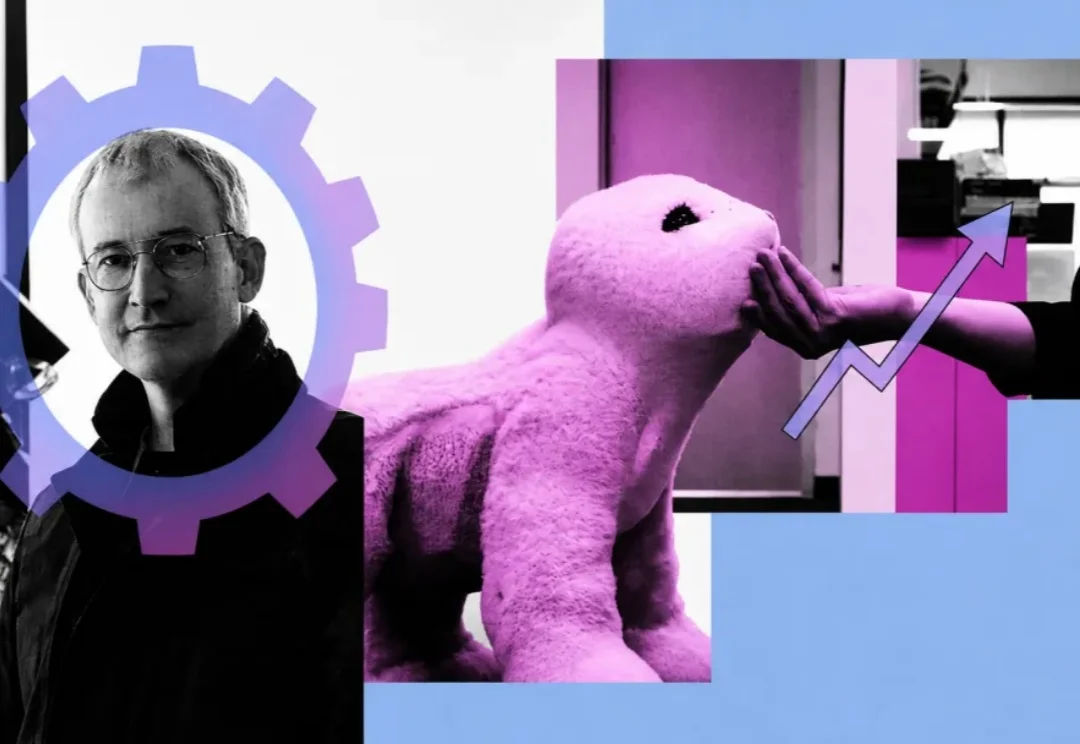
还记得之前破产的扫地机器人鼻祖公司 iRobot 吗?最近它的创始人科林·安格尔(Colin Angle),在经历公司破产重整之后拿出了他的新作品。
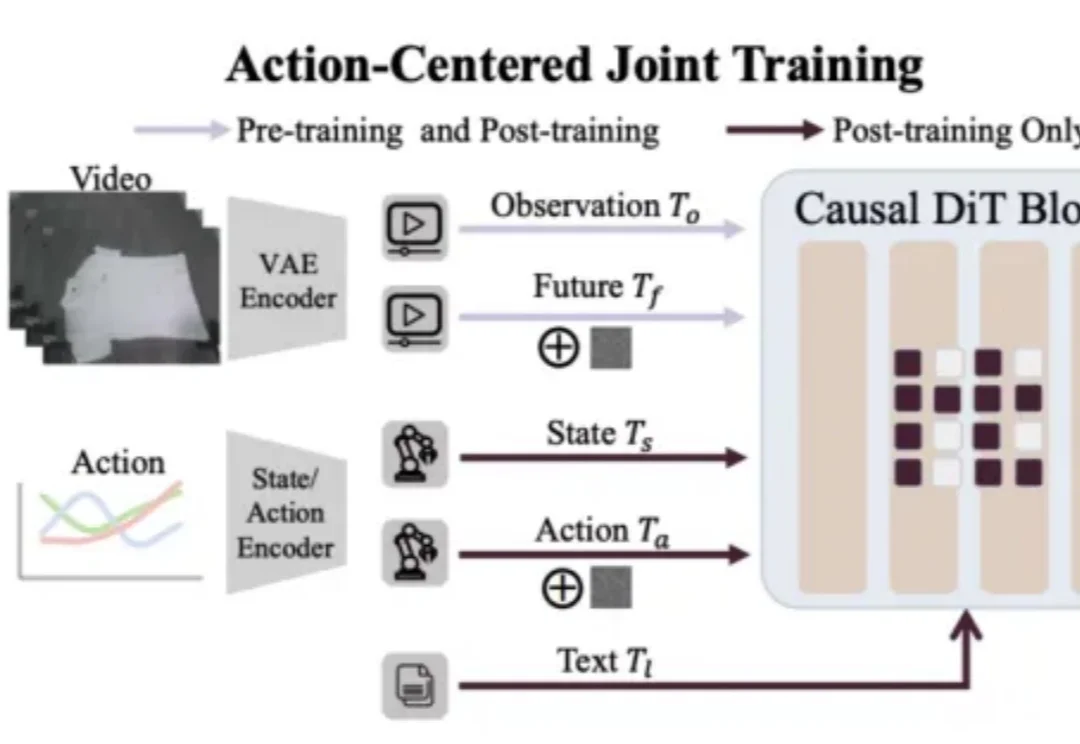
最近,具身智能圈被 Generalist CEO 的一篇长文《Going Beyond World Models & VLAs》刷屏。文章抛出了一个看似振聋发聩的观点:目标远比工具标签更重要。与其陷入 “我们到底是在做 VLA(视觉 - 语言 - 动作模型)还是世界模型(World Model)” 的教条之争,不如回归本源:让机器高效、准确地作用于物理世界。
小红书AI平台团队刚刚开源了Relax——一个为全模态数据、Agentic工作流和大规模异步训练协同设计的现代RL训练引擎!实测全异步Off-Policy模式相比共卡On-Policy吞吐提升76%,相比veRL的全异步实现提升20%!
通用世界模型评测榜单 WorldScore 登顶、建立具身世界模型评测榜单 WorldArena 、发布通用世界模型 WorldScape 、发布世界-动作模型 WorldScape Policy,这家低调的世界模型创业公司 Manifold AI(流形空间)近期走出隐身模式频频出手,开始领跑世界-动作模型具身新路线。