独家 | 红杉中国、Monolith领投AI健康硬件公司「Odyss」,金额近2亿元
独家 | 红杉中国、Monolith领投AI健康硬件公司「Odyss」,金额近2亿元AI健康硬件公司「OdyssLife」(以下简称“Odyss”)已于近期连续完成多轮融资,总金额近2亿元人民币。本次融资由红杉中国、Monolith分别领投,老股东线性资本、Creekstone继续加注。
来自主题: AI资讯
10439 点击 2026-03-29 11:01

 搜索
AI健康硬件公司「OdyssLife」(以下简称“Odyss”)已于近期连续完成多轮融资,总金额近2亿元人民币。本次融资由红杉中国、Monolith分别领投,老股东线性资本、Creekstone继续加注。
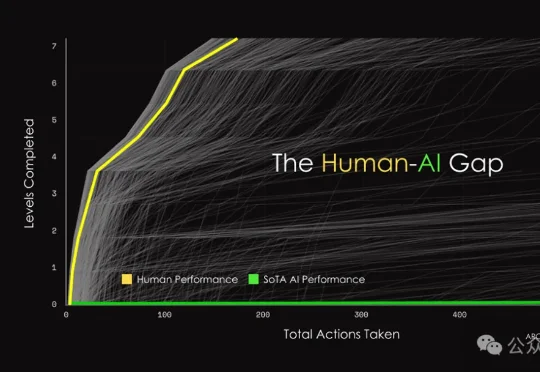
就在昨天,ARC-AGI-3刚把全球顶尖大模型按在地上摩擦,结果一家名不见经传的公司却给出惊天消息:他们的AI在首日就取得了36.08%的成绩!这匹黑马究竟靠什么撕开全球最难AI考试的铁幕?是真突破,还是另有玄机?
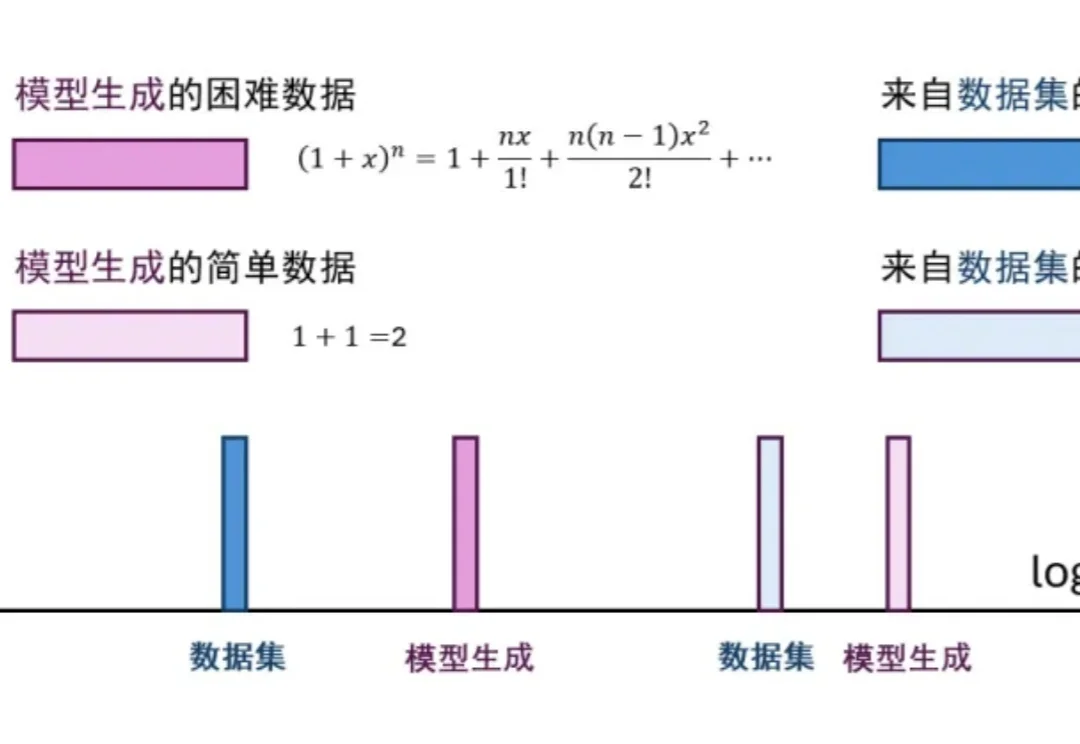
在大模型后训练阶段,监督微调(SFT)和强化学习(RL)是两根不可或缺的支柱。SFT 利用高质量的离线(Off-policy)数据快速注入知识,但受限于静态数据分布,泛化能力往往容易触及天花板并带来灾难性遗忘;RL 则允许模型在探索中不断自我迭代,产生与当前策略同分布(On-policy)的数据,上限极高,但往往伴随着训练极度不稳定、计算资源消耗巨大的痛点。
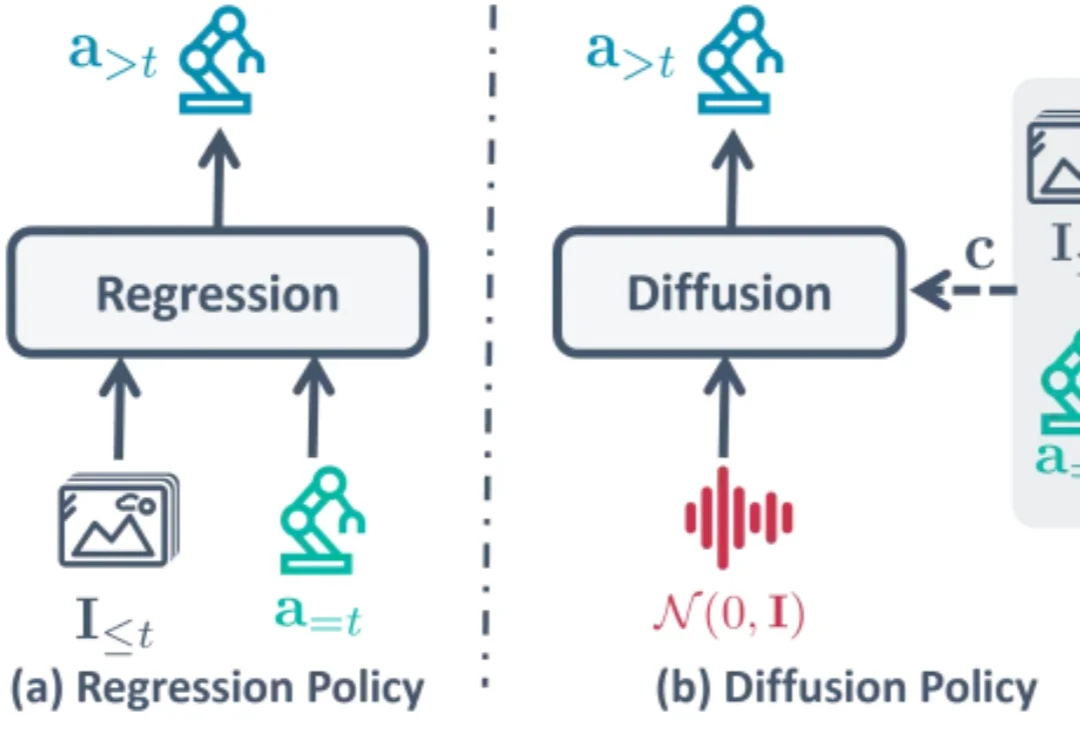
在机器人领域,扩散策略(Diffusion Policy)已经成为了标准模仿学习策略和 VLA 动作生成范式,但其「从随机噪声中迭代解噪」的机制带来了不容忽视的推理延迟。如果机器人不再从随机高斯噪声开始「盲猜」,是否可以基于「刚刚做了什么」来预测「下一步做什么」呢?
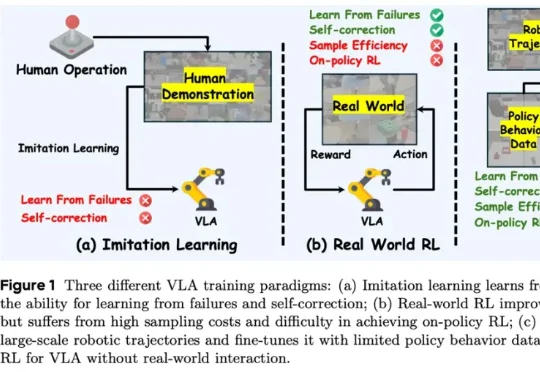
香港科技大学 PEI-Lab 与字节跳动 Seed 团队近期提出的 WMPO(World Model-based Policy Optimization),正是这样一种让具身智能在 “想象中训练” 的新范式。该方法无需在真实机器人上进行大规模强化学习交互,却能显著提升策略性能,甚至涌现出 自我纠错(Self-correction) 行为。
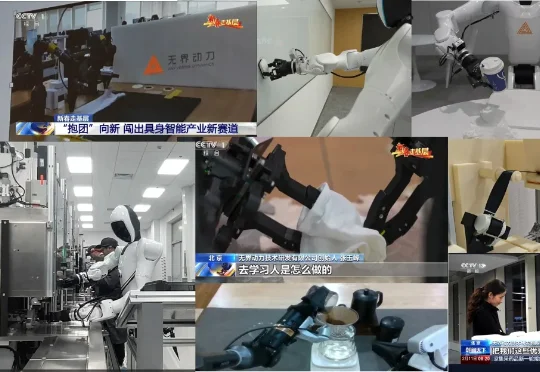
通用具身智能机器人公司「无界动力」宣布完成超2亿元天使+轮融资,老股东红杉中国、线性资本、高瓴创投、华业天成、中金资本旗下基金、BV百度风投持续追投,新增深创投、创新工场、普华资本、钧山资本、雅瑞资本等加入。
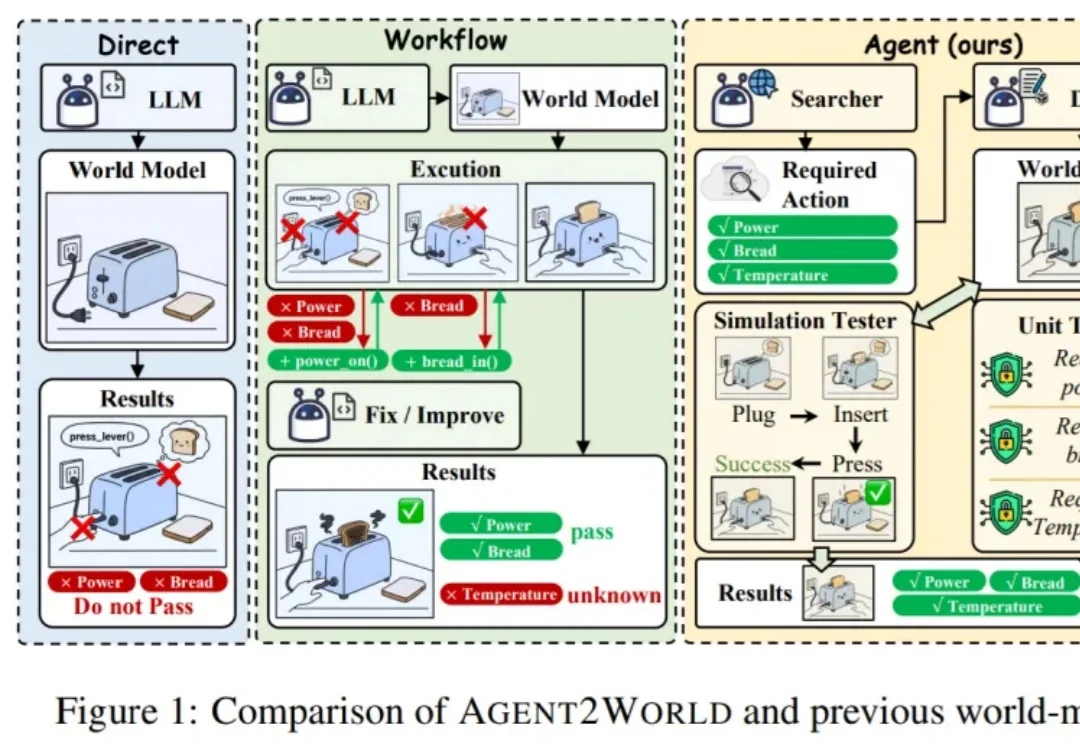
让模型真正 “能行动”,往往需要一个可执行、可验证的符号世界模型(Symbolic World Model):它不是抽象的文字描述,而是能被规划器或执行器直接调用的形式化定义 —— 例如 PDDL 领域 / 问题,或可运行的环境代码 / 模拟器。
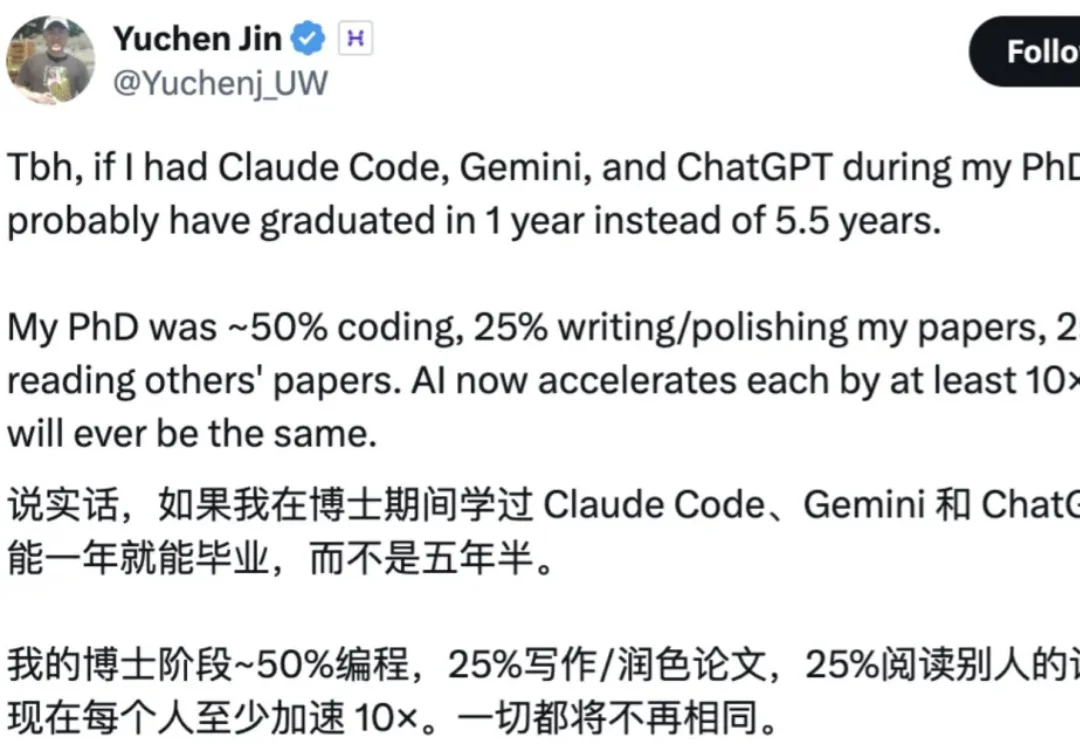
近日,X 知名博主、Hyperbolic 联创 & CEO Yuchen Jin 发帖称,如果在他读博士的时候就有 Claude Code、Gemini 和 ChatGPT 等各类 AI 工具出现,那么也许只要一年就能毕业,而不是用了 5.5 年。
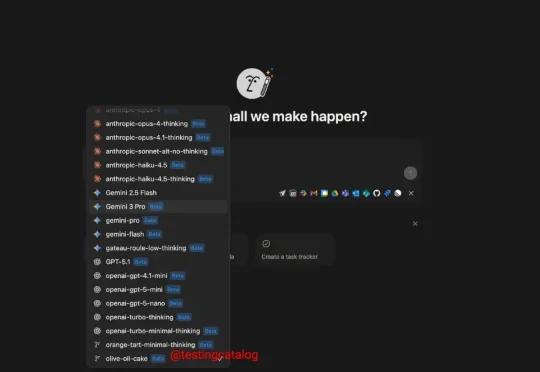
让我们细数一下这两年令人印象深刻的模型代号:草莓、香蕉、胡萝卜……每次一亮相,总要和水果蔬菜沾点关系。最新的主角叫:Olive Oil Cake(橄榄油蛋糕),另加 Chestnut and Hazelnut(栗子和榛子)。
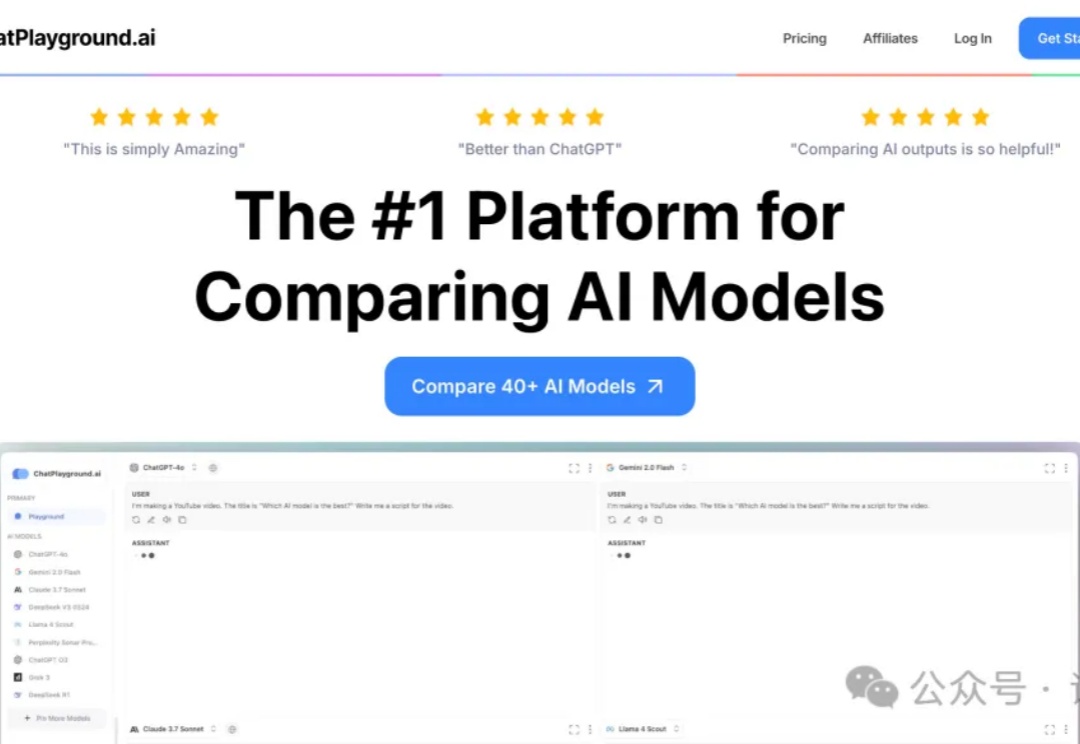
先说一句最关键的。十月,ChatPlayground.ai 的月访问量估算为25万上下,环比暴涨六倍多,具体是 611.53%。这个数据来自 Toolify 的十月增长榜。