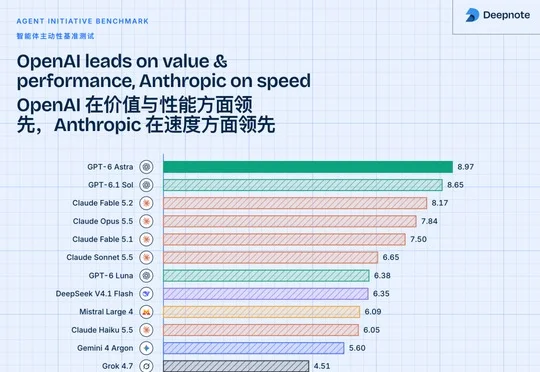
Fable 5.2贵17倍还输了!12 个AI进群当同事,OpenAI包揽前二
Fable 5.2贵17倍还输了!12 个AI进群当同事,OpenAI包揽前二Deepnote发布Agent Initiative Benchmark评测称,OpenAI包揽前二,GPT-6.1 Sol以8.65分、每任务0.11美元成为性价比最高者,Anthropic Fable 5.2成本高17倍但得分更低。
来自主题: AI技术研报
7178 点击 2026-11-15 11:30

 搜索
Deepnote发布Agent Initiative Benchmark评测称,OpenAI包揽前二,GPT-6.1 Sol以8.65分、每任务0.11美元成为性价比最高者,Anthropic Fable 5.2成本高17倍但得分更低。
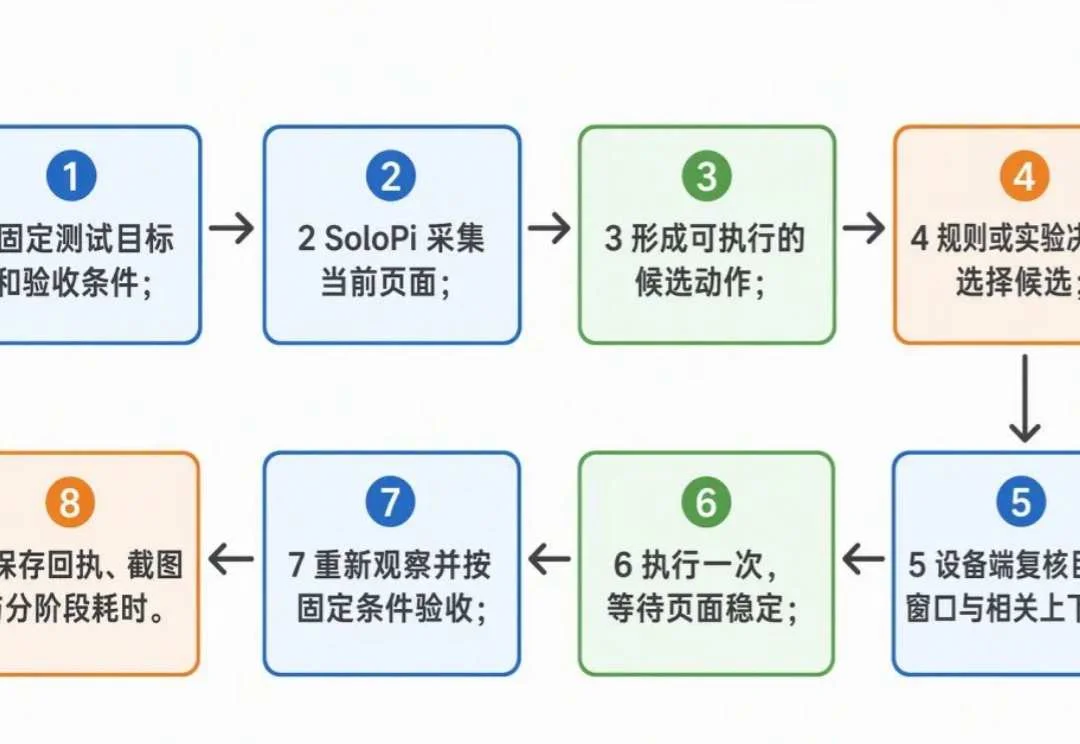
SoloPi 是一套面向移动端研发的开源自动化与 AI Harness 工程。它保留了 SoloPi 在 Android 真机上的录制、回放、断言和性能诊断能力,并增加 Agent 接入、动态页面安全执行、独立结果 判定、无人值守托管和同次运行证据,让一次设备操作可以交付为可进入研发与 CI 流程的结论。
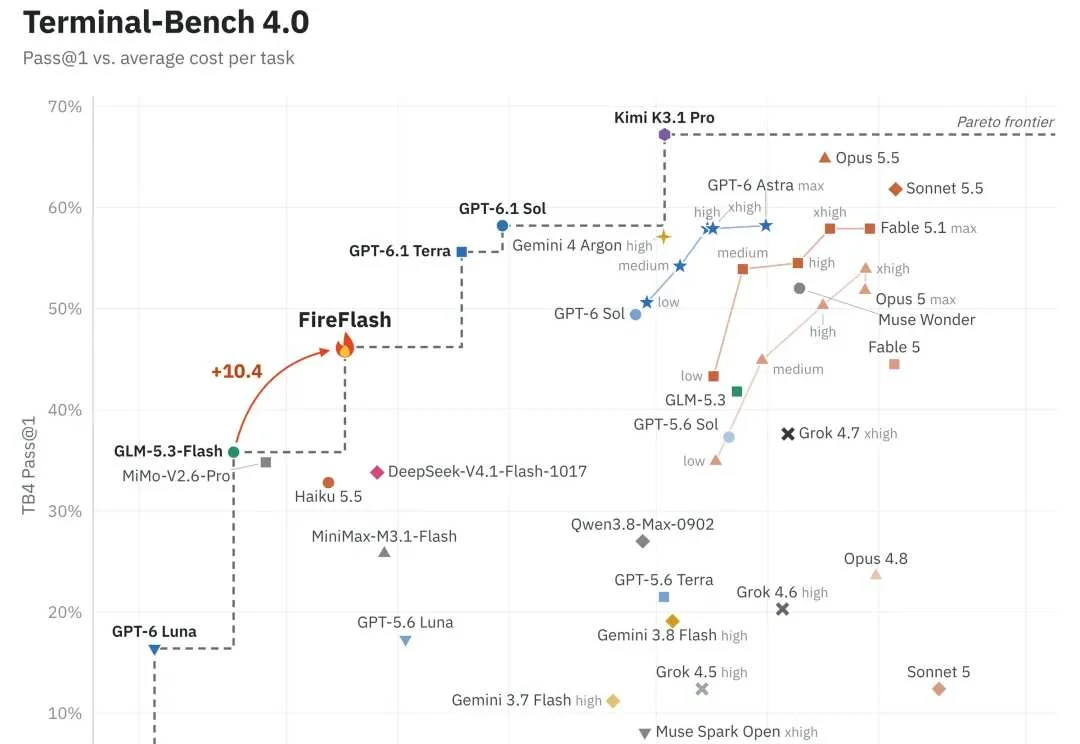
长程智能体(long-horizon agents)正从「修一个 bug」走向连续数小时的终端与编程工作,但它的强化学习训练也格外昂贵:前沿实验室可以在数千张 GPU 上扩展 RL,而对多数团队来说,一条训练样本往往就是一次长达 3 小时、上百轮工具调用的完整尝试,任何一个环节出错,浪费的都是成小时的 GPU 时间。
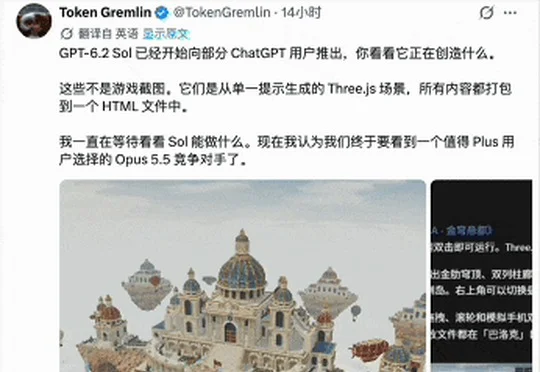
部分ChatGPT和Codex用户疑似被灰度到OpenAI尚未正式发布的GPT-6.2 Sol,实测显示其可完成复杂推理、编程及3D场景生成,并在一次对比中以约20分钟、9美元的表现优于Opus 5.5的1小时、20美元。
Anthropic以34亿美元锁定OnePWR Solutions的1.7吉瓦重型发电机供货,用于数据中心供电,创已知AI实验室单笔发电设备采购金额纪录。
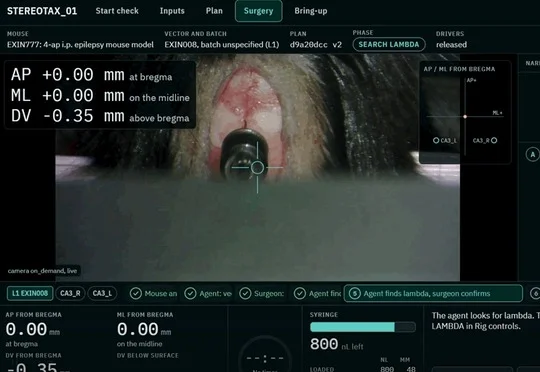
Exin Therapeutics让GPT-6.1 Sol连续参与三轮真实小鼠脑部手术定位,借助外科医生反馈逐轮改善,第三次搜索时间由169秒降至86秒、纠正由4次减至2次、误差由0.6毫米降至0.3毫米,但仅3次操作尚不足以证明其掌握稳定手术能力。
研究显示,GPT-6 Astra、GPT-6.1 Sol和Gemini Argon可能接受过机器人专门训练,并对Franka Panda运动学知识过拟合,尚不能证明其掌握可跨机器人迁移的通用运动学能力。
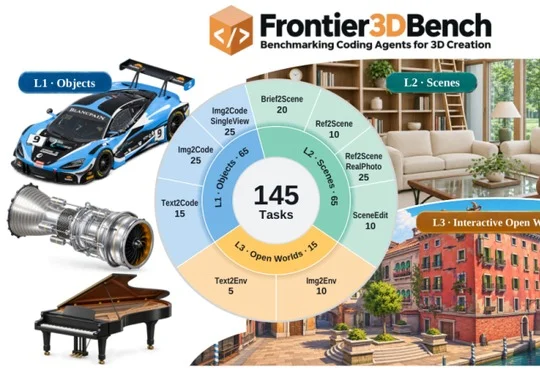
Einsia AI发布Frontier3DBench,在Blender与Unreal Engine中以145项任务评测11种主流模型与Agent框架配置,GPT-6.1-sol总榜第一,但Agent在开放世界连续交互和持久状态协同上仍显薄弱。
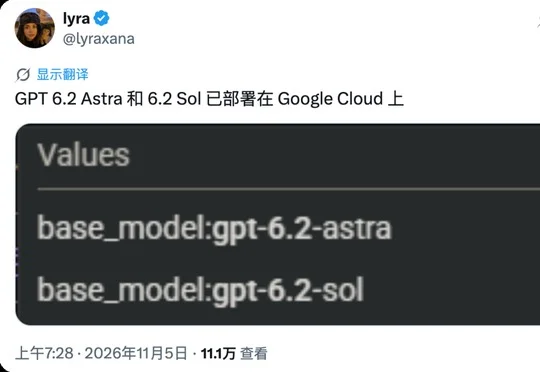
据 The Information 报道,OpenAI 最快本周五推出 GPT-6.2 Astra、Sol 等下一代模型;Anthropic Claude Code 与 Cowork 总产品负责人 Cat Wu 已离职并加入 OpenAI Core Products 部门。
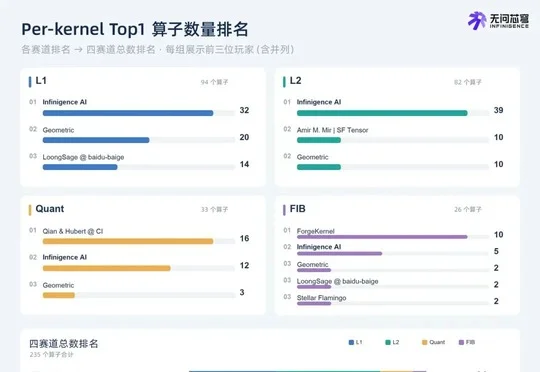
无问芯穹(Infinigence AI)以国产Agentic Infra让GPU算子优化Agent登顶NVIDIA Research的SOL-ExecBench四项赛道,并通过Skills、共享Memory和隔离评测形成自我迭代闭环,揭示资源调度与工作流设计对RSI效率的影响。