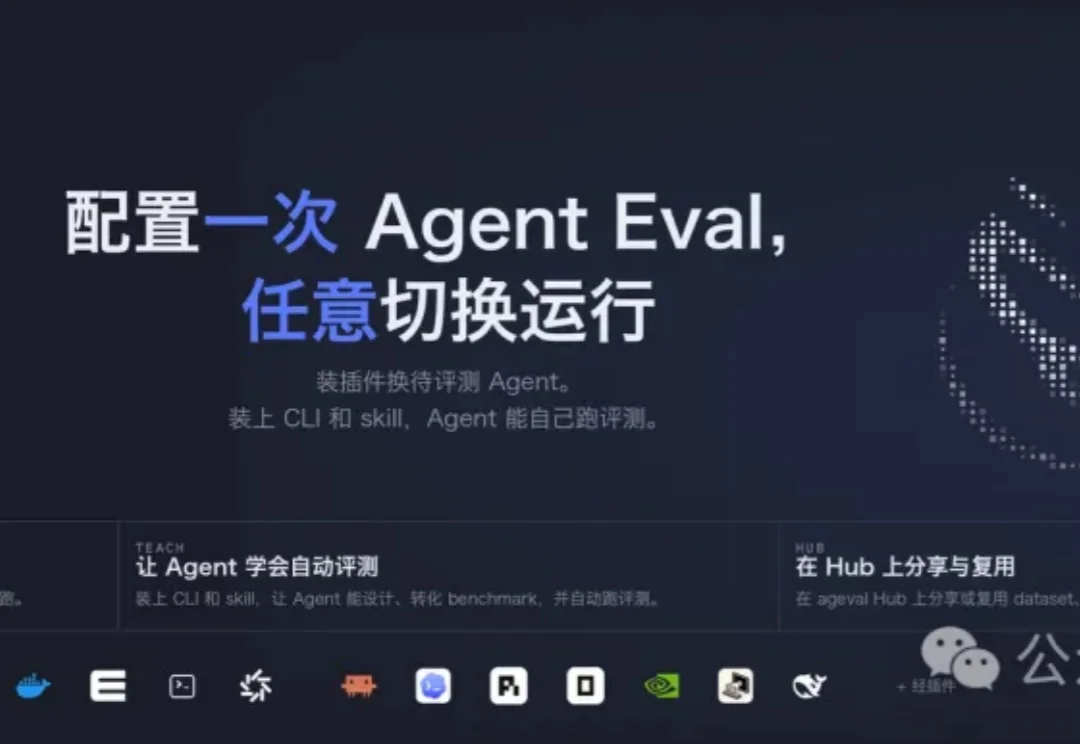
配套CLI与Skills,浙大开源可插拔Agent评测底座
配套CLI与Skills,浙大开源可插拔Agent评测底座同一套模型,换一个coding agent运行时,测试得分和实际消耗往往大相径庭。
来自主题: AI技术研报
8835 点击 2026-09-14 09:49

 搜索
同一套模型,换一个coding agent运行时,测试得分和实际消耗往往大相径庭。
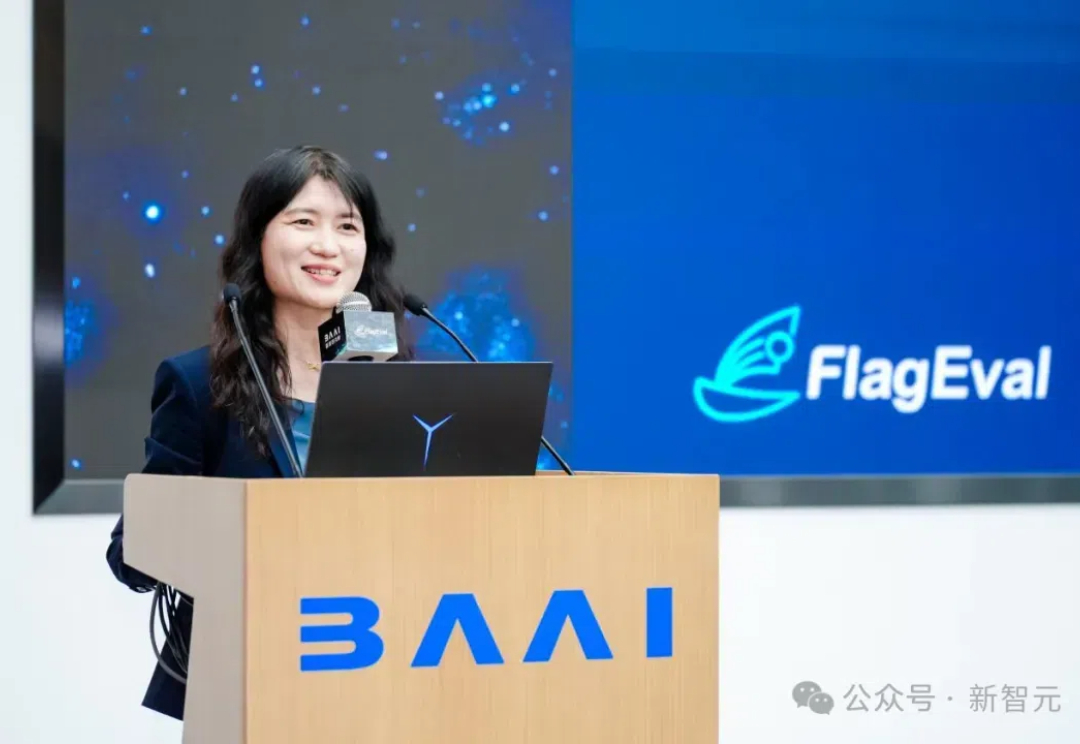
2024年快要结束了,世界大模型究竟孰强孰弱?刚刚,智源研究院发布了下半年大模型综合评测结果,涵盖了开源闭源100+模型,横跨文本、语音、图像和视频等多个领域。

2024年12月19日,智源研究院发布并解读国内外100余个开源和商业闭源的语言、视觉语言、文生图、文生视频、语音语言大模型综合及专项评测结果。
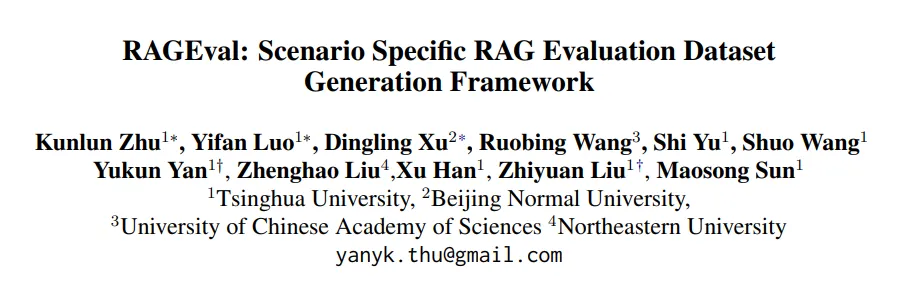
清华大学NLP实验室联合北京师范大学、中国科学院大学、东北大学等机构的研究人员推出了全新的评测方法 RAGEval,通过快速构建场景化评估数据实现对检索增强生成(RAG)系统的“精准诊断”。