大模型的数据生意:人类如何蒸馏自己
大模型的数据生意:人类如何蒸馏自己成都中和与天津侯台都是城郊结合处的老村镇。一群人在这里为大型互联网公司训练大模型,大多月薪不足 1 万元。
来自主题: AI资讯
8529 点击 2026-11-06 10:31

 搜索
成都中和与天津侯台都是城郊结合处的老村镇。一群人在这里为大型互联网公司训练大模型,大多月薪不足 1 万元。
DeepSeek Harness 团队前几天发了篇关于 Super-agent 设计探索的长文,想用 Router + Worker 双层架构,把一个人管理多个 Agent 的负担交给系统。文章出来后讨论不少,大多关注这套调度机制是怎么设计的。
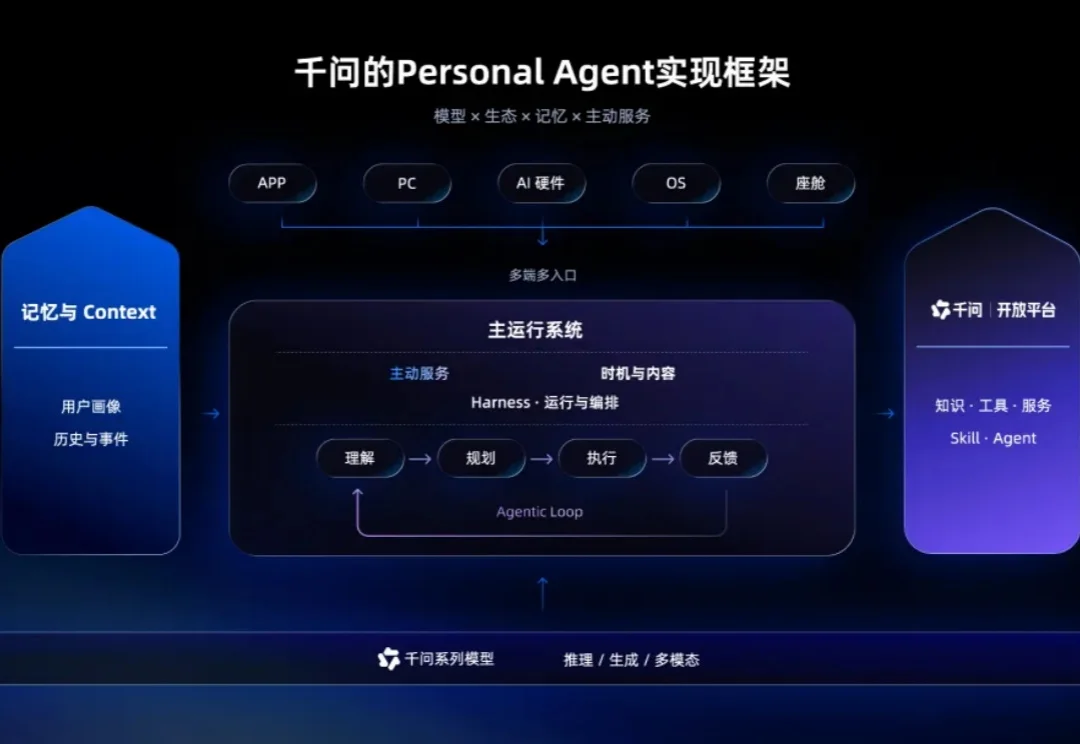
Personal Agent 撕开了一道 AI 应用的口子。
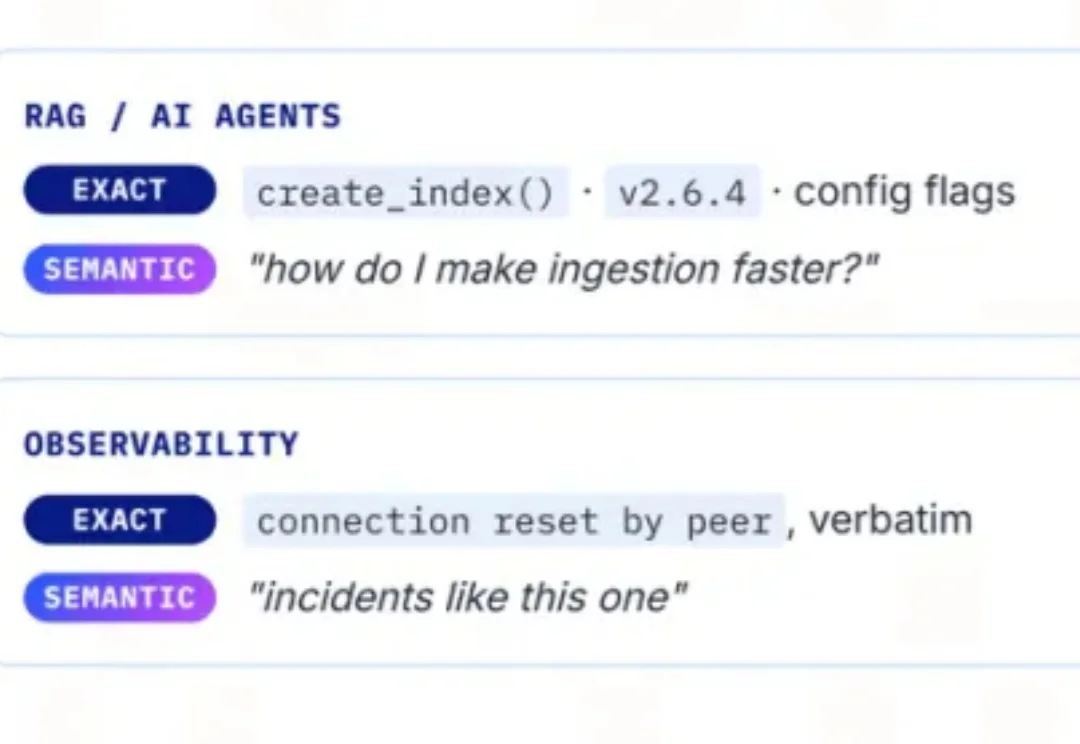
在RAG与Agent、法律以及电商等场景中,语义+关键词的混合检索已经成为越来越多搜索应用的常规配置。
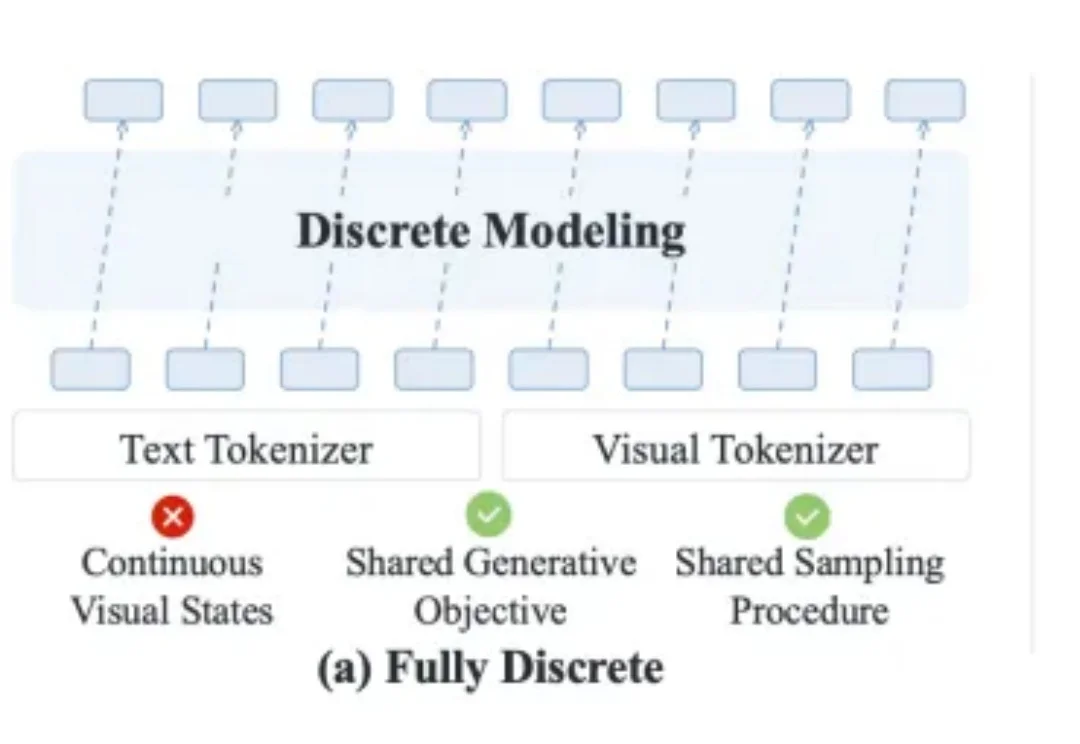
走向物理 AI 时代,构建一个能真正统一语言与视觉的多模态基座模型是关键一步。然而,语言本质上是有序的 Token 序列,视觉则是连续的高维像素分布,两者在信息结构上存在天然的鸿沟。如何在一个模型内统一这两种截然不同的分布,一直是一个备受争论的话题。
OpenAI 最近公布了一组 ChatGPT 的新数据,有几个变化挺有意思:
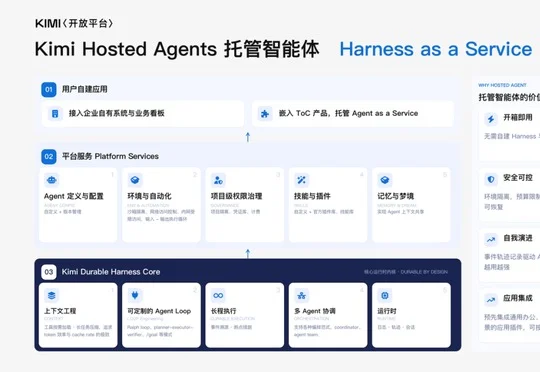
Kimi Hosted Agents 正式发布,以 Harness as a Service 提供7×24小时托管环境,支持长程任务、多智能体协作、安全控制、审计及140+ Skills、30+插件和8个金融Agent模板。
百度开源文心 5.5 Flash Base(ERNIE 5.5 Flash Base)权重,该模型总参数280B、每token激活14B,采用稀疏MoE与混合稀疏注意力,微调和推理上下文外扩至1M tokens。
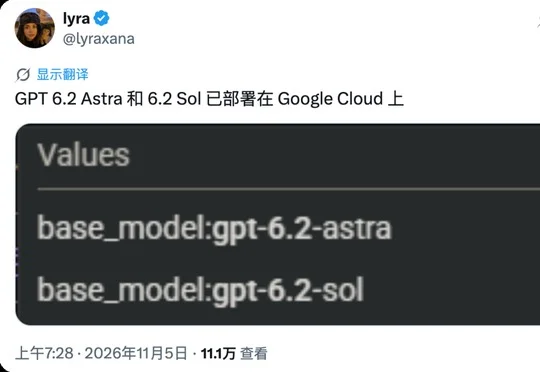
据 The Information 报道,OpenAI 最快本周五推出 GPT-6.2 Astra、Sol 等下一代模型;Anthropic Claude Code 与 Cowork 总产品负责人 Cat Wu 已离职并加入 OpenAI Core Products 部门。
Anthropic招股书披露前沿AI灾难性风险及创始人特殊投票权安排,访谈同时指出,有效利他主义通过资金与人才集聚主导AI安全叙事,并引发机构独立性和权力争议。