AI资讯新闻榜单内容搜索-o

AITNT-国内领先的一站式人工智能新闻资讯网站
# 热门搜索 #
搜索: o
最牛的 AI 应用开发者,都在做 AI 浏览器

最牛的 AI 应用开发者,都在做 AI 浏览器

最牛的 AI 应用开发者,都在做 AI 浏览器

The Browser Company 是一家明星且特别的公司。

来自主题: AI资讯
9082 点击    2025-04-03 16:50
OpenAI的吉卜力,撞车了被字节起诉“投毒AI”的前实习生?

OpenAI的吉卜力,撞车了被字节起诉“投毒AI”的前实习生?

OpenAI的吉卜力,撞车了被字节起诉“投毒AI”的前实习生?

想象一下,耗费动画大师宫崎骏数十年心血、一帧一画精雕细琢的艺术风格——比如《起风了》中耗时一年多的四秒人群场景,或是《幽灵公主》里那个生物钻地镜头背后一年零七个月的 5300 帧手绘,如今,在GPT-4o手中,似乎变得“唾手可得”。
来自主题: AI资讯
12443 点击    2025-04-03 16:37
AMD GPU性能暴涨7倍,优化算法首次开源!高效MoE支持任意专家数量

AMD GPU性能暴涨7倍,优化算法首次开源!高效MoE支持任意专家数量

AMD GPU性能暴涨7倍,优化算法首次开源!高效MoE支持任意专家数量

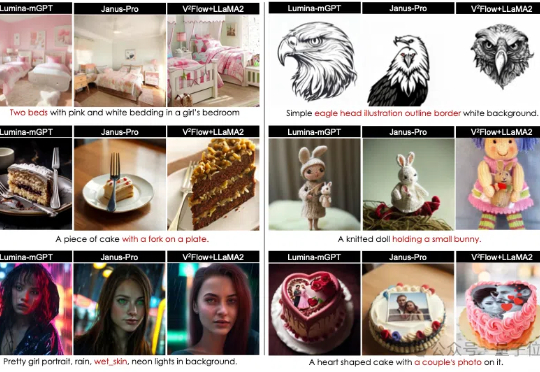
通过完全启用并发多块执行,支持任意专家数量(MAX_EXPERT_NUMBER==256),并积极利用共享内存(5kB LDS)和寄存器(52 VGPRs,48 SGPRs),MoE Align & Sort逻辑被精心设计,实现了显著的性能提升:A100提升3倍,H200提升3倍,MI100提升10倍,MI300X/MI300A提升7倍...
来自主题: AI技术研报
6097 点击    2025-04-03 16:14
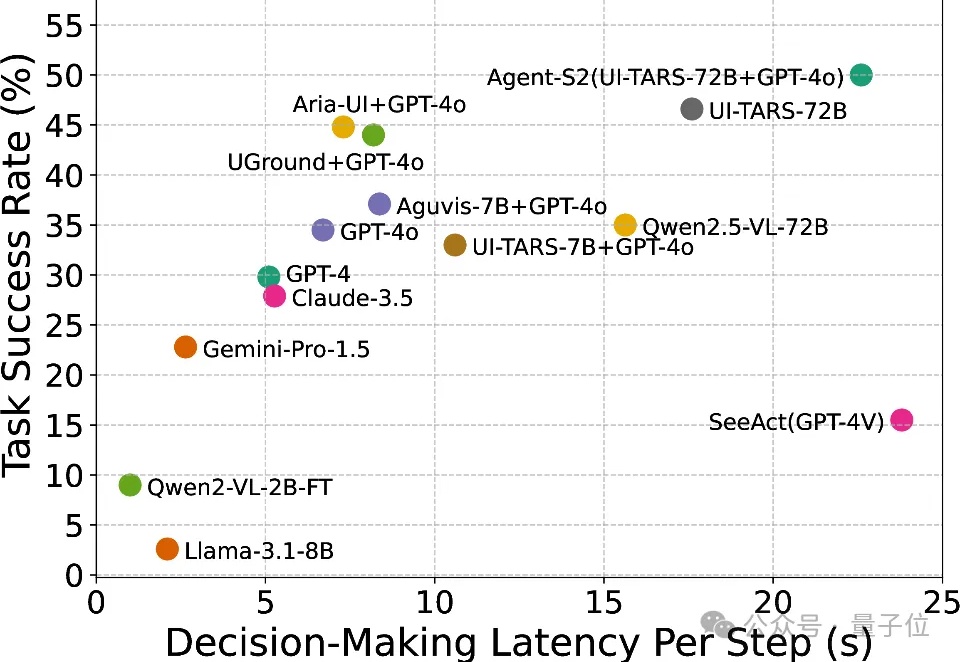
智能体丝滑玩手机,决策延迟0.7秒!MSRA等提出验证器架构,不直接依赖大模型生成最终操作

智能体丝滑玩手机,决策延迟0.7秒!MSRA等提出验证器架构,不直接依赖大模型生成最终操作

智能体丝滑玩手机,决策延迟0.7秒!MSRA等提出验证器架构,不直接依赖大模型生成最终操作

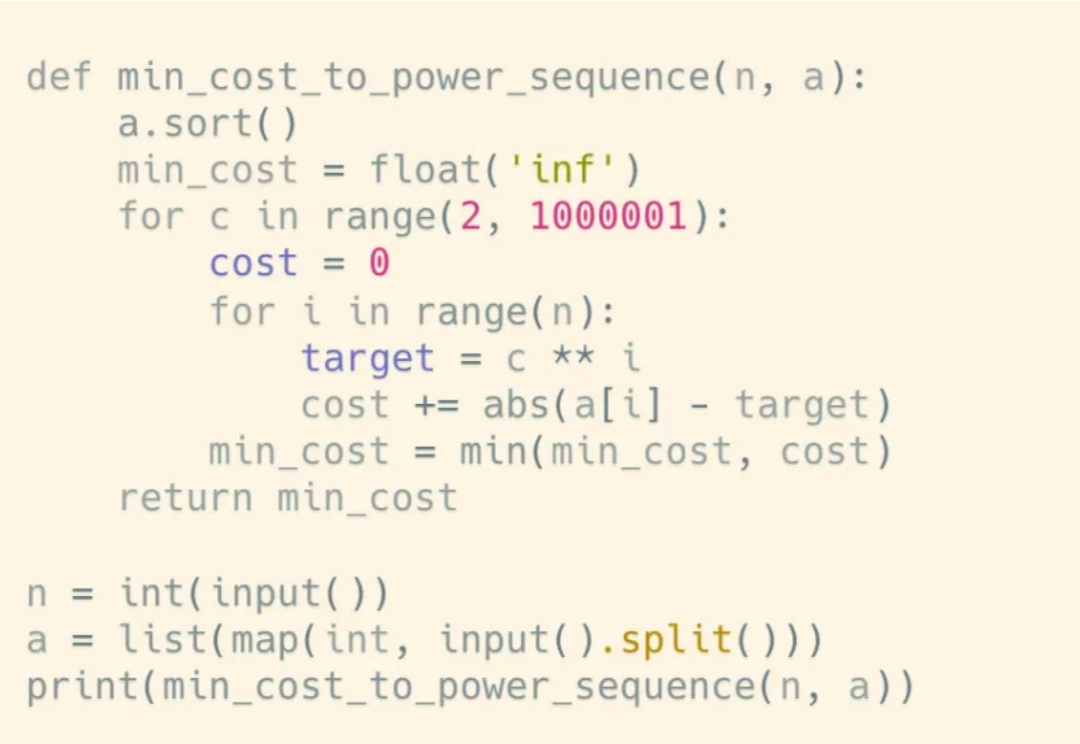
随着人工智能和大语言模型(LLMs)的不断突破,如何将其优势赋能于现实世界中可实际部署的高效工具,成为了业界关注的焦点。
来自主题: AI技术研报
5174 点击    2025-04-03 15:19
让AI替码农卷复杂任务,贾佳亚团队提出MoTCoder,准确率刷新SOTA

让AI替码农卷复杂任务,贾佳亚团队提出MoTCoder,准确率刷新SOTA

让AI替码农卷复杂任务,贾佳亚团队提出MoTCoder,准确率刷新SOTA

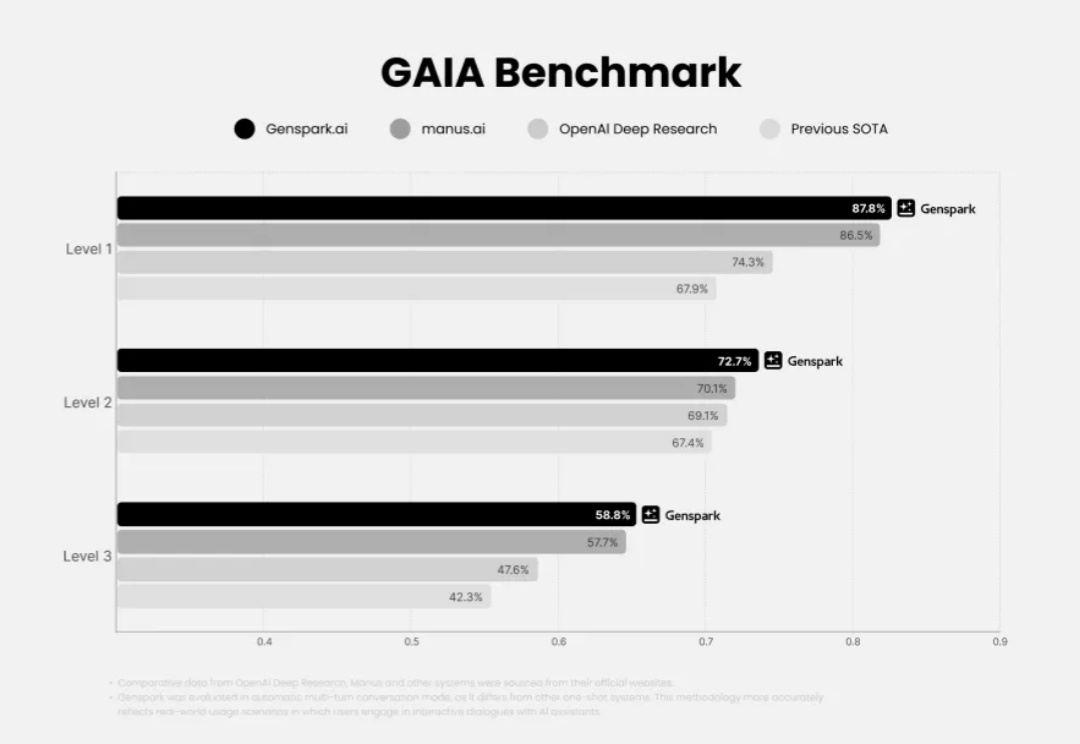
大模型写代码早就是基操了,但让它写算法竞赛题或企业级系统代码,就像让只会煮泡面的人去做满汉全席 —— 生成的代码要么是 “铁板一块” 毫无章法,要么是 “一锅乱炖” 难以维护。
来自主题: AI技术研报
10639 点击    2025-04-03 15:12
超越 Manus?华人创业产品 Genspark 推出通用 Agent(附实测效果)

超越 Manus?华人创业产品 Genspark 推出通用 Agent(附实测效果)

超越 Manus?华人创业产品 Genspark 推出通用 Agent(附实测效果)

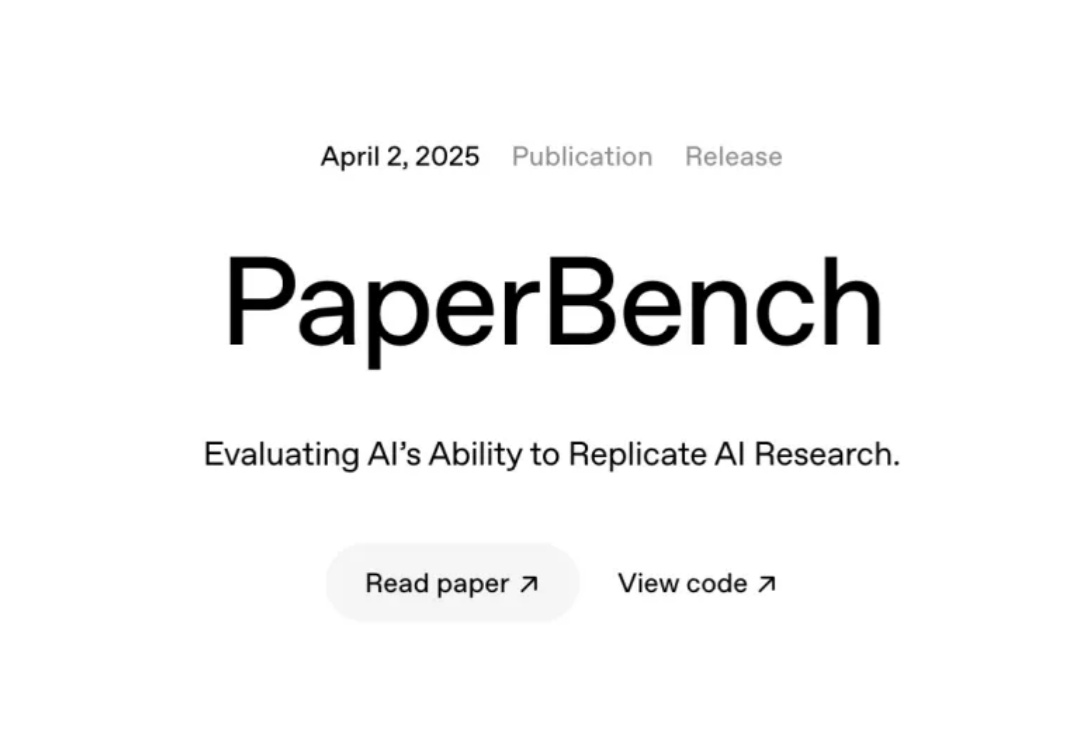
Genspark 是啥?我们在去年 6 月就有过介绍,Genspark 是由前百度小度的 CEO 景鲲和 CTO 朱凯华创业做的 Agent 产品,去年刚开始的定位还是 Agent Search Engine,到了今天升级了不少。并且在今年三月,官宣拿到了一亿美金的 A 轮融资。
来自主题: AI资讯
13288 点击    2025-04-03 11:03
OpenAI 刚刚开源了 PaperBench,用于评估 Agent 复现顶尖论文能力!

OpenAI 刚刚开源了 PaperBench,用于评估 Agent 复现顶尖论文能力!

OpenAI 刚刚开源了 PaperBench,用于评估 Agent 复现顶尖论文能力!

PaperBench 是一个由 OpenAI 开发的基准测试,旨在评估 AI Agent 复现尖端 AI 研究的能 力。它专注于测试 AI 是否能理解研究论文、独立开发代码并执行实验以复现研究结果。
来自主题: AI技术研报
9945 点击    2025-04-03 10:57
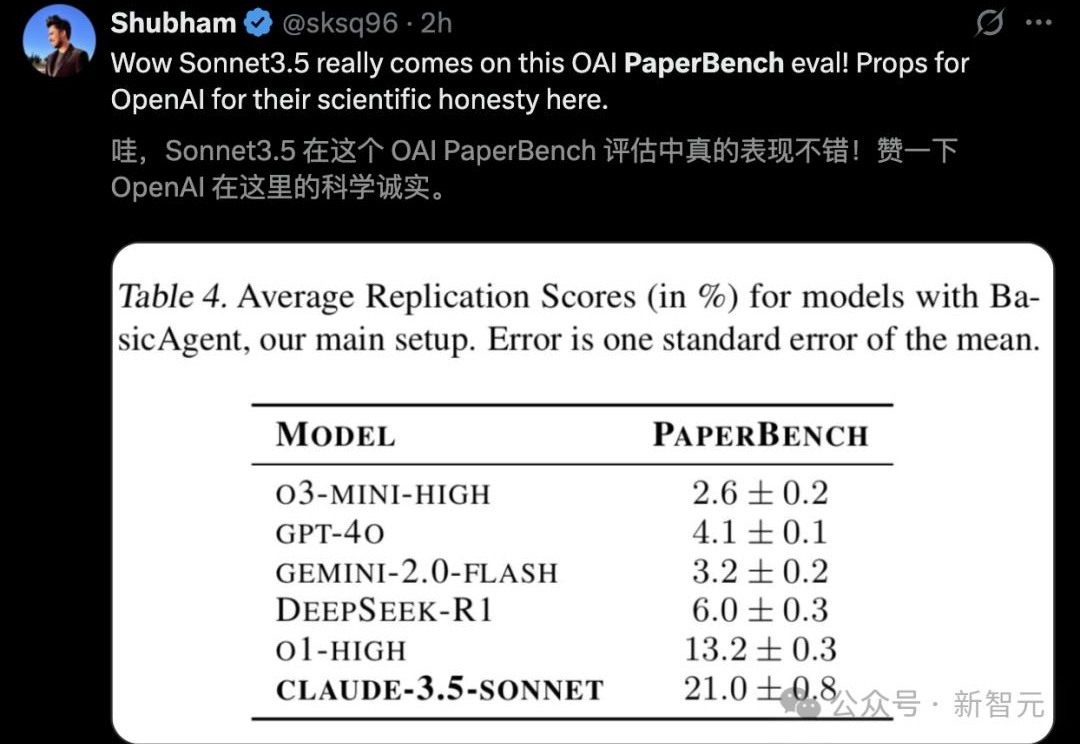
OpenAI官方基准测试:承认Claude遥遥领先(狗头)

OpenAI官方基准测试:承认Claude遥遥领先(狗头)

OpenAI官方基准测试:承认Claude遥遥领先(狗头)

刚刚开源的新基准测试PaperBench,6款前沿大模型驱动智能体PK复现AI顶会论文,新版Claude-3.5-Sonnet显著超越o1/r1排名第一。与去年10月OpenAI考验Agent机器学习代码工程能力MLE-Bnch相比,PaperBench更考验综合能力,不再是只执行单一任务。

来自主题: AI资讯
11355 点击    2025-04-03 10:37