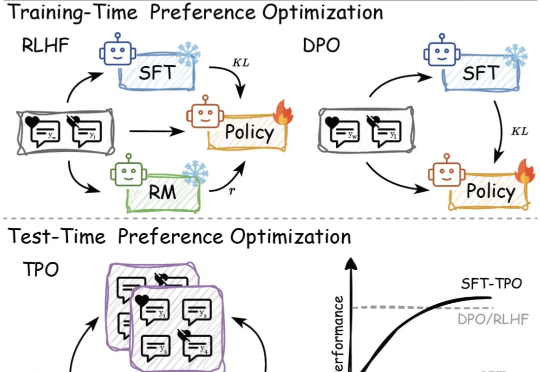
推理时也能做偏好优化,无需额外重训练,来自上海AI Lab港中文等
推理时也能做偏好优化,无需额外重训练,来自上海AI Lab港中文等传统的偏好对⻬⽅法,如基于⼈类反馈的强化学习(RLHF)和直接偏好优化(DPO),依赖于训练过程中的模型参数更新,但在⾯对不断变化的数据和需求时,缺乏⾜够的灵活性来适应这些变化。
来自主题: AI技术研报
9794 点击 2025-02-10 17:19

 搜索
传统的偏好对⻬⽅法,如基于⼈类反馈的强化学习(RLHF)和直接偏好优化(DPO),依赖于训练过程中的模型参数更新,但在⾯对不断变化的数据和需求时,缺乏⾜够的灵活性来适应这些变化。
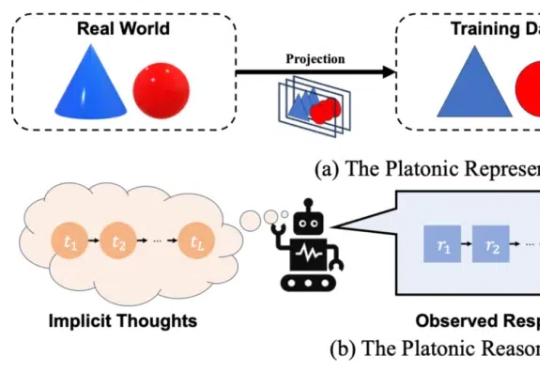
「慢思考」(Slow-Thinking),也被称为测试时扩展(Test-Time Scaling),成为提升 LLM 推理能力的新方向。近年来,OpenAI 的 o1 [4]、DeepSeek 的 R1 [5] 以及 Qwen 的 QwQ [6] 等顶尖推理大模型的发布,进一步印证了推理过程的扩展是优化 LLM 逻辑能力的有效路径。
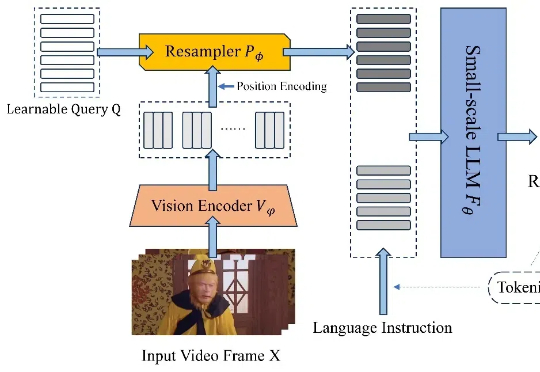
近日,北京航空航天大学的研究团队基于 TinyLLaVA_Factory 的原项目,推出小尺寸简易视频理解框架 TinyLLaVA-Video,其模型,代码以及训练数据全部开源。在计算资源需求显著降低的前提下,训练出的整体参数量不超过 4B 的模型在多个视频理解 benchmark 上优于现有的 7B + 模型。
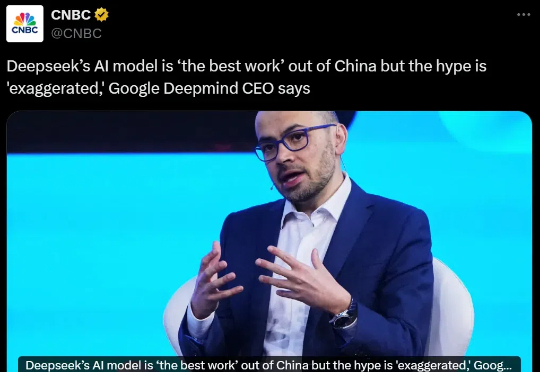
xAI、谷歌DeepMind和Anthropic的CEO们纷纷对DeepSeek的技术创新性提出质疑,认为其并未带来实质性的科学突破。AI大佬纷纷泼冷水,到底是技术讨论还是各怀目的?
DreamTech,由牛津大学、南京大学等顶尖高校研究者组成的AI创业团队,在春节期间公布了他们在3D生成方向上的新工作成果——Neural4D 2.0(初版名为Direct3D),提出了创新性的3D Assembly Generation算法思路及更高效的模型架构
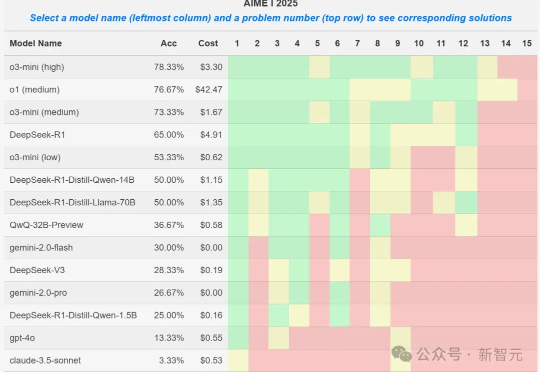
就在刚刚,AIME 2025 I数学竞赛的大模型参赛结果出炉,o3-mini取得78%的最好成绩,DeepSeek R1拿到了65%,取得第四名。然而一位教授却发现,某些1.5B小模型竟也能拿到50%,莫非真的存在数据集污染?
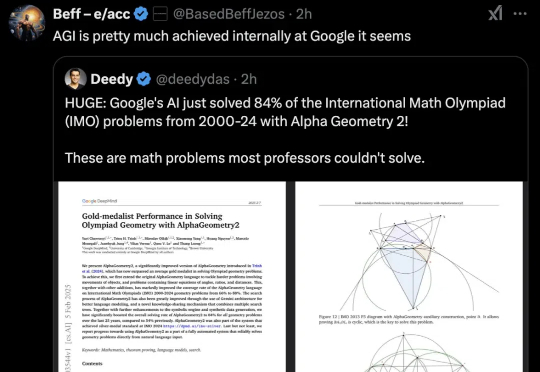
谷歌DeepMind的AI,终于拿下IMO金牌了!六个月前遗憾摘银,如今一举得金,SKEST新算法立大功。这不,它首破解了2009 IMO最难几何题,辅助作图的神来之笔解法让谷歌研究员当场震惊。
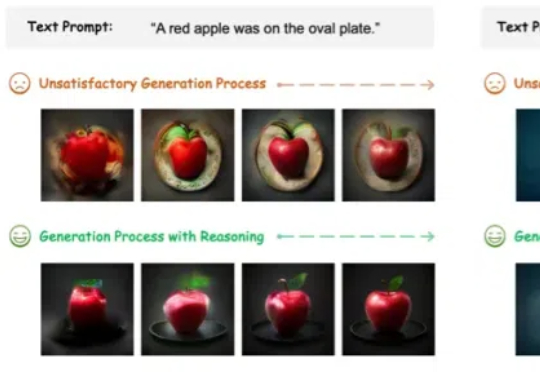
图像生成模型,也用上思维链(CoT)了!此外,作者还提出了两种专门针对该任务的新型奖励模型——潜力评估奖励模型。(Potential Assessment Reward Model,PARM)及其增强版本PARM++。
新年伊始,在估值攀上 3400 亿美元的新巅峰后,OpenAI 也辞旧迎新,更换了新字体、新标志、新配色方案,进行了一次全面的品牌重塑。Open AI 这次重塑的目的,一是为了摆脱设计总监 Shannon Jager 所说的「OpenAI 一直在用相当随意的方式,向世界展示自己。字体、Logo 和颜色的杂乱无章,只会彰显出公司缺乏明确的统一战略。」
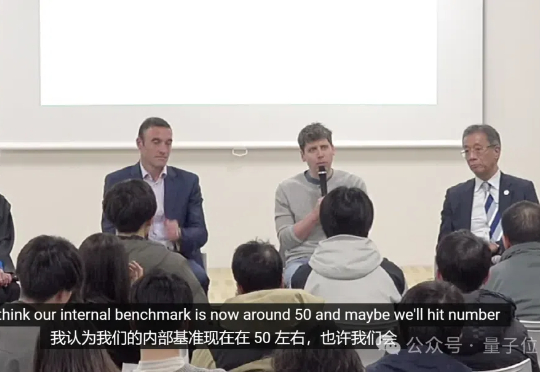
除了o1/o3,OpenAI另一个尚未公开的内部推理模型曝光了。爆料者正是CEO奥特曼本人。据他透露,与全球顶尖程序员相比,当前这一内部模型的编程能力已达Top50,甚至今年年底将排名第一。