ICML 2024 | 梯度检查点太慢?不降速、省显存,LowMemoryBP大幅提升反向传播显存效率
ICML 2024 | 梯度检查点太慢?不降速、省显存,LowMemoryBP大幅提升反向传播显存效率自从大型 Transformer 模型逐渐成为各个领域的统一架构,微调就成为了将预训练大模型应用到下游任务的重要手段
来自主题: AI技术研报
12131 点击 2024-07-12 17:47

 搜索
自从大型 Transformer 模型逐渐成为各个领域的统一架构,微调就成为了将预训练大模型应用到下游任务的重要手段
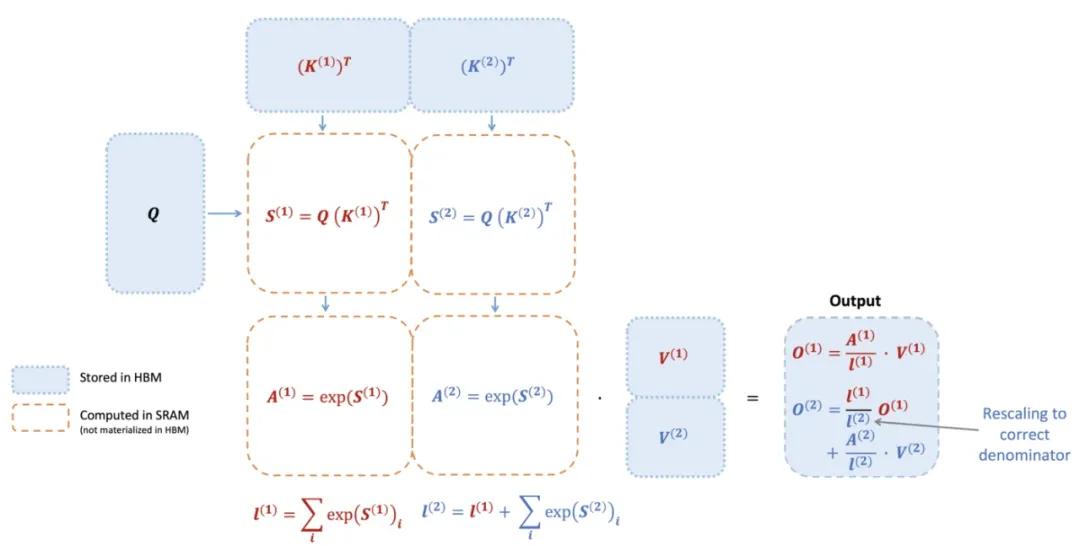
740 TFLOPS!迄今最强 FlashAttention 来了。
生成式模型原本被设计来模仿人类的各种复杂行为,但人们普遍认为它们最多只能达到与其训练数据中的专家相当的水平。不过,最新的研究突破了这一限制,表明在特定领域,如国际象棋,通过采用低温采样技术,这些模型能够超越它们所学习的那些专家,展现出更高的能力。

斯坦福炒虾机器人团队时隔半年再出新作,谷歌最强Gemini 1.5 Pro加持,Mobility VLA让机器人在836平方米的办公室里轻松导航。
OpenAI全新的AGI路线图,刚刚被曝出了!OpenAI将AI划分为5个等级,自称其AI模型正处于L1,但很快就会达到L2(推理者)。而根据其前研究员预测,五级AGI最快将在27年实现。
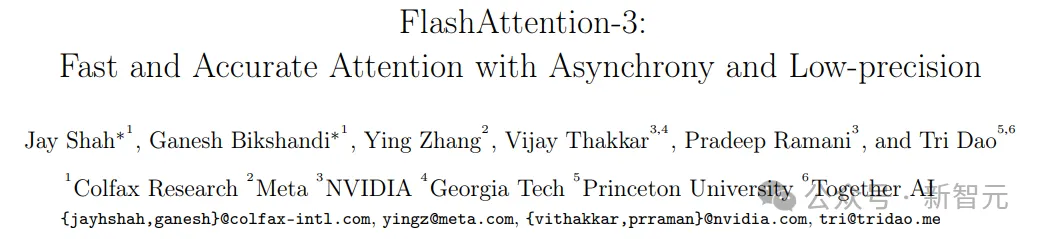
时隔一年,FlashAttention又推出了第三代更新,专门针对H100 GPU的新特性进行优化,在之前的基础上又实现了1.5~2倍的速度提升。
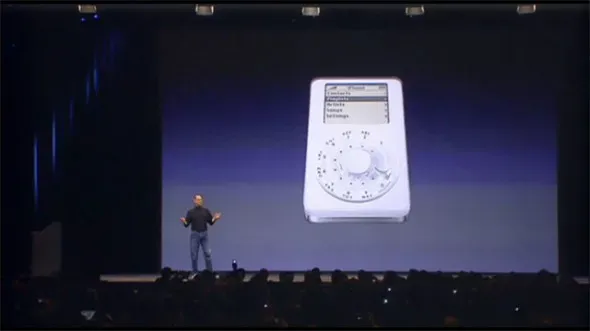
这期对谈如果要提炼出一个核心观点,我想就是——人工智能的持续进步,现在需要开创性的用户界面和产品体验,但这不只是一个技术活儿,也是一个艺术活儿,才能把尖端科技用柔软轻盈的方式带入到大众的生活里。
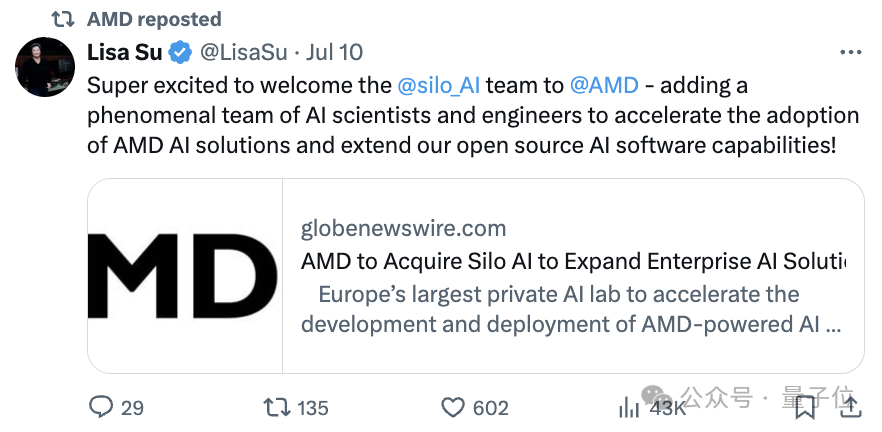
芯片巨头AMD刚刚官宣要再做大做强:
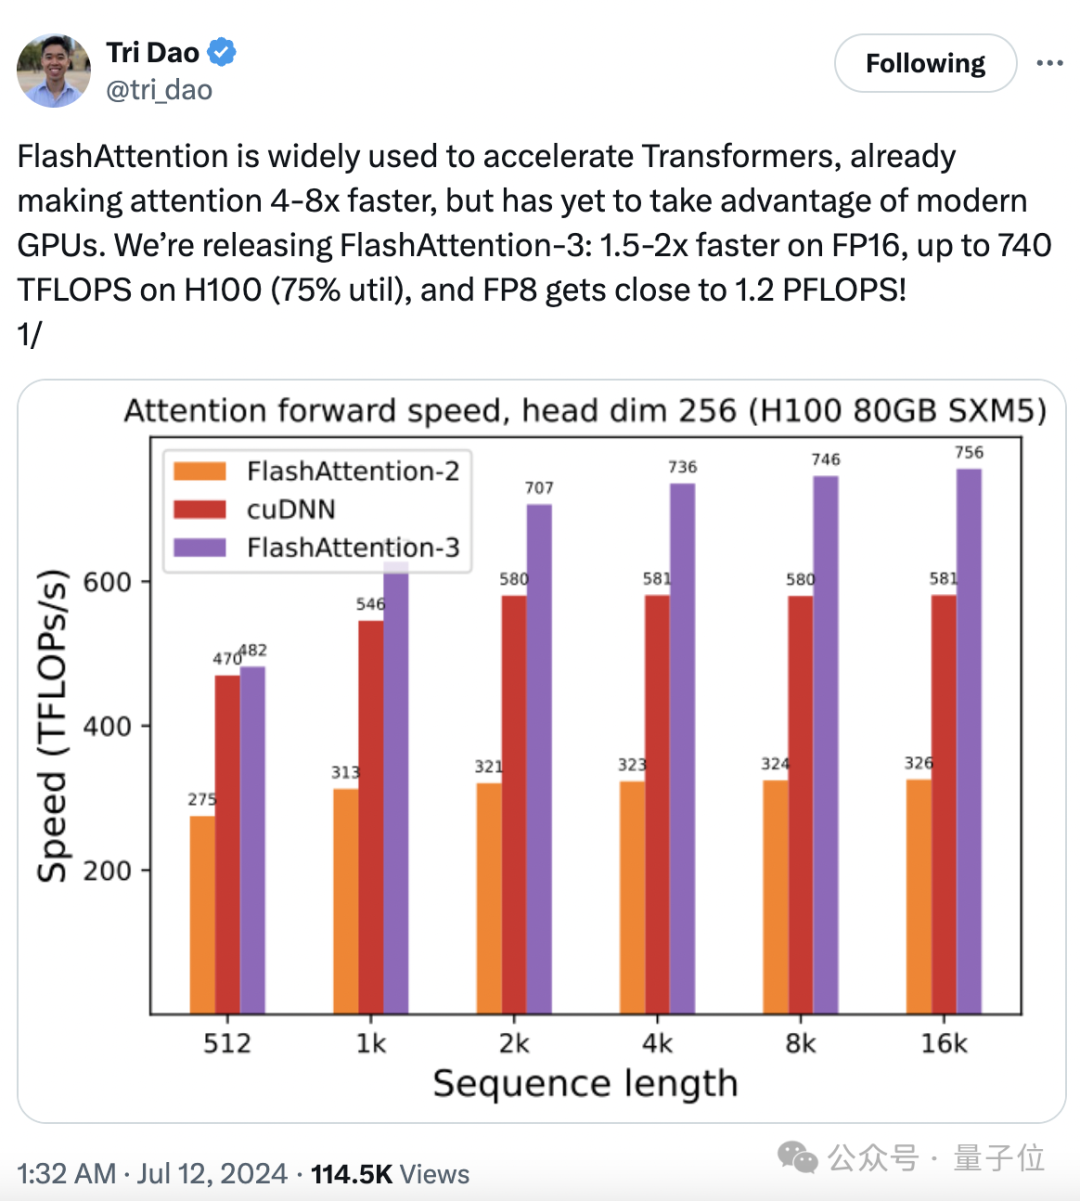
大模型训练推理神作,又更新了!

“让个人按照自己的方式探索世界,重新定义旅行。”