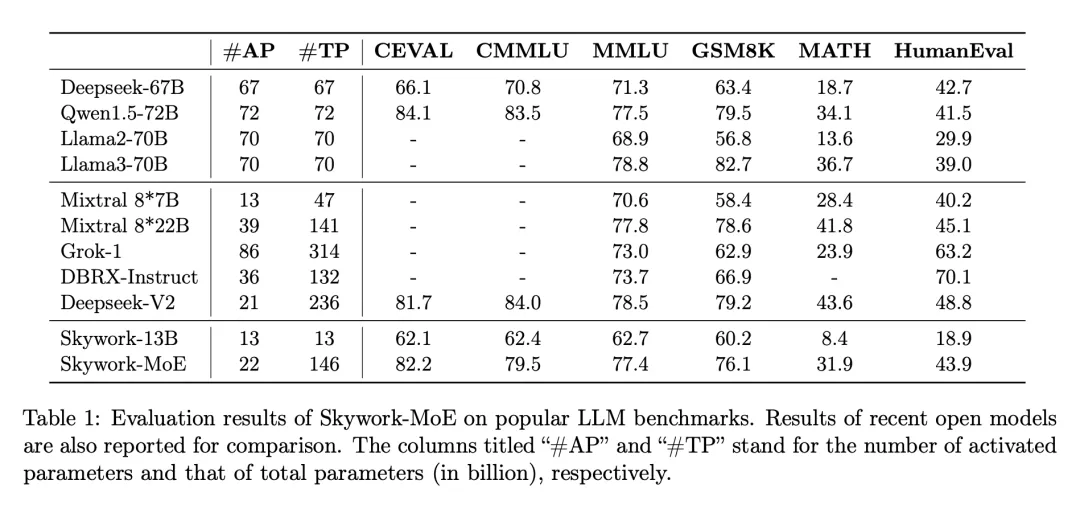
单个4090可推理,2000亿稀疏大模型「天工MoE」开源
单个4090可推理,2000亿稀疏大模型「天工MoE」开源在大模型浪潮中,训练和部署最先进的密集 LLM 在计算需求和相关成本上带来了巨大挑战,尤其是在数百亿或数千亿参数的规模上。为了应对这些挑战,稀疏模型,如专家混合模型(MoE),已经变得越来越重要。这些模型通过将计算分配给各种专门的子模型或「专家」,提供了一种经济上更可行的替代方案,有可能以极低的资源需求达到甚至超过密集型模型的性能。
搜索
在大模型浪潮中,训练和部署最先进的密集 LLM 在计算需求和相关成本上带来了巨大挑战,尤其是在数百亿或数千亿参数的规模上。为了应对这些挑战,稀疏模型,如专家混合模型(MoE),已经变得越来越重要。这些模型通过将计算分配给各种专门的子模型或「专家」,提供了一种经济上更可行的替代方案,有可能以极低的资源需求达到甚至超过密集型模型的性能。
你方唱罢我登场。
自 2017 年被提出以来,Transformer 已经成为 AI 大模型的主流架构,一直稳居语言建模方面 C 位。
大模型,大,能力强,好用!
最近发现一些AI行业里人才能力圈的有趣的变化,越来越多在一些AI公司里扛大旗的,不仅仅是某一个领域的专家,而且是绝对的斜杠青年。
Transformer挑战者、新架构Mamba,刚刚更新了第二代:
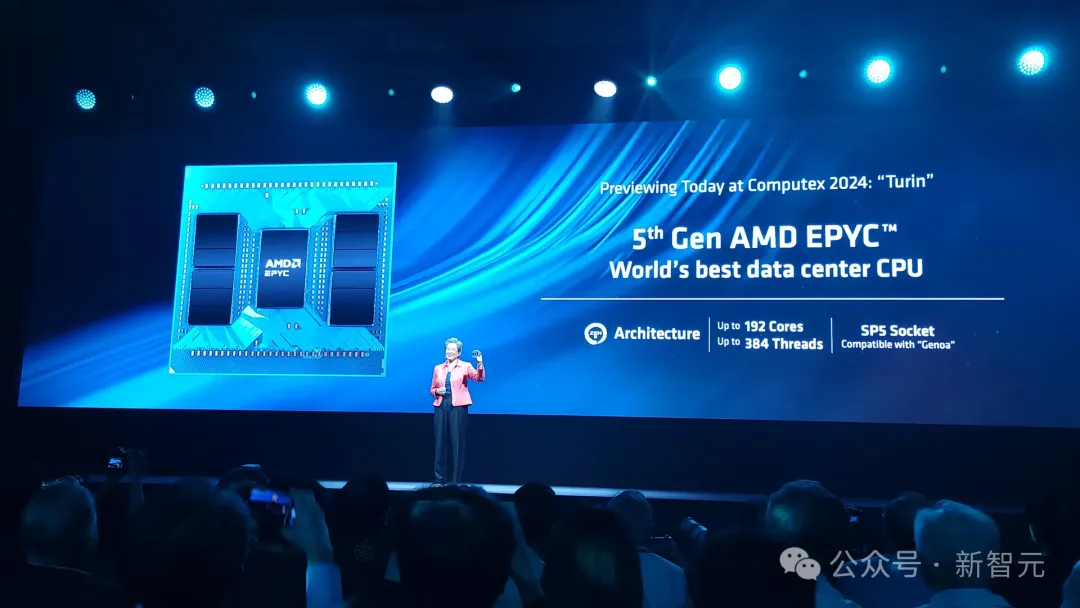
AMD在Computex主题演讲上大出风头,推出了首批Zen 5处理器,包括台式机用Ryzen 9000 CPU和笔记本电脑用Ryzen AI 300「Strix Point 」APU。除此之外,AMD还宣布了芯片年更计划以及备受期待的第五代EPYC Turin处理器。
微软发布首个大规模大气基础模型Aurora,可被用于预测和减轻极端天气影响,模型拥有超高的准确率和效率,与如今数值预报系统界的SOTA相比,它的计算速度提高了约5000倍。
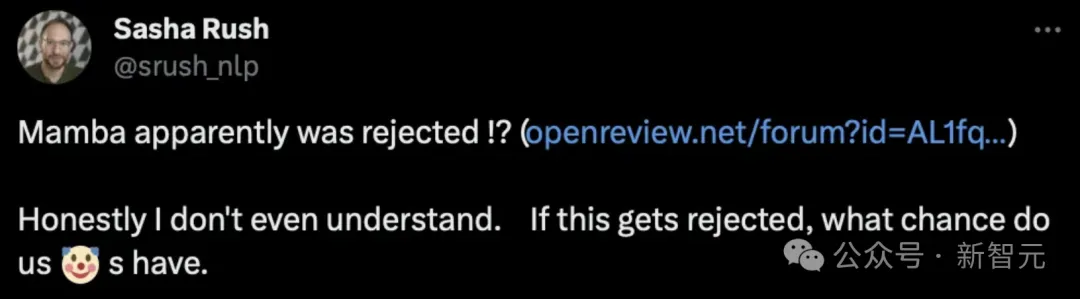
在开源社区引起「海啸」的Mamba架构,再次卷土重来!这次,Mamba-2顺利拿下ICML。通过统一SSM和注意力机制,Transformer和SSM直接成了「一家亲」,Mamba-2这是要一统江湖了?
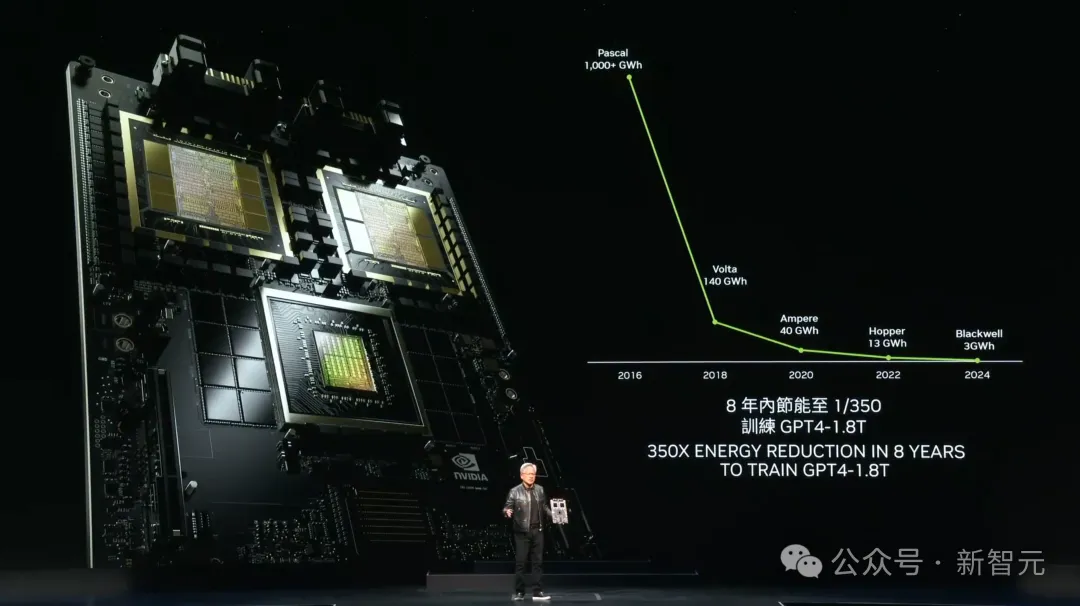
6 月 2 日,英伟达创始人黄仁勋在 Computex 2024(2024 台北国际电脑展)上发表主题演讲,分享了人工智能时代如何助推全球新产业革命,并且展示了最新的 Blackwell 芯片和后续的一系列更新节奏。