10M上下文,仅靠提示就掌握一门语言,Google Gemini 1.5被OpenAI抢头条是真冤
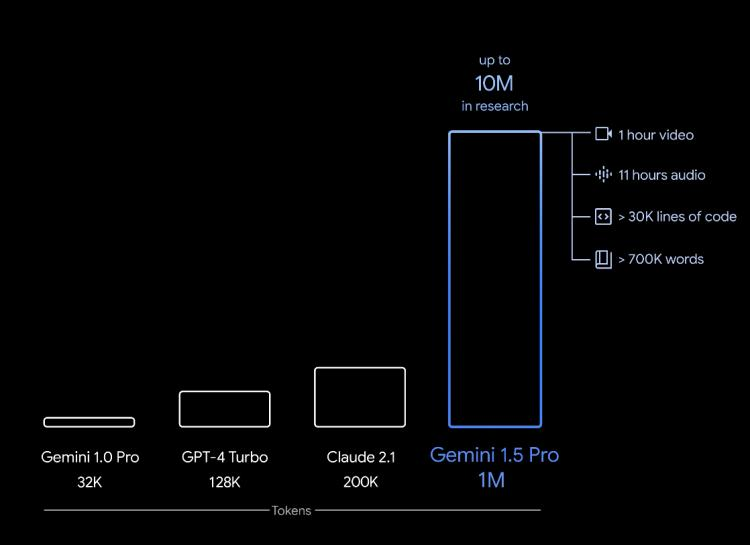
10M上下文,仅靠提示就掌握一门语言,Google Gemini 1.5被OpenAI抢头条是真冤这两天,几乎整个AI圈的目光都被OpenAI发布Sora模型的新闻吸引了去。其实还有件事也值得关注,那就是Google继上周官宣Gemini 1.0 Ultra 后,火速推出下一代人工智能模型Gemini 1.5。
搜索
这两天,几乎整个AI圈的目光都被OpenAI发布Sora模型的新闻吸引了去。其实还有件事也值得关注,那就是Google继上周官宣Gemini 1.0 Ultra 后,火速推出下一代人工智能模型Gemini 1.5。
简单粗暴的理解,就是语言能力足够强大之后,它带来的泛化能力直接可以学习图像视频数据和它体现出的模式,然后还可以直接用学习来的图像生成模型最能理解的方式,给这些利用了引擎等已有的强大而成熟的视频生成技术的视觉模型模块下指令,最终生成我们看到的逼真而强大的对物理世界体现出“理解”的视频。
刚刚,我们经历了LLM划时代的一夜。谷歌又在深夜发炸弹,Gemini Ultra发布还没几天,Gemini 1.5就来了。卯足劲和OpenAI微软一较高下的谷歌,开始进入了高产模式。
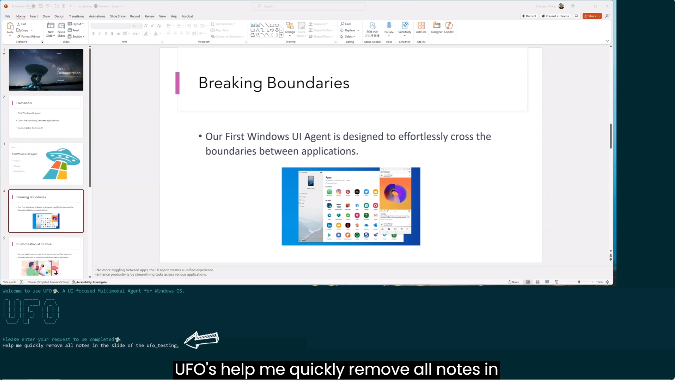
微软首个为Windows而设的智能体(Agent) 亮相:基于GPT-4V,一句话就可以在多个应用中无缝切换,完成复杂任务。整个过程无需人为干预,其执行成功率和效率是GPT-4的两倍,GPT-3.5的四倍。
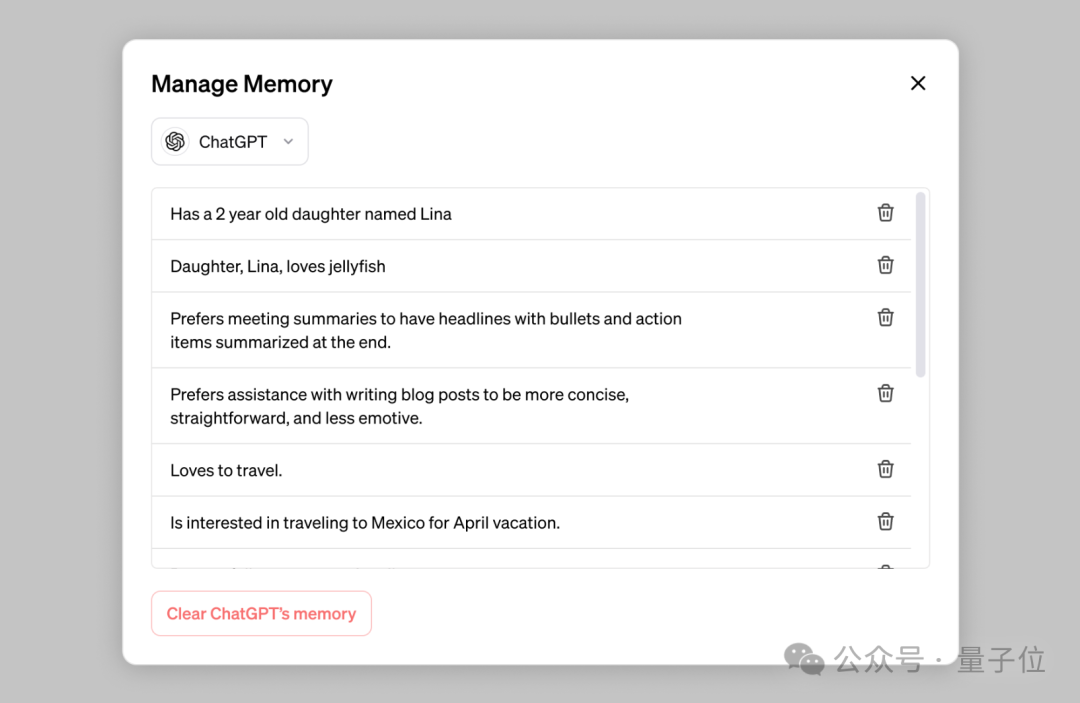
ChatGPT又要推出新功能了,这次名叫“记忆”(Memory)。如其名,作用就是让AI记住用户此前的对话内容。
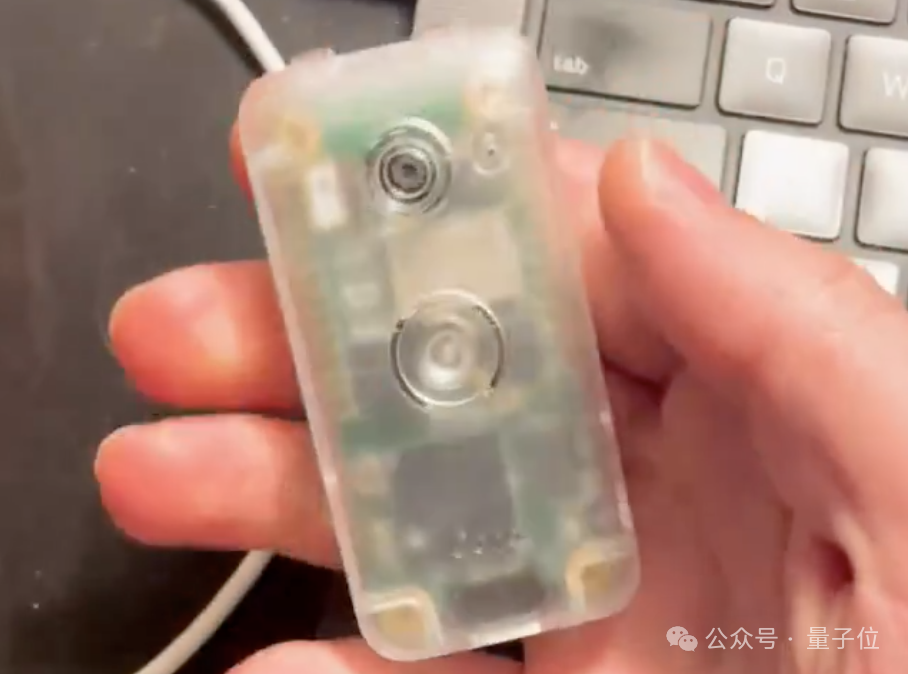
鹅妹子嘤!AI硬件,自己也能动手做了!只需一个小时,成本不到八百块。
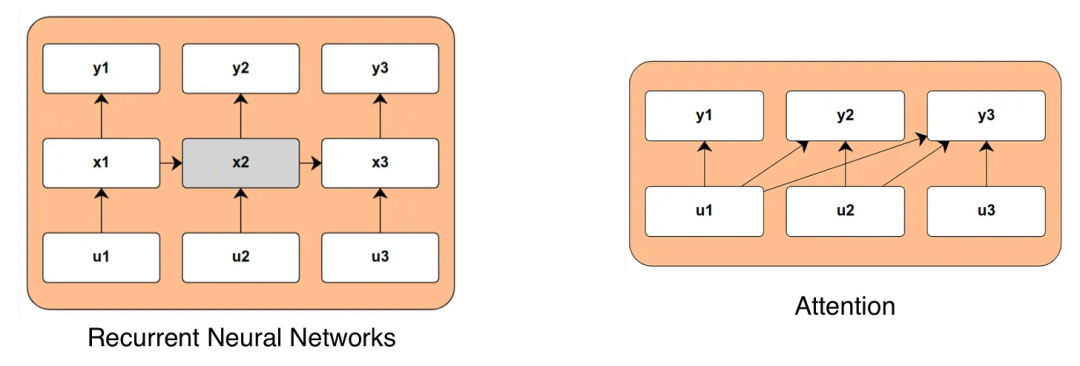
状态空间模型正在兴起,注意力是否已到尽头?
就在十几个小时之前,OpenAI再一次放出大招,发布了一个有望改变世界的产品,那就是文字生成视频的Sora模型。
一个刚上线的AI应用在海外小圈子里火了。 名叫PopAi,是个一站式个人AI工作空间,主打无缝集成聊天、阅读、写作、创作等工作需求。
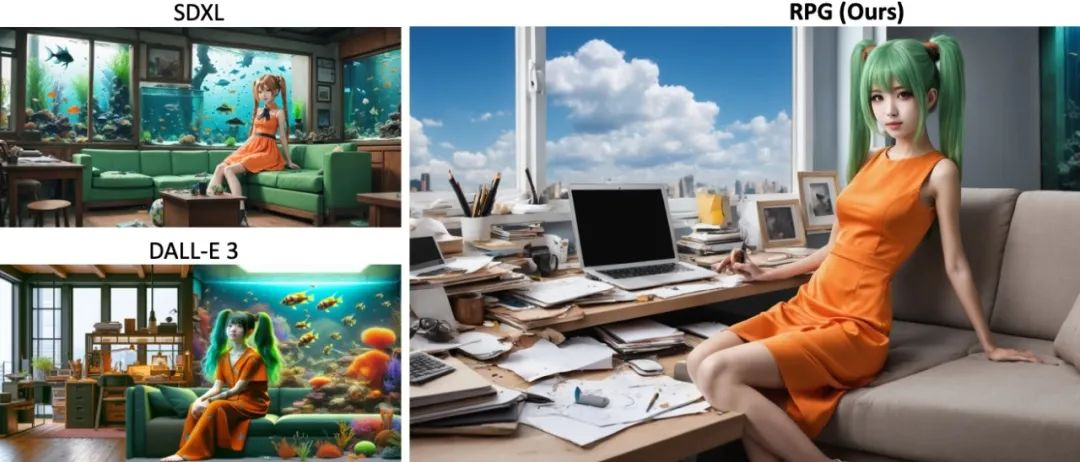
近日,北大、斯坦福、以及Pika Labs发布了新的开源文生图框架,利用多模态LLM的能力成功解决文生图两大难题,表现超越SDXL和DALL·E 3