无需再训练微调,一个辅助系统让GPT-5.2准确率飙到创纪录的75%
无需再训练微调,一个辅助系统让GPT-5.2准确率飙到创纪录的75%什么?决定 AI 上限的已不再是底座模型,而是外围的「推理编排」(Orchestration)。
来自主题: AI资讯
9016 点击 2025-12-25 14:19

 搜索
什么?决定 AI 上限的已不再是底座模型,而是外围的「推理编排」(Orchestration)。
英伟达让AI仅靠「看直播」就学会了通用游戏操作。虚拟世界已成为物理智能的黑客帝国,看4万小时直播学会几乎所有游戏!
平安夜老黄没有休息,一项200亿美元创纪录芯片收购消息,轰动硅谷。
Epoch AI年终大盘点来了!出乎意料的是,AI没有停滞,反而变快了。
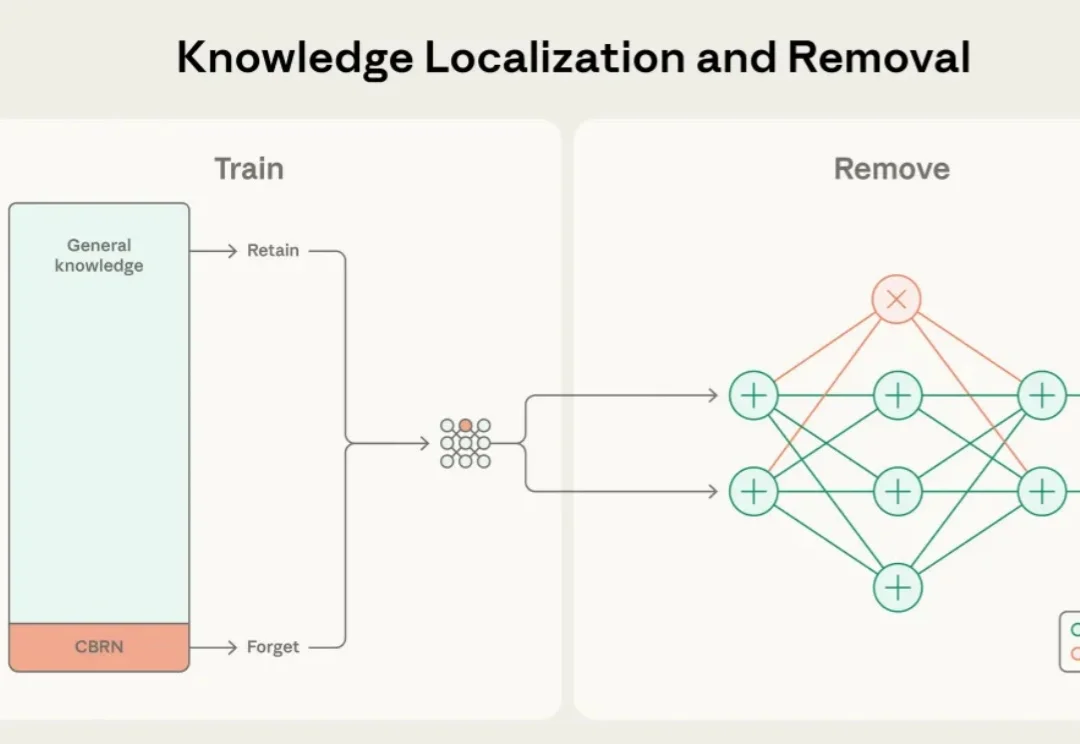
近年来,大语言模型的能力突飞猛进,但随之而来的却是愈发棘手的双重用途风险(dual-use risks)。当模型在海量公开互联网数据中学习时,它不仅掌握语言与推理能力,也不可避免地接触到 CBRN(化学、生物、放射、核)危险制造、软件漏洞利用等高敏感度、潜在危险的知识领域。
热门LoRA首次内置,控光换镜头实测可用。
视频生成模型总是「记性不好」?生成几秒钟后物体就变形、背景就穿帮?北大、中大等机构联合发布EgoLCD,借鉴人类「长短时记忆」机制,首创稀疏KV缓存+LoRA动态适应架构,彻底解决长视频「内容漂移」难题,在EgoVid-5M基准上刷新SOTA!让AI像人一样拥有连贯的第一人称视角记忆。
我们不会和 Meta 竞价,即便待遇远低于对方,核心人才仍愿意留在 OpenAI,只因大家坚信这里的发展潜力和 AGI 愿景。
首发 9988 元创始权益价,2026 年 1 月启动公测。

在代码大模型(Code LLMs)的预训练中,行业内长期存在一种惯性思维,即把所有编程语言的代码都视为同质化的文本数据,主要关注数据总量的堆叠。然而,现代软件开发本质上是多语言混合的,不同语言的语法特性、语料规模和应用场景差异巨大。