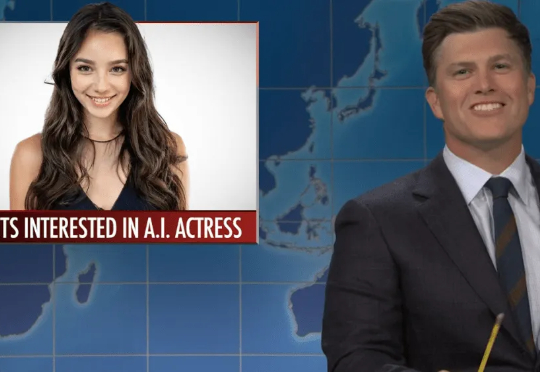
AI女演员勇闯好莱坞,却遭全行业怒怼!他们在害怕什么?(深度观察)
AI女演员勇闯好莱坞,却遭全行业怒怼!他们在害怕什么?(深度观察)这位女演员刚出道 同行就对她大喊:“F**k off!” 文 | 羊羊 编辑 | 羊羊、小小树 在上周的SNL节目中,联合主持人科林·乔斯特讲了一个关于AI的笑话。 据报道,好莱坞的经纪公司有意签约一
来自主题: AI资讯
11205 点击 2025-10-14 10:01

 搜索
这位女演员刚出道 同行就对她大喊:“F**k off!” 文 | 羊羊 编辑 | 羊羊、小小树 在上周的SNL节目中,联合主持人科林·乔斯特讲了一个关于AI的笑话。 据报道,好莱坞的经纪公司有意签约一
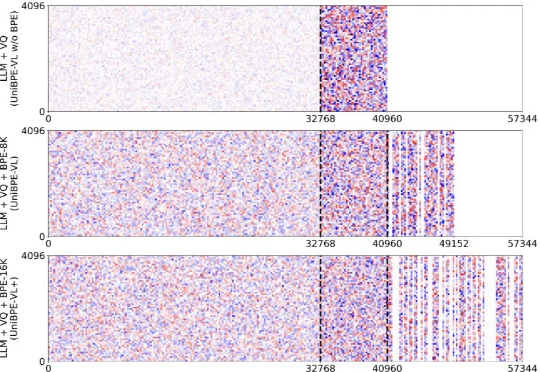
为此,北大、UC San Diego 和 BeingBeyond 联合提出一种新的方法——Being-VL 的视觉 BPE 路线。Being-VL 的出发点是把这一步后置:先在纯自监督、无 language condition 的设定下,把图像离散化并「分词」,再与文本在同一词表、同一序列中由同一 Transformer 统一建模,从源头缩短跨模态链路并保留视觉结构先验。
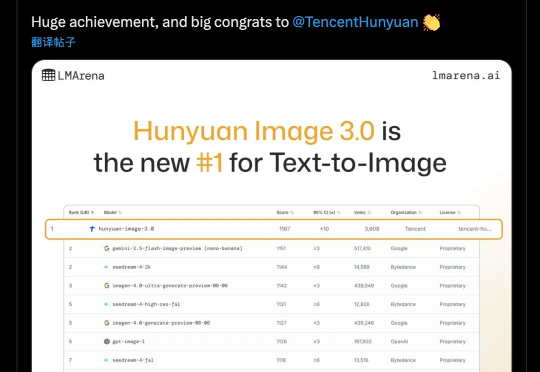
讲真,AI生图圈的内卷速度简直离谱。8月底的Nano Banana、9月中的即梦4.0已经把画质和效果卷到了一个新高度,但我还在纠结到底该把谁设为主力工具,因为总觉得他们差点什么:不是出错就是不懂场景。
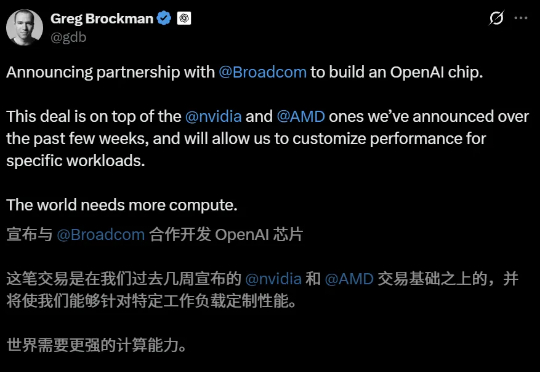
OpenAI终于官宣了!联手芯片巨头博通下场造AI芯片,预计2029年底部署10GW算力。内部已秘密研发18个月,首颗芯片9个月后量产,AI领域的M1时刻将至。
又一批AI社交公司与产品悄悄「死亡」了。今年9月,一批AI社交公司发布关停或通知,这之中,既包括大模型明星公司、社交公司等中型企业,如阶跃星辰To C产品「冒泡鸭」、Soul旗下的AI应用「异世界回响」等,也包括一批垂直领域的初创产品,如定位AI情感分析的Lumi、由前苹果设计师Jason Yuan创立的情感陪伴应用Dot等。
人工智能真是日新月异。早上看到网友的评论:我们已经 0 天没有吸引注意的 AI 领域新突破了。记得三个月前,OpenAI 官宣了他们的推理模型在国际数学奥林匹克(IMO)竞赛中获得了金牌。
说出概念,SAM 3 就明白你在说什么,并在所有出现的位置精确描绘出边界。 Meta 的「分割一切」再上新? 9 月 12 日,一篇匿名论文「SAM 3: SEGMENT ANYTHING WITH CONCEPTS」登陆 ICLR 2026,引发网友广泛关注。
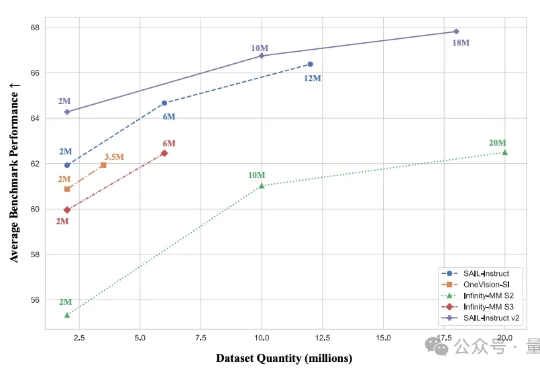
2B模型在多个基准位列4B参数以下开源第一。 抖音SAIL团队与LV-NUS Lab联合推出的多模态大模型SAIL-VL2。
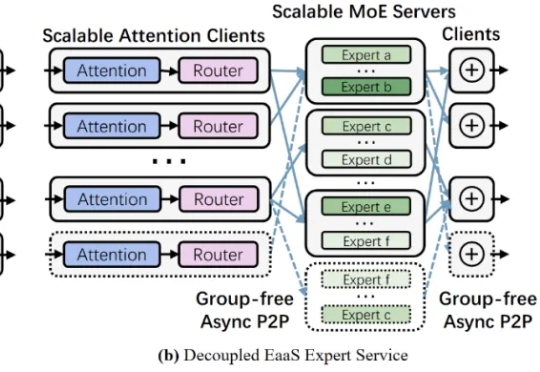
近年来,大型语言模型的参数规模屡创新高,随之而来的推理开销也呈指数级增长。如何降低超大模型的推理成本,成为业界关注的焦点之一。Mixture-of-Experts (MoE,混合专家) 架构通过引入大量 “专家” 子模型,让每个输入仅激活少数专家,从而在参数规模激增的同时避免推理计算量同比增长。
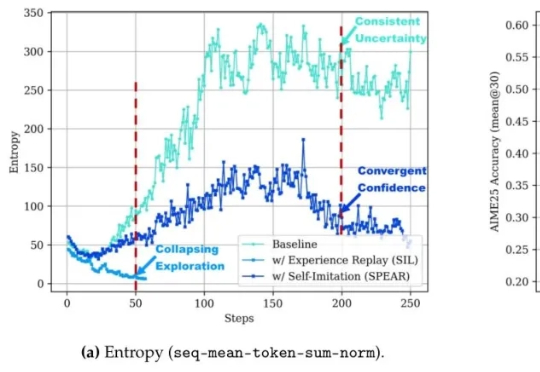
让智能体自己摸索新方法,还模仿自己的成功经验。腾讯优图实验室开源强化学习算法——SPEAR(Self-imitation with Progressive Exploration for Agentic Reinforcement Learning)。