AI资讯新闻榜单内容搜索-o

AITNT-国内领先的一站式人工智能新闻资讯网站
# 热门搜索 #
搜索: o
韩国医学影像AI第一股,高调牵手微软!曾斥资13亿收购竞争对手!

韩国医学影像AI第一股,高调牵手微软!曾斥资13亿收购竞争对手!

韩国医学影像AI第一股,高调牵手微软!曾斥资13亿收购竞争对手!

7月2日,韩国专注于AI癌症诊断和治疗的企业Lunit宣布与Microsoft达成合作,加速提供人工智能驱动的医疗保健解决方案。

来自主题: AI资讯
9795 点击    2025-07-05 13:37
「AI伴侣」开测,「AI好友」融资,边缘化的陪伴赛道迎来转机?

「AI伴侣」开测,「AI好友」融资,边缘化的陪伴赛道迎来转机?

「AI伴侣」开测,「AI好友」融资,边缘化的陪伴赛道迎来转机?

AI 社交,尤其是 AI 角色扮演方向,最近势头不太好,产品停止投入、流量下降等消息不少。但另一个细分方向,一直处于边缘位置的 AI 陪伴产品,在有点颓的市场环境中,正在默默发力。
来自主题: AI资讯
9702 点击    2025-07-05 13:28
新天终启,万象智生——万年奇点时刻,谁将引爆中国ASI?

新天终启,万象智生——万年奇点时刻,谁将引爆中国ASI?

新天终启,万象智生——万年奇点时刻,谁将引爆中国ASI?

2025年,AI界风云激荡,DeepSeek-R1横空出世、英伟达市值称霸全球、谷歌AlphaEvolve打破数学神话,中国Qwen3登顶开源王座……智能爆炸的奇点已悄然降临!新智元十周年之际,2025 AI Era & ASI创新大奖报名正式启动,致敬重塑世界的AI先锋!
来自主题: AI资讯
9252 点击    2025-07-05 13:20
vivo突破手机AI部署难题,绕开MoE架构限制,骁龙8 Elite流畅运行|ICCV 2025

vivo突破手机AI部署难题,绕开MoE架构限制,骁龙8 Elite流畅运行|ICCV 2025

vivo突破手机AI部署难题,绕开MoE架构限制,骁龙8 Elite流畅运行|ICCV 2025

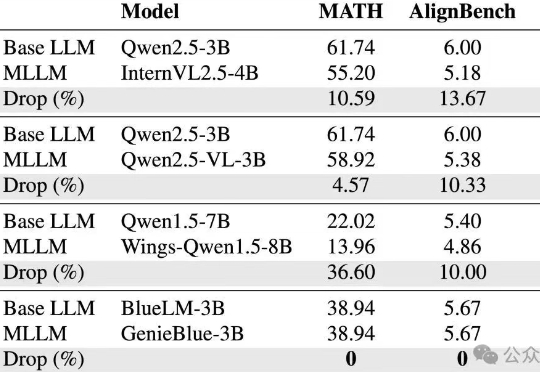
vivo AI研究院联合港中文以及上交团队为了攻克这些难题,从训练数据和模型结构两方面,系统性地分析了如何在MLLM训练中维持纯语言能力,并基于此提出了GenieBlue——专为移动端手机NPU设计的高效MLLM结构方案。
来自主题: AI技术研报
9774 点击    2025-07-05 13:12
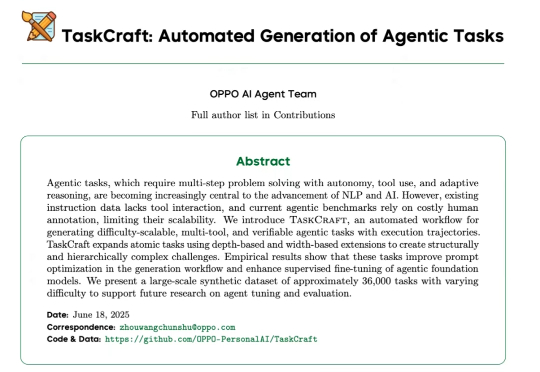
Agent RL和智能体自我进化的关键一步: TaskCraft实现复杂智能体任务的自动生成

Agent RL和智能体自我进化的关键一步: TaskCraft实现复杂智能体任务的自动生成

Agent RL和智能体自我进化的关键一步: TaskCraft实现复杂智能体任务的自动生成

近年来,基于智能体的强化学习(Agent + RL)与智能体优化(Agent Optimization)在学术界引发了广泛关注。然而,实现具备工具调用能力的端到端智能体训练,首要瓶颈在于高质量任务数据的极度稀缺。
来自主题: AI技术研报
9427 点击    2025-07-05 12:46
差点被Ilya摁掉,胎死腹中!ChatGPT爆红内幕首次公开

差点被Ilya摁掉,胎死腹中!ChatGPT爆红内幕首次公开

差点被Ilya摁掉,胎死腹中!ChatGPT爆红内幕首次公开

从「与GPT-3.5畅聊」到「ChatGPT」,OpenAI团队如何在混乱中拍板上线、又怎样被用户「点赞」调教成「赛博舔狗」?从产品发布、命名内幕、团队文化到AI时代核心竞争力,深度访谈揭开幕后全过程!
来自主题: AI资讯
8964 点击    2025-07-05 12:40
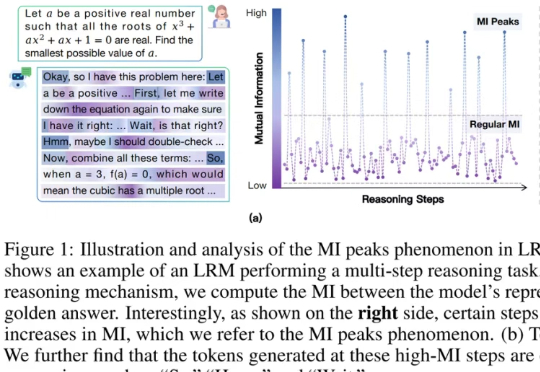
重磅发现!大模型的「aha moment」不是装腔作势,内部信息量暴增数倍!

重磅发现!大模型的「aha moment」不是装腔作势,内部信息量暴增数倍!

重磅发现!大模型的「aha moment」不是装腔作势,内部信息量暴增数倍!

你肯定见过大模型在解题时「装模作样」地输出:「Hmm…」、「Wait, let me think」、「Therefore…」这些看似「人类化」的思考词。
来自主题: AI技术研报
8182 点击    2025-07-05 12:33
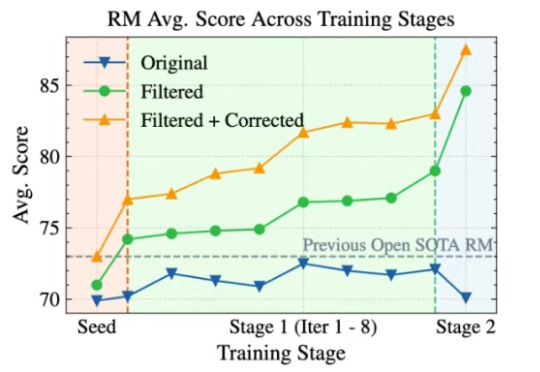
人机协同筛出2600万条数据,七项基准全部SOTA,昆仑万维开源奖励模型再迎新突破

人机协同筛出2600万条数据,七项基准全部SOTA,昆仑万维开源奖励模型再迎新突破

人机协同筛出2600万条数据,七项基准全部SOTA,昆仑万维开源奖励模型再迎新突破

大语言模型(LLM)以生成能力强而著称,但如何能让它「听话」,是一门很深的学问。 基于人类反馈的强化学习(RLHF)就是用来解决这个问题的,其中的奖励模型 (Reward Model, RM)扮演着重要的裁判作用,它专门负责给 LLM 生成的内容打分,告诉模型什么是好,什么是不好,可以保证大模型的「三观」正确。
来自主题: AI技术研报
10028 点击    2025-07-05 12:10
刚刚,Grok4跑分曝光:「人类最后考试」拿下45%,是Gemini 2.5两倍,但网友不信

刚刚,Grok4跑分曝光:「人类最后考试」拿下45%,是Gemini 2.5两倍,但网友不信

刚刚,Grok4跑分曝光:「人类最后考试」拿下45%,是Gemini 2.5两倍,但网友不信

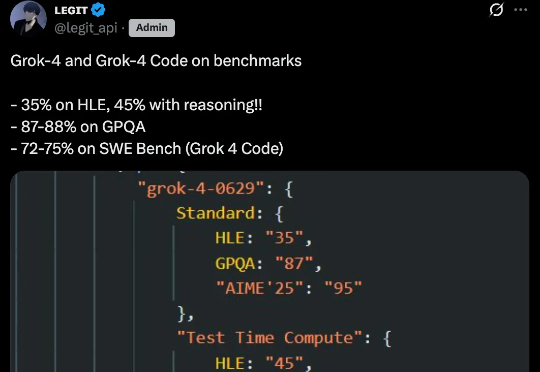
刚刚,Grok 4 和 Grok 4 Code 的基准测试结果疑似泄露。X 博主 @legit_api 发帖称,Grok 4 在 HLE(Humanities Last Exam,人类最后考试)上的标准得分是 35%,使用推理技术后提高到 45%;在 GPQA 上的得分是 87-88%;而Grok 4 Code 在 SWE Bench 上的得分则达到 72-75%。

来自主题: AI资讯
11678 点击    2025-07-05 11:38
不学美国砸钱烧AI,欧洲科技巨头另辟蹊径

不学美国砸钱烧AI,欧洲科技巨头另辟蹊径

不学美国砸钱烧AI,欧洲科技巨头另辟蹊径

欧洲科技巨头的CEO最新表示,欧洲在人工智能领域展开竞争时并不需要大量建立数据中心,这一说法与上月黄仁勋访欧时提出的说法相悖。当地时间周四(7月3日),德国思爱普公司(SAP)首席执行官柯睿安(Christian Klein)在接受采访时说道:“我们真的需要建五个数据中心再把高性能芯片放进去吗?”

来自主题: AI资讯
10041 点击    2025-07-05 11:33