野生DeepSeek火了,速度碾压官方版,权重开源
野生DeepSeek火了,速度碾压官方版,权重开源没等来 DeepSeek 官方的 R2,却迎来了一个速度更快、性能不弱于 R1 的「野生」变体!这两天,一个名为「DeepSeek R1T2」的模型火了!这个模型的速度比 R1-0528 快 200%,比 R1 快 20%。除了速度上的显著优势,它在 GPQA Diamond(专家级推理能力问答基准)和 AIME 24(数学推理基准)上的表现均优于 R1,但未达到 R1-0528 的水平。
搜索
没等来 DeepSeek 官方的 R2,却迎来了一个速度更快、性能不弱于 R1 的「野生」变体!这两天,一个名为「DeepSeek R1T2」的模型火了!这个模型的速度比 R1-0528 快 200%,比 R1 快 20%。除了速度上的显著优势,它在 GPQA Diamond(专家级推理能力问答基准)和 AIME 24(数学推理基准)上的表现均优于 R1,但未达到 R1-0528 的水平。
人设外包,孤单变现
当全球目光都聚焦在OpenAI、Anthropic、谷歌、Meta等明星AI公司时,真正靠大模型落地大规模盈利的,却是一家相对不太知名的公司——Palantir。
图灵奖大佬向97年小孩哥汇报,这是什么魔幻剧情?小扎砸143亿请来的「数据标注少年」,已荣升Meta首席AI官。一边是小扎上亿美元年薪offer引进新员工,另一边是Meta老将GPU告急不得不熬夜借卡差点头秃。网友们痛呼:太为Meta FAIR的员工难过了……
第一难当。AI变革遇上IPO盛宴,港股掀起一波资本巨浪。
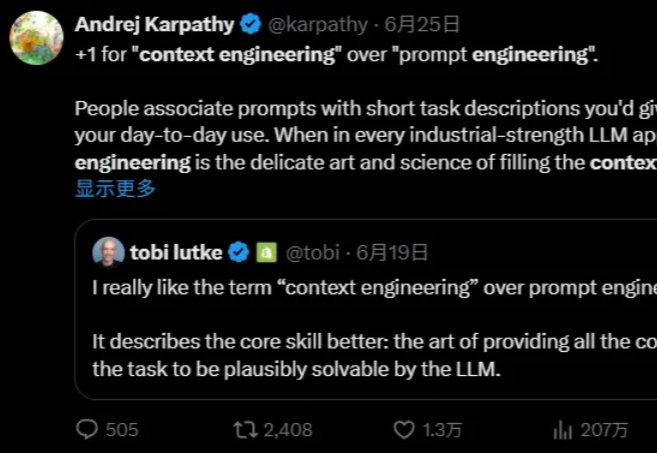
最近「上下文工程」有多火?Andrej Karpathy 为其打 Call,Phil Schmid 介绍上下文工程的文章成为 Hacker News 榜首,还登上了知乎热搜榜。
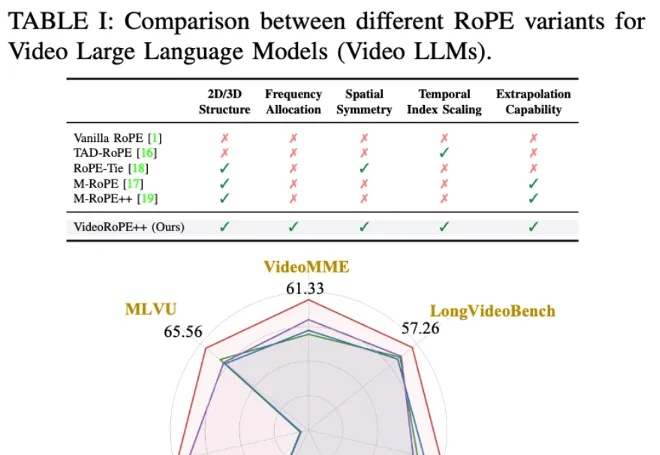
虽然旋转位置编码(RoPE)及其变体因其长上下文处理能力而被广泛采用,但将一维 RoPE 扩展到具有复杂时空结构的视频领域仍然是一个悬而未决的挑战。
当整个人工智能行业都在为「如何给程序员打造更快的马」而疯狂投入时,一支特立独行的团队选择「直接去造汽车」。
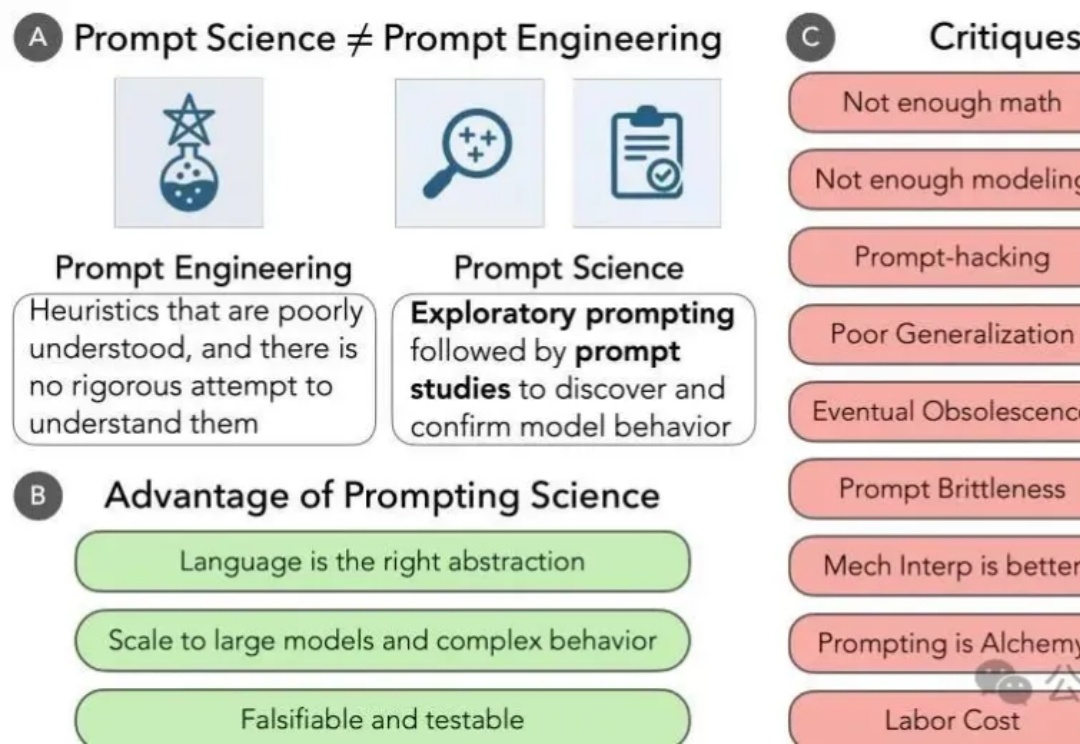
最近网上出现了一些很有趣的声音——"提示词已死"、"写提示词把自己写死了",这些文章认为随着模型变得越来越智能,精心设计提示词的时代已经过去了。但芝加哥大学的最新研究却给出了完全相反的结论:prompt不仅没有死,反而是理解大模型最重要的科学工具。
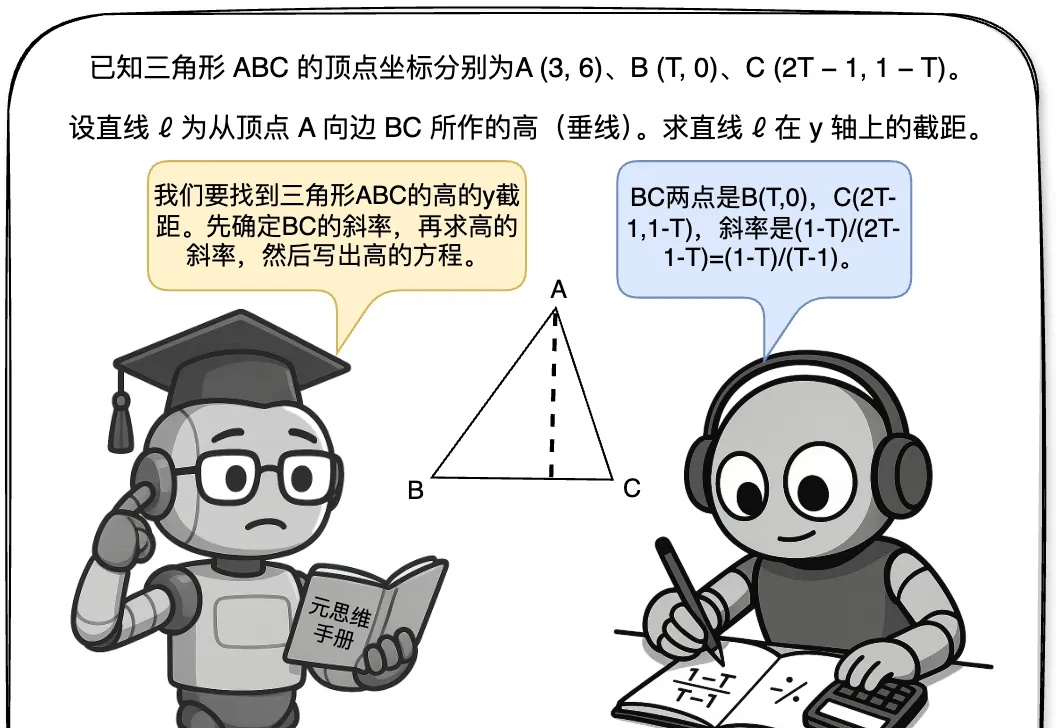
最近,关于大模型推理的测试时间扩展(Test time scaling law )的探索不断涌现出新的范式,包括① 结构化搜索结(如 MCTS),② 过程奖励模型(Process Reward Model )+ PPO,③ 可验证奖励 (Verifiable Reward)+ GRPO(DeepSeek R1)。