妈妈再也不用担心延迟了!斯坦福手搓Llama超级内核,推理仅需0.00068秒
妈妈再也不用担心延迟了!斯坦福手搓Llama超级内核,推理仅需0.00068秒斯坦福Hazy实验室推出新一代低延迟推理引擎「Megakernel」,将Llama-1B模型前向传播完整融合进单一GPU内核,实现推理时间低于1毫秒。在B200上每次推理仅需680微秒,比vLLM快3.5倍。
来自主题: AI技术研报
10839 点击 2025-05-30 12:36

 搜索
斯坦福Hazy实验室推出新一代低延迟推理引擎「Megakernel」,将Llama-1B模型前向传播完整融合进单一GPU内核,实现推理时间低于1毫秒。在B200上每次推理仅需680微秒,比vLLM快3.5倍。

用AI来升级浏览器的使用体验,对于厂商来说稳赚不赔。
近日,NVIDIA 联合香港大学、MIT 等机构重磅推出 Fast-dLLM,以无需训练的即插即用加速方案,实现了推理速度的突破!通过创新的技术组合,在不依赖重新训练模型的前提下,该工作为扩散模型的推理加速带来了突破性进展。本文将结合具体技术细节与实验数据,解析其核心优势。

在人工智能技术风起云涌的当下,量化投资行业正迎来新一轮深刻变革。

七万年前,智能人凭借虚构故事的能力完成了第一次认知革命。 一万年前,农业革命让我们从狩猎采集者变成了农民。 三百年前,科学革命让我们成为了地球的主宰。 而今天,我们正站在第三次认知革命的门槛上——这次,讲故事的不再只是人类。
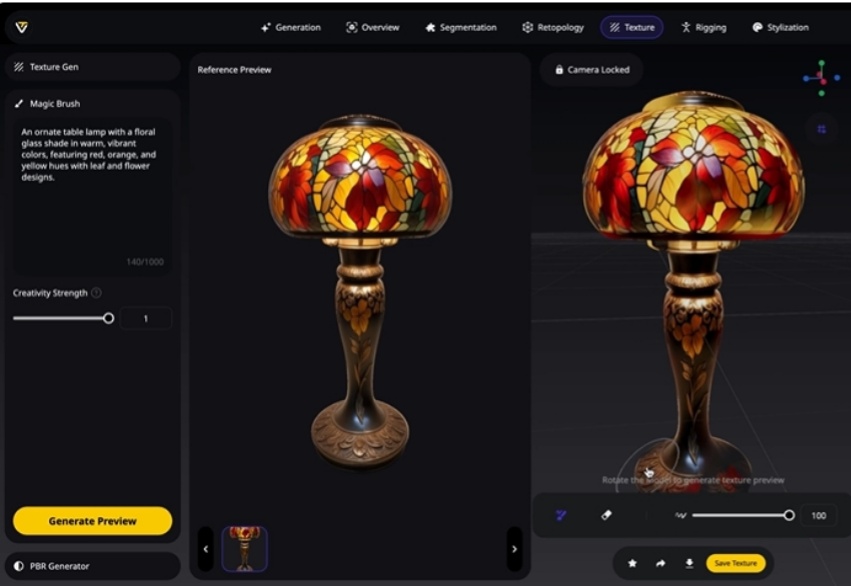
AI建模界的“作弊神器”真的来了!

关注我的人可能知道,我在得到开了一个专栏——《快刀广播站》。为了写专栏,我每周大概会试用体验不下几十款国内外的AI产品。
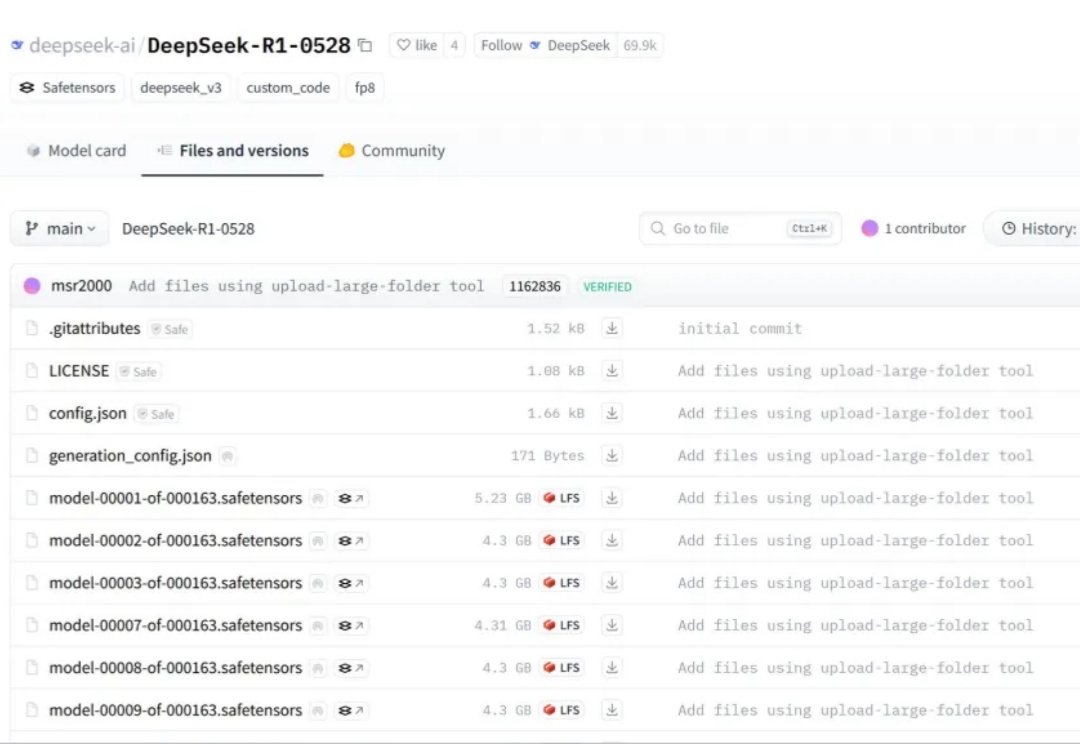
DeepSeek 猝不及防地更新了,不是 R2,而是 R1 v2。
“今天的寒门,是不懂AI的家庭”,这个观点一落入眼帘,就抓住了海淀妈妈郑瑞虹的注意。
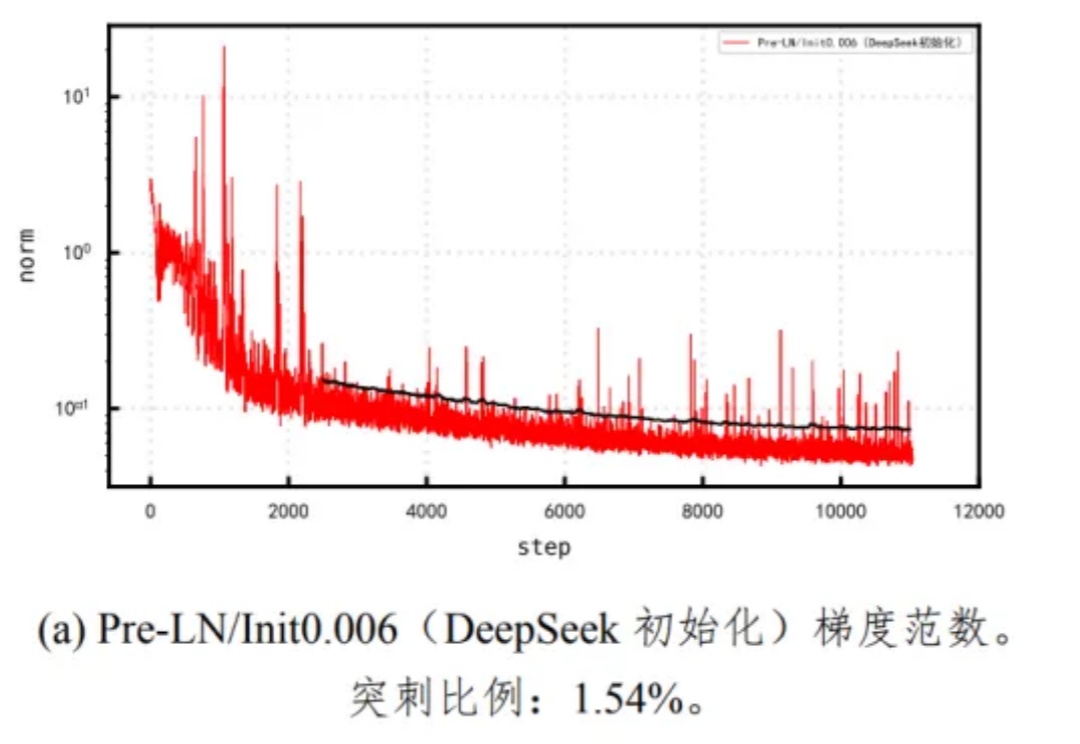
Pangu Ultra MoE 是一个全流程在昇腾 NPU 上训练的准万亿 MoE 模型,此前发布了英文技术报告[1]。最近华为盘古团队发布了 Pangu Ultra MoE 模型架构与训练方法的中文技术报告,进一步披露了这个模型的细节。